
Świt fotonicznych superkomputerów: Jak TSMC COUPE i Intel OCI likwidują miedziane wąskie gardło 1.6T w klastrach frontier AI za pomocą zintegrowanej optyki CPO
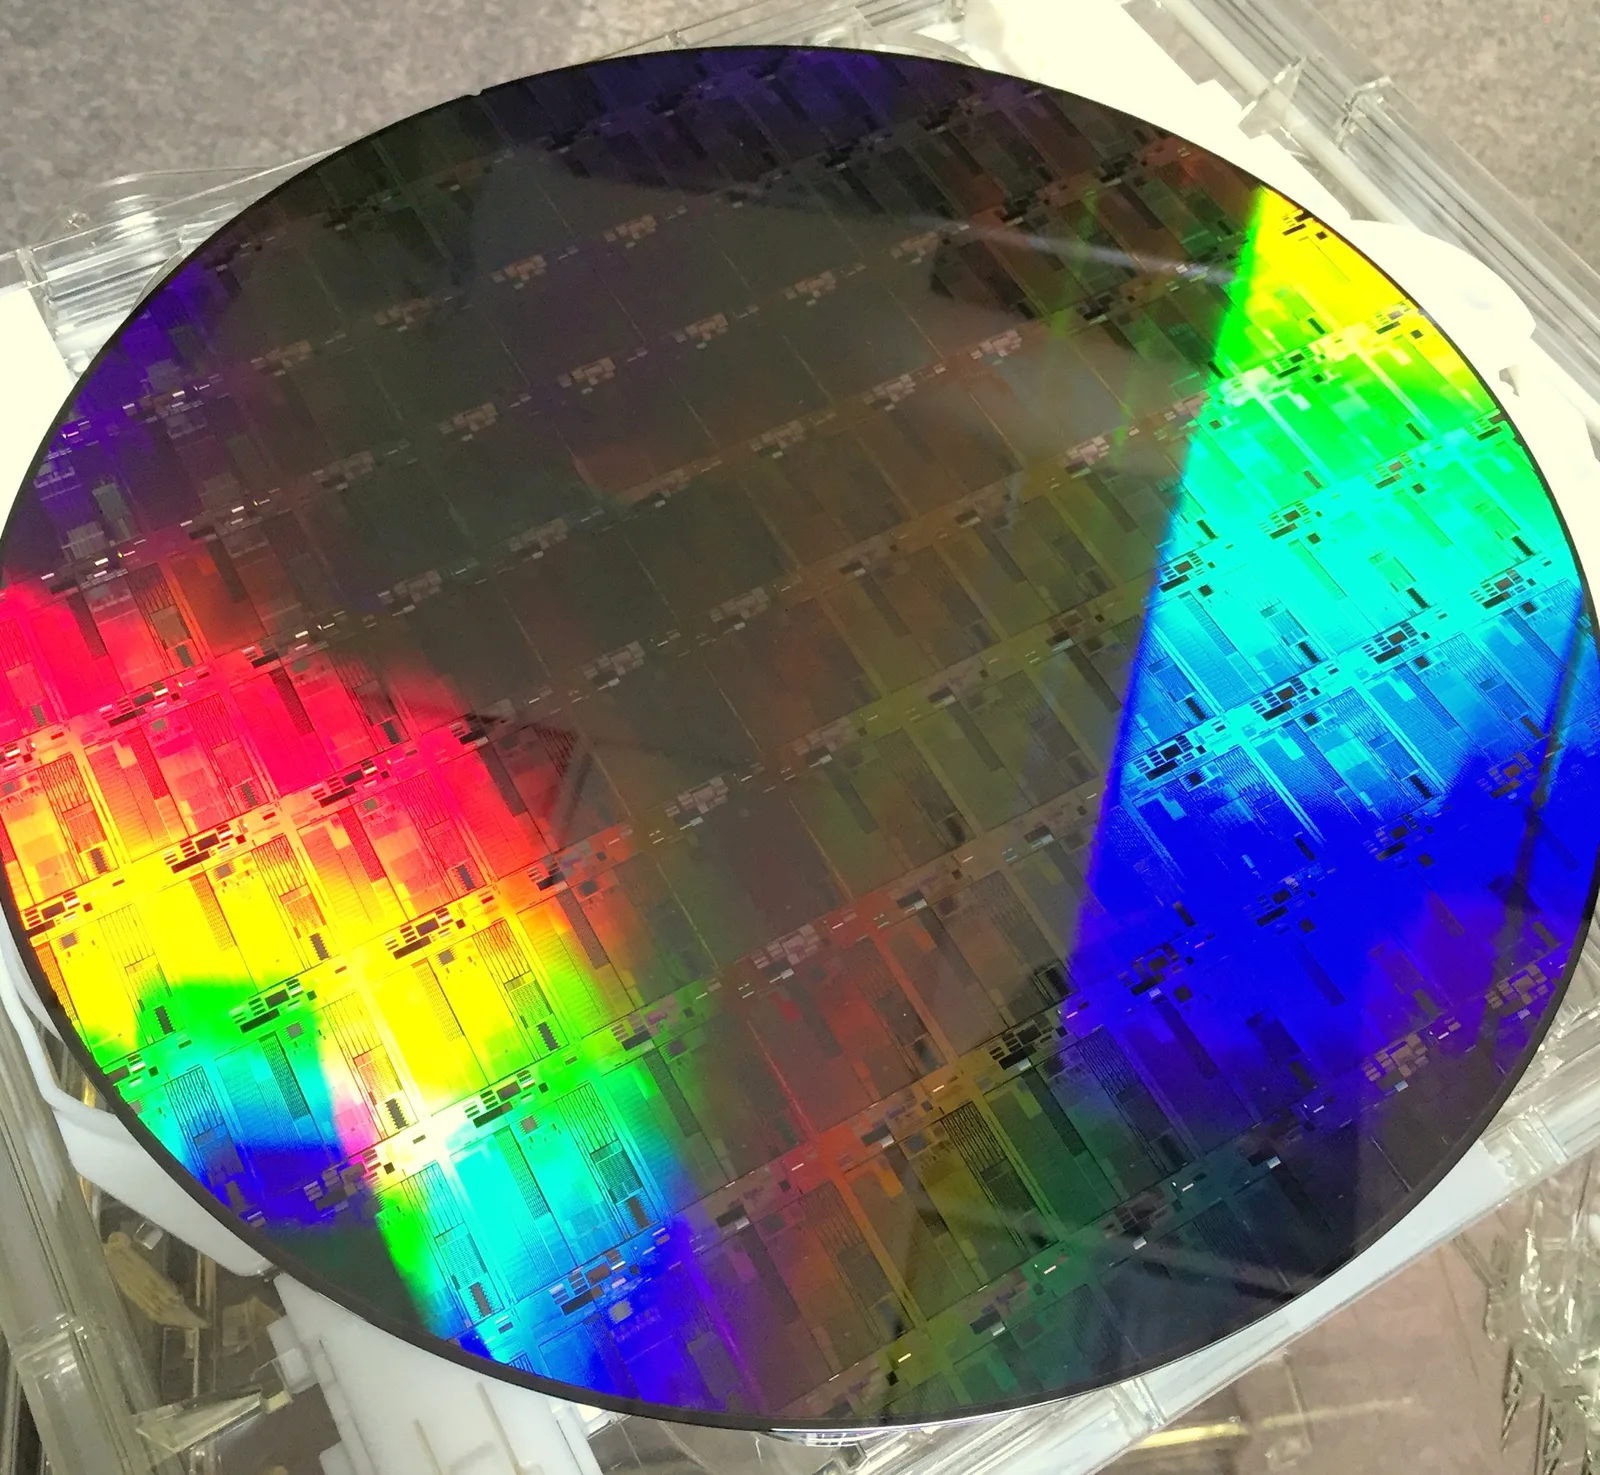
Współczesny przemysł sztucznej inteligencji znalazł się w punkcie zwrotnym, w którym dalsze skalowanie mocy obliczeniowej przestało być wyłącznie problemem litografii krzemowej, a stało się w równej mierze dramatyczną batalią o przepustowość sieciową i sprawność energetyczną połączeń międzysystemowych. Przez ostatnie trzy dekady rozwój architektury komputerowej opierał się na niewzruszonym aksjomacie, że sygnały elektryczne przesyłane miedzianymi ścieżkami na laminatach drukowanych oraz miedzianymi kablami typu Direct Attach Copper są najtańszym, najbardziej niezawodnym i technicznie wystarczającym medium transmisyjnym. Jednak w erze klastrów sztucznej inteligencji, w których setki tysięcy akceleratorów graficznych i wyspecjalizowanych procesorów tensorowych muszą wymieniać biliony parametrów w czasie liczonym w mikrosekundach, tradycyjna miedź dotarła do nieprzekraczalnej ściany termodynamicznej i elektromagnetycznej, wyznaczając kres dotychczasowych metod budowy superkomputerów.
Kluczowym problemem, który zdefiniował konieczność porzucenia tradycyjnych rozwiązań metalicznych, jest zjawisko naskórkowości oraz gwałtowny, nieliniowy wzrost tłumienia sygnałów wielkiej częstotliwości. Przy standardowych przepustowościach rzędu dwustu gigabitów na sekundę na pojedynczą linię transmisyjną w architekturach 224G SerDes, miedziana ścieżka o długości zaledwie kilkunastu centymetrów pochłania sygnał w stopniu uniemożliwiającym jego bezbłędną detekcję bez zastosowania skrajnie agresywnych, prądożernych układów korekcji DSP i analogowych wzmacniaczy sygnałowych. W szafach serwerowych nowej generacji o sumarycznej przepustowości przełączników sieciowych rzędu stu dwudziestu ośmiu terabitów na sekundę, tradycyjne podejście oznaczałoby, że nawet trzydzieści do czterdziestu procent całkowitej energii pobieranej przez szafę byłoby bezpowrotnie marnowane wyłącznie na przepychanie elektronów przez kable transmisyjne i ich rekonfigurację na wejściach układów scalonych.
Fizyczna ściana miedzi i kryzys integralności sygnału 224G
Przejście na modulację PAM4 o prędkości dwustu dwudziestu czterech gigabitów na sekundę na pasmo zdemaskowało elementarne ograniczenia metalicznych nośników sygnału. W klasycznej komunikacji cyfrowej sygnał prostokątny o wysokiej częstotliwości ulega silnej dyspersji i tłumieniu zależnemu od częstotliwości. Straty wtrąceniowe w standardowych laminatach organicznych przekraczają obecnie dwa decybele na każdy cal długości ścieżki przy częstotliwościach Nyquista rzędu dwudziestu ośmiu gigaherców. Oznacza to, że sygnał opuszczający procesor po przebyciu drogi zaledwie dziesięciu cali do gniazda optycznego na panelu czołowym przełącznika traci ponad dziewięćdziesiąt dziewięć procent swojej energii pierwotnej.
Aby skompensować tak gigantyczne straty transmisyjne, inżynierowie systemów cyfrowych musieli implementować skomplikowane procesory sygnałowe DSP oparte na zaawansowanych algorytmach Continuous Time Linear Equalization oraz wielostopniowych korektorach Decision Feedback Equalization. Każdy taki układ scalony dodaje opóźnienia rzędu kilkudziesięciu nanosekund oraz generuje gigantyczne ilości ciepła odpadowego, które musi zostać odprowadzone z wąskiej przestrzeni obudowy. W klastrach szkoleniowych dla modeli bazowych, gdzie algorytmy AllReduce i All-to-All wymagają bezwzględnej synchronizacji pomiędzy węzłami, narzut opóźnień staje się bezpośrednią przyczyną dławienia wydajności samych rdzeni obliczeniowych. Akceleratory spędzają coraz większy odsetek cykli zegarowych na bezproduktywnym oczekiwaniu na nadejście pakietów z sąsiednich serwerów.
Co więcej, zagęszczenie miedzianych wiązek kablowych na tylnych panelach szaf serwerowych osiągnęło masę krytyczną. Tradycyjne grube wiązki kabli miedzianych o przekroju AWG 24 lub AWG 26 nie tylko drastycznie blokują przepływ powietrza chłodzącego, ale ze względu na swoją wagę i minimalny promień gięcia wymagają potężnych ram nośnych i specjalistycznych systemów odciążających. W klastrach składających się z dziesiątek tysięcy procesorów fizyczna przestrzeń zajmowana przez okablowanie zaczęła rywalizować z przestrzenią przeznaczoną na same moduły obliczeniowe, co z punktu widzenia urbanistyki centrum danych jest sytuacją całkowicie nie do zaakceptowania.
Architektura Co-Packaged Optics i ekosystem TSMC COUPE
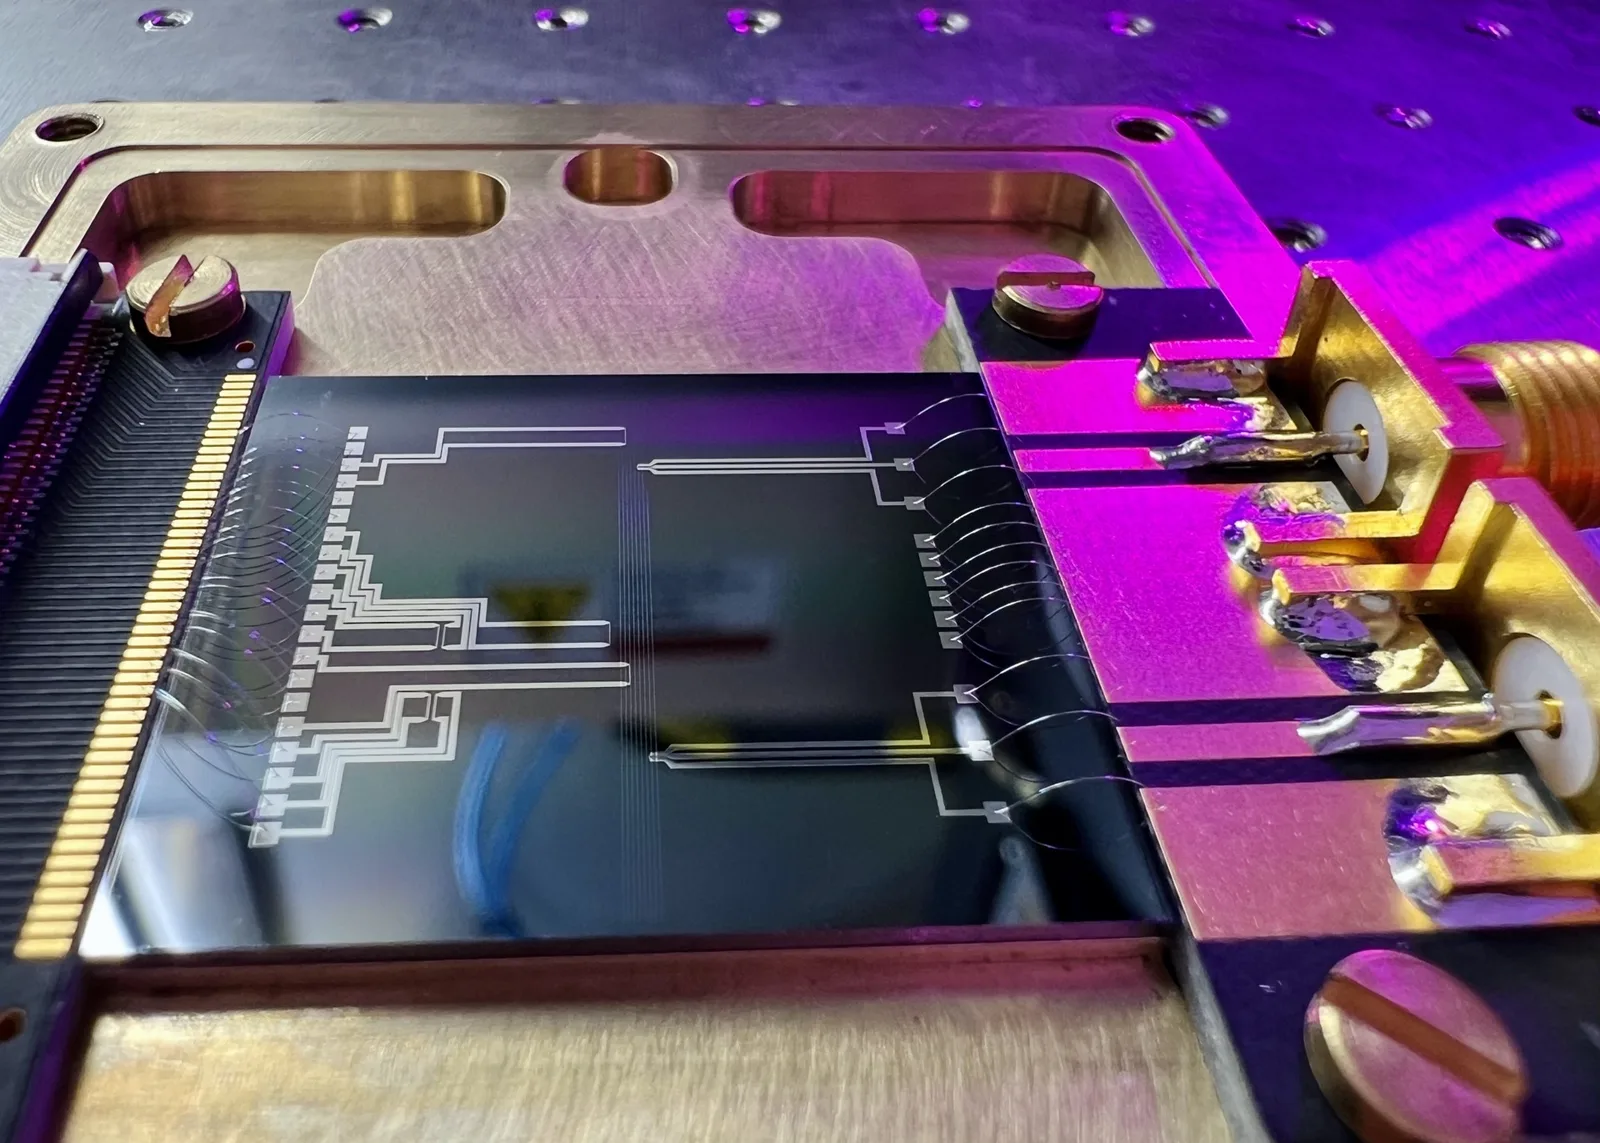
Odpowiedzią na ten narastający impas technologiczny jest koncepcja Co-Packaged Optics, czyli optyki współpakowanej, która polega na przeniesieniu przetworników elektrooptycznych bezpośrednio do obudowy procesora lub przełącznika sieciowego. Zamiast prowadzić linie elektryczne przez laminat płyty głównej do zewnętrznych modułów wtykanych typu QSFP-DD lub OSFP na krawędzi obudowy, sygnał elektryczny pokonuje dystans zaledwie kilku milimetrów na krzemowym interposerze, gdzie trafia natychmiast do zintegrowanego silnika fotonicznego zamieniającego bity na impulsy światła laserowego o określonej długości fali.
Liderem tego paradygmatu stał się tajwański gigant TSMC, wprowadzając na rynek platformę technologiczną COUPE, czyli Compact Optical Engine. Rozwiązanie to stanowi szczytowe osiągnięcie zaawansowanego pakowania układów scalonych, łącząc fotoniczny układ scalony PIC wykonany w wyspecjalizowanym procesie krzemowym z elektronicznym układem sterującym EIC za pomocą bezpośrednich mikropolaczeń miedzianych w technologii SoIC, czyli System-on-Integrated-Chips. Dzięki eliminacji tradycyjnych kulek lutowniczych BGA i drastycznemu zmniejszeniu pojemności pasożytniczej połączeń do wartości rzędu femtofaradów, interfejs COUPE osiąga niespotykaną dotąd sprawność energetyczną poniżej jednego pikodżula na przesłany bit.
W architekturze TSMC COUPE fotoniczny die jest układany bezpośrednio na podłożu krzemowym lub integrowany w strukturze CoWoS obok potężnych procesorów obliczeniowych i stosów pamięci HBM trzeciej i czwartej generacji. Światłowody są wprowadzane bezpośrednio do obudowy za pomocą precyzyjnych macierzy mikrosoczewek i złączy wielowłóknowych MPO o wysokiej gęstości upakowania. Oznacza to, że z obudowy pojedynczego procesora AI nie wychodzą już setki miedzianych pinów transmisyjnych podatnych na zakłócenia, lecz wiązki ultracienkich włókien szklanych zdolnych do przesyłania terabitów danych na odległości setek metrów bez zauważalnego tłumienia i bez jakichkolwiek strat wtrąceniowych typowych dla metali.
Wdrożenie COUPE w procesach komercyjnych wymagało od TSMC pokonania gigantycznych barier technologicznych związanych z kompatybilnością materiałową. Krzem w swojej czystej postaci jest materiałem o pośredniej przerwie energetycznej, co uniemożliwia bezpośrednią i wydajną emisję fotonów pod wpływem prądu elektrycznego. Z tego względu TSMC zdecydowało się na architekturę rozdzieloną, w której krzem służy jako doskonały, bezstratny ośrodek do prowadzenia falowodów, interferometrów i filtrów interferencyjnych, natomiast samo źródło światła opiera się na zewnętrznych modułach laserowych zasilających układ za pomocą dedykowanych włókien optycznych.
Strategia Intela i rewolucja Optical Compute Interconnect
Podczas gdy TSMC koncentruje się na otwartym modelu odlewniczym dla czołowych projektantów układów scalonych na świecie, Intel zaprezentował własną, radykalną i wysoce autonomiczną wizję optycznej łączności w postaci technologii Optical Compute Interconnect. Kluczową przewagą technologiczną Intela w tym obszarze jest opanowana przez ponad dwie dekady systematycznych badań umiejętność bezpośredniej integracji laserów na bazie fosforku indu z kryształem krzemu za pomocą zaawansowanego łączenia molekularnego na poziomie wafla półprzewodnikowego. Tradycyjne rozwiązania krzemowej fotoniki wymagają zewnętrznego źródła światła, co komplikuje konstrukcję szaf serwerowych i wprowadza straty na złączach optycznych.
Moduł Intel OCI integruje na pojedynczym chipie laser hybrydowy InP-on-Si, układ modulatorów optycznych, czułe odbiorniki fotonowe oraz niskomocowy obwód sterujący wykonany w klasycznym procesie CMOS. W pierwszych wersjach demonstracyjnych zaprezentowanych przez laboratorium Intel Labs układ ten oferuje dwukierunkową przepustowość na poziomie czterech terabitów na sekundę przy wykorzystaniu sześćdziesięciu czterech kanałów transmisyjnych pracujących z prędkością trzydziestu dwóch gigabitów na sekundę w standardzie Dense Wavelength Division Multiplexing. Całość zużywa poniżej pięciu pikodżuli na bit, co w porównaniu z klasycznymi transceiverami optycznymi stanowi redukcję zapotrzebowania na energię elektryczną o ponad sześćdziesiąt procent.
Zastosowanie OCI w procesorach serwerowych serii Xeon oraz dedykowanych akceleratorach AI otwiera drogę do całkowitej dezagregacji zasobów pamięciowych w nowoczesnych centrach danych. Dzięki temu, że opóźnienie wprowadzone przez optyczny tor transmisyjny OCI wynosi zaledwie około dziesięciu nanosekund na metr włókna światłowodowego, procesor znajdujący się w jednej szafie serwerowej może odpytywać pule pamięci CXL ulokowane w zupełnie innej szafie oddalonej o kilkadziesiąt metrów z taką samą latencją i przepustowością, jakby znajdowały się na tej samej płycie głównej. Prowadzi to do powstania architektury pamięci współdzielonej o skali dotychczas niewyobrażalnej w konwencjonalnych klastrach miedzianych.
Intel udowodnił ponadto, że jego zintegrowany silnik OCI jest w stanie pracować bezawaryjnie w trudnych warunkach środowiskowych wewnątrz serwera, gdzie temperatura w pobliżu procesora przekracza często osiemdziesiąt stopni Celsjusza. Osiągnięto to dzięki zaawansowanej konstrukcji mikrownęk laserowych z wielokrotnymi studniami kwantowymi, które zachowują wysoką sprawność kwantową nawet przy podwyższonych temperaturach pracy złącza półprzewodnikowego.
Fizyka modulatorów: Wybór między rezonatorami pierścieniowymi a cienkowarstwowym niobianem litu
W sercu każdego zintegrowanego silnika optycznego znajduje się modulator elektrooptyczny, którego zadaniem jest modulacja ciągłej fali światła laserowego strumieniem bitów pochodzących z rdzeni obliczeniowych. W inżynierii krzemowej fotoniki ukształtowały się dwa główne nurty projektowe, z których każdy reprezentuje odmienny zestaw kompromisów technicznych i fizycznych. Pierwszym z nich są rezonatory mikropierścieniowe, czyli Micro-Ring Resonators, charakteryzujące się miniaturowymi wymiarami rzędu kilkunastu mikrometrów średnicy i znikomym poborem energii.
Zasada działania rezonatora pierścieniowego opiera się na interferencji konstruktywnej fali świetlnej krążącej w pierścieniu falowodowym umieszczonym w bezpośredniej bliskości falowodu przelotowego. Wstrzykiwanie nośników ładunku do obszaru pierścienia zmienia efektywny współczynnik załamania światła poprzez efekt dyspersji plazmowej, co przesuwa częstotliwość rezonansową i moduluje natężenie światła na wyjściu. Niestety, rezonatory te charakteryzują się niezwykle wąskim pasmem optycznym, co czyni je skrajnie wrażliwymi na wahania temperatury otoczenia. Zmiana temperatury o ułamek stopnia Celsjusza powoduje rozstrojenie rezonansu, wymagając stosowania zintegrowanych mikrogrzałek kompensacyjnych, które niwelują część zysków energetycznych.
Drugim podejściem, zyskującym ogromne uznanie w najbardziej wymagających aplikacjach telekomunikacyjnych i klastrach AI, jest wykorzystanie cienkowarstwowego niobianu litu, czyli Thin-Film Lithium Niobate na podłożu krzemowym. Niobian litu jest materiałem ferroelektrycznym o potężnym współczynniku elektrooptycznym Pockelsa, co oznacza, że zmiana współczynnika załamania światła następuje pod wpływem pola elektrycznego niemal natychmiastowo i bez konieczności wstrzykiwania prądu elektrycznego. Modulatory Macha-Zehndera oparte na niobianie litu osiągają pasmo modulacji przekraczające sto gigaherców przy znikomych zniekształceniach nieliniowych i zerowym prądzie upływu, stanowiąc idealny fundament dla przyszłych łączy 448G i 896G.
Porównanie technologii transmisyjnych w klastrach obliczeniowych
Przejście na technologie fotoniki współpakowanej oznacza całkowite przetasowanie parametrów operacyjnych infrastruktury serwerowej. W poniższej tabeli zestawiono kluczowe parametry techniczne i fizyczne poszczególnych generacji połączeń stosowanych w wielkich klastrach AI.
| Technologia transmisyjna | Maksymalna prędkość na linię | Zasięg efektywny | Zużycie energii | Złożoność termiczna |
|---|---|---|---|---|
| Direct Attach Copper (DAC 112G) | 112 Gbps PAM4 | Do 2.0 metrów | 8-12 pJ/bit (z DSP) | Niska (pasywne kable) |
| Aktywne kable miedziane (ACC/AEC 224G) | 224 Gbps PAM4 | Do 1.5 metra | 14-18 pJ/bit (redrivery) | Wysoka na złączach |
| Klasyczne moduły optyczne (Pluggable OSFP 800G) | 112 Gbps PAM4 | Do 2000 metrów | 18-25 pJ/bit (pełne DSP) | Bardzo wysoka w module |
| TSMC COUPE CPO (1.6T – 3.2T) | 224 Gbps PAM4 | Do 500 metrów | 3-5 pJ/bit (współpakowane) | Zarządzana w chłodzeniu cieczą |
| Intel OCI (Direct Silicon Integration) | DWDM 64x 32/64 Gbps | Do 100 metrów | Poniżej 3.5 pJ/bit | Zintegrowany laser hybrydowy |
Wyzwania inżynieryjne: Dryf termiczny, metrologia i zjawiska optomechaniczne
Mimo niezaprzeczalnych korzyści fizycznych i architektonicznych, masowe wdrożenie optyki współpakowanej napotyka na bezprecedensowe wyzwania inżynieryjne, z którymi przemysł półprzewodnikowy nie miał dotąd do czynienia w tak masowej skali. Głównym wrogiem zintegrowanych systemów fotonicznych jest temperatura i jej wysoce dynamiczny, nierównomierny rozkład wewnątrz wielochipowej obudowy zaawansowanej. W nowoczesnych procesorach AI pobierających ponad tysiąc watów mocy, gwałtowne skoki obciążenia obliczeniowego podczas przejścia z fazy przetwarzania do fazy komunikacji powodują lokalne gradienty termiczne przekraczające pięćdziesiąt stopni Celsjusza w czasie liczonym w milisekundach.
W takich warunkach zintegrowane elementy optyczne ulegają nieustannym deformacjom termicznym. Zjawisko dryfu termooptycznego sprawia, że falowody krzemowe zmieniają swoje właściwości transmisyjne, a sprzęgacze siatkowe tracą optymalne dopasowanie kątowe do wiązki wprowadzanej ze światłowodu. Aby temu przeciwdziałać, projektanci układów muszą integrować skomplikowane pętle sprzężenia zwrotnego zarządzane przez dedykowane mikrokontrolery, które monitorują moc sygnału optycznego w czasie rzeczywistym i sterują zintegrowanymi elementami grzejnymi z precyzją do części tysięcznych wata.
Drugim fundamentalnym wyzwaniem jest kwestia niezawodności i testowalności na poziomie wafla. W klasycznej architekturze komputerowej uszkodzony moduł optyczny transceivera można w prosty sposób zdiagnozować, wyjąć z gniazda na panelu czołowym i zastąpić nowym elementem w trybie hot-plug bez wyłączania serwera. W przypadku Co-Packaged Optics awaria pojedynczego elementu optycznego uwięzionego pod radiatorem chłodzenia cieczą oznacza konieczność wymiany całej płyty bazowej lub skomplikowanego modułu wielochipowego wartego dziesiątki tysięcy dolarów. Z tego względu wskaźnik Laser Failure Rate musi zostać obniżony o co najmniej dwa rzędy wielkości w porównaniu ze standardowymi laserami telekomunikacyjnymi.
Procedury metrologiczne w fabrykach półprzewodników również musiały przejść bezprecedensową metamorfozę. Tradycyjne testery automatyczne ATE opierające się na igłowych kartach stykowych są całkowicie bezużyteczne w kontakcie z falowodami optycznymi. Opracowanie zautomatyzowanych stacji testowych wyposażonych w precyzyjne manipulatory heksapodalne o submikronowej dokładności pozycjonowania włókien pomiarowych stało się jednym z najbardziej strzeżonych sekretów technologicznych firm takich jak FormFactor czy Advantest. Testowanie wafli fotonicznych przed ich pocięciem na pojedyncze struktury jest jedyną metodą zapewnienia ekonomicznej opłacalności całego procesu produkcyjnego.
Precyzja montażu mechanicznego i złącza V-groove nowej generacji
Poza zagadnieniami czysto półprzewodnikowymi, wdrożenie CPO stawia gigantyczne wymagania przed inżynierią precyzyjną i montażem optomechanicznym. Połączenie pojedynczego modułu obliczeniowego z setkami włókien szklanych wymaga pozycjonowania każdego rdzenia światłowodowego o średnicy zaledwie dziewięciu mikrometrów względem zintegrowanego falowodu krzemowego z tolerancją nieprzekraczającą pół mikrometra. Jakiekolwiek przesunięcie mechaniczne wynikające z naprężeń termicznych lub wibracji wywołanych przepływem cieczy chłodzącej skutkuje natychmiastowym wzrostem tłumienia o kilka decybeli.
Aby sprostać temu zadaniu, laboratoria TSMC i instytuty badawcze opracowały zaawansowane matryce V-groove trawione anizotropowo w krystalicznym krzemie za pomocą wodorotlenku potasu KOH. Precyzyjne rowki w kształcie litery V pozwalają na mechaniczne zablokowanie pojedynczych włókien światłowodowych w idealnych odstępach z dokładnością poniżej stu nanometrów. Klejenie złączy odbywa się przy użyciu polimerów optycznych utwardzanych promieniowaniem ultrafioletowym o dopasowanym współczynniku załamania światła i zerowym współczynniku skurczu podczas polimeryzacji, co eliminuje ryzyko powstawania mikropęknięć w trakcie wieloletniej pracy pod obciążeniem termicznym.
Implikacje dla protokołów komunikacyjnych: PCIe Gen 7, UALink i Ultra Ethernet
Rewolucja w warstwie fizycznej wymusza równoczesną transformację w warstwie protokołów transmisyjnych. Przez lata standardy komunikacyjne, takie jak PCI Express, Ethernet czy InfiniBand, były projektowane z myślą o właściwościach medium miedzianego, uwzględniając wysokie stopy błędów bitowych, konieczność agresywnego kodowania korekcyjnego Forward Error Correction oraz skomplikowane mechanizmy retransmisji pakietów na poziomie łącza. Optyka współpakowana diametralnie zmienia reguły gry, oferując kanał transmisyjny o znacznie niższym poziomie szumów i praktycznie zerowych przesłuchach elektromagnetycznych.
W ramach nowo formowanych konsorcjów przemysłowych, takich jak Ultra Ethernet Consortium oraz konsorcjum Ultra Accelerator Link, trwają intensywne prace nad stworzeniem odchudzonych protokołów komunikacyjnych zoptymalizowanych pod kątem bezpośredniej transmisji fotonicznej. Dzięki drastycznemu obniżeniu stopy błędów możliwe staje się zredukowanie narzutu kodowania FEC, co pozwala zaoszczędzić kolejne cenne nanosekundy opóźnienia w krytycznych pętlach komunikacyjnych modeli językowych. Ponadto protokół UALink projektowany jako bezpośrednia alternatywa dla zamkniętego standardu NVLink zakłada natywną obsługę optycznych interkonektów CPO, co umożliwi łączenie ponad tysiąca akceleratorów w jednolitą przestrzeń adresową pamięci bez pośrednictwa tradycyjnych przełączników PCIe.
Z perspektywy standardu PCIe 7.0, który ma operować z zawrotną prędkością stu dwudziestu ośmiu gigatransferów na sekundę, Co-Packaged Optics przestaje być luksusem, a staje się jedyną fizyczną możliwością realizacji połączeń na dystansach większych niż kilka centymetrów. Płyty główne nowej generacji całkowicie zrezygnują ze skomplikowanych laminatów o niskiej stratności dielektrycznej Megtron na rzecz zintegrowanych matryc światłowodowych wtopionych bezpośrednio w strukturę nośną serwera.
Kierunek przyszłości: Obliczenia całkowicie fotoniczne i kognitywne silniki optyczne
Zwieńczeniem rewolucji zapoczątkowanej przez COUPE i OCI nie będzie jednak samo zastąpienie kabli miedzianych światłowodami, lecz bezpośrednia realizacja operacji matematycznych w domenie optycznej. W tradycyjnym procesorze tensorowym konwersja sygnału ze świata fotonów do elektronów następuje na każdym etapie przetwarzania, co generuje straty energetyczne. Prowadzone obecnie projekty badawcze nad optycznymi jednostkami tensorowymi zakładają wykonywanie operacji mnożenia macierzy przez wektor bezpośrednio na wiązkach światła za pomocą siatek interferometrów Macha-Zehndera.
W takim układzie światło reprezentujące wektor wejściowy przechodzi przez matrycę wag zakodowanych w postaci przesunięć fazowych na zintegrowanych falowodach. Obliczenia zachodzą z prędkością propagacji światła w krzemie przy niemal zerowym poborze energii na samą operację arytmetyczną. Gdy technologie pakowania 3D, takie jak TSMC SoIC, umożliwią bezproblemowe łączenie fotonicznych koprocesorów macierzowych z tradycyjnymi rdzeniami sterującymi CMOS, klastry sztucznej inteligencji osiągną kolejny skok wydajnościowy rzędu setek teraflopsów na wat, definitywnie zamykając epokę czysto elektronicznego przetwarzania informacji.
Ekonomia centrów danych i zmiana bilansu TCO
Przejście na optykę współpakowaną radykalnie przekształca wskaźniki Total Cost of Ownership wielkich operatorów chmurowych i wyspecjalizowanych laboratoriów badawczych zajmujących się sztuczną inteligencją. Chociaż początkowy koszt wdrożenia zaawansowanych obudów wielochipowych zintegrowanych z fotoniką jest wyższy niż w przypadku tradycyjnych serwerów bazujących na miedzi, oszczędności eksploatacyjne w skali kilkuletniego cyklu życia klastra obliczeniowego są bezdyskusyjne. Zmniejszenie zużycia energii w samej warstwie sieciowej o sześćdziesiąt procent przekłada się bezpośrednio na możliwość zasilenia większej liczby rdzeni obliczeniowych w ramach tego samego limitu przyłącza energetycznego obiektu.
W warunkach, w których dostępność mocy przyłączeniowej w megawatach stała się głównym czynnikiem hamującym rozbudowę centrów danych w Europie i Ameryce Północnej, każdy zaoszczędzony megawat w układach transmisyjnych oznacza bezpośrednią możliwość instalacji dodatkowych szaf z procesorami AI. Ponadto likwidacja tysięcy wentylatorów chłodzących panele czołowe z tradycyjnymi transceiverami pozwala na przejście na w pełni bezgłośne i wysoce wydajne chłodzenie cieczowe zanurzeniowe lub bezpośrednie chłodzenie cieczą na poziomie chipa, co dodatkowo obniża współczynnik Power Usage Effectiveness całego centrum danych do rekordowych wartości bliskich jedności.
W szerszej perspektywie geopolitycznej kontrola nad łańcuchem dostaw technologii fotoniki zintegrowanej staje się nowym, krytycznym filarem suwerenności technologicznej mocarstw. Zdolność do precyzyjnego osadzania struktur optycznych na waflach krzemowych, produkcja zaawansowanych laserów hybrydowych oraz automatyzacja montażu złączy światłowodowych decydują o tym, które państwa będą w stanie budować superkomputery zdolne do szkolenia kolejnych generacji modeli frontier. Miedź odegrała fundamentalną rolę w narodzinach ery cyfrowej, jednak zmierzch jej panowania w najgłębszych warstwach architektury obliczeniowej jest już faktem dokonanym, na którego czele stoją precyzyjne wiązki fotonów biegnące przez krzemowe matryce najpotężniejszych procesorów świata.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.