
Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Paradoks Moraveca i ucieleśnienie sztucznej inteligencji
W 1988 roku Hans Moravec sformułował spostrzeżenie, które przez kolejne trzydzieści pięć lat definiowało granice możliwości systemów automatyki i robotyki. Komputery bez trudu ogrywały arcymistrzów szachowych, rozwiązywały skomplikowane układy równań różniczkowych i analizowały miliony transakcji finansowych na giełdach w ułamkach sekund. Jednocześnie najpotężniejsze roboty przemysłowe potykały się na nierównym progu, nie potrafiły bezawaryjnie podnieść ze stołu zmiętej serwetki ani wkręcić żarówki o niestandardowym gwincie bez dedykowanego, sztywnego pozycjonera mechanicznego. Powód tego stanu rzeczy tkwił w ewolucyjnej naturze ludzkiej motoryki: za zmysł równowagi, koordynację wzrokowo-ruchową i adaptacyjny chwyt odpowiadają setki milionów lat biologicznej optymalizacji móżdżku i układu nerwowego, podczas gdy myślenie abstrakcyjne jest ewolucyjnym nabytkiem stosunkowo świeżym i algorytmicznie o wiele bardziej zwartym.
Tradycyjne podejście do sterowania manipulatorycznego opierało się na inżynierii jawnych modeli kinematycznych i dynamicznych. Każdy ruch ramienia robota był precyzyjnie kalkulowany za pomocą macierzy transformacji jednorodnych Denavita-Hartenberga, równań dynamiki Eulera-Lagrange'a oraz klasycznych pętli sprzężenia zwrotnego PID. Systemy te działały bezbłędnie w sterylnym, deterministycznym środowisku hal spawalniczych przemysłu motoryzacyjnego, gdzie każdy detal karoserii pojawia się w ściśle określonym punkcie przestrzeni roboczej z dokładnością do dziesiątych części milimetra. Jednakże próba przeniesienia takiego robota do środowiska niestrukturyzowanego, takiego jak magazyn e-commerce z chaotycznie rozmieszczonymi paczkami, kuchnia domowa czy plac budowy, kończyła się natychmiastowym paraliżem wykonawczym. Najmniejsza niepewność sensoryczna, zmiana kąta padania światła czy przypadkowa deformacja podnoszonego przedmiotu powodowała błędy śledzenia trajektorii i awaryjne zatrzymanie serwonapędów.
Przełom rozpoczął się wraz z nadejściem paradygmatu ucieleśnionej sztucznej inteligencji, w którym percepcja zmysłowa, wnioskowanie semantyczne i działanie wykonawcze przestały być rozdzielane na niezależne podsystemy. Zamiast budować sekwencyjny łańcuch przetwarzania, w którym moduł widzenia komputerowego dokonuje segmentacji obiektów, estymator pozy wylicza współrzędne kartezjańskie, a planista trajektorii generuje krzywe wielomianowe, inżynierowie zwrócili się ku sieciom neuronowym trenowanym w architekturze end-to-end. Prawdziwa eksplozja wydajności nastąpiła jednak dopiero wtedy, gdy połączono gigantyczne multimodalne modele transformatorowe z nową klasą generatywnych polityk behawioralnych opartych na procesach dyfuzji stochastycznej.
Architektury Vision-Language-Action: Połączenie semantyki z fizyką
Podstawowym problemem klasycznych dużych modeli językowych i multimodalnych była ich całkowita izolacja od fizycznej rzeczywistości. Choć systemy takie potrafiły wygenerować wyczerpujący esej o sposobie składania koszuli lub podać teoretyczny przepis na przygotowanie herbaty, nie miały najmniejszego pojęcia o wektorach sił, dynamicznych tarciach powierzchniowych, ograniczeniach momentu obrotowego na przegubach ani o tym, jak sekwencja komend prądowych przekłada się na ruch końcówki roboczej w przestrzeni sześciu stopni swobody. Przełomem koncepcyjnym stało się potraktowanie działań motorycznych jako kolejnego modalnego dialektu w architekturze transformatora, co dało początek rodzinie modeli określanych jako Vision-Language-Action.
W pionierskich architekturach, takich jak RT-1 oraz RT-2 opracowanych w laboratoriach Google DeepMind, przestrzeń akcji robota została poddana dyskretyzacji. Ciągłe wektory prędkości kartezjańskich końcówki roboczej, zmiany kątów orientacji w przestrzeni kątów Eulera oraz stan otwarcia chwytaka zostały skwantowane do postaci dyskretnych przedziałów numerycznych, które przypisano do zarezerwowanych tokenów w słowniku modelu językowego. W ten sposób sieć neuronowa mogła przyjmować na wejściu sekwencję klatek wideo z kamer pokładowych oraz polecenie tekstowe użytkownika, a następnie w ramach standardowego mechanizmu autoregresyjnego dekodować kolejne tokeny odpowiadające fizycznym mikroruchom ramienia. Model uczył się jednocześnie rozumieć semantykę polecenia, identyfikować wizualnie docelowe obiekty i wyznaczać kierunek ruchu w jednym, spójnym procesie uwagi krzyżowej.
Architektury VLA wykazały zdumiewające zdolności do transferu wiedzy semantycznej z gigantycznych zbiorów internetowych na poziom manipulacji fizycznej. Robot, który nigdy wcześniej nie widział zabawki w kształcie dinozaura, potrafił poprawnie zrealizować polecenie przeniesienia wymarłego gada do zielonego pudełka, ponieważ pojęcie dinozaura oraz asocjacja z wymarciem były głęboko zakodowane w wagach modelu językowego, podczas gdy moduł uwagi wizualnej bezbłędnie lokalizował cechy geometryczne zabawki. Okazało się jednak, że podejście czysto autoregresyjne oparte na tokenizacji dyskretnej natrafia na poważne ograniczenia w zadaniach wymagających wysokiej częstotliwości próbkowania, precyzyjnej dynamiki oraz radzenia sobie z rozkładami wielomodalnymi.
Rewolucja Diffusion Policy i sieci dopasowania przepływu
Największą słabością autoregresyjnych modeli VLA w bezpośrednim sterowaniu silnikami było zjawisko uśredniania rozkładów wielomodalnych. Jeśli podczas treningu demonstracyjnego człowiek teleoperujący robota omijał przeszkodę raz z lewej, a raz z prawej strony, klasyczna sieć neuronowa minimalizująca błąd średniokwadratowy starała się wygenerować trajektorię stanowiącą matematyczną średnią obu tych ścieżek, co prowadziło do kolizji bezpośrednio w centralny punkt przeszkody. Co więcej, manipulacja zręczna z użyciem dłoni wielopalczastych wymaga płynnego generowania skorelowanych w czasie wektorów sterowania o częstotliwości rzędu 50-100 Hz, podczas gdy ciężkie transformatory VLA o wagach rzędu miliardów parametrów są w stanie inferować z prędkością zaledwie kilku herców.
Odpowiedzią na ten dylemat stało się wprowadzenie do robotyki modeli dyfuzyjnych w postaci architektury Diffusion Policy oraz najnowszych sieci dopasowania przepływu Flow Matching. Zamiast przewidywać pojedynczy krok akcji w sposób deterministyczny, policyjna sieć dyfuzyjna traktuje sekwencję przyszłych działań motorycznych jako zaszumioną trajektorię w przestrzeni ciągłej. Proces inferencji polega na stopniowym usuwaniu szumu gaussowskiego za pomocą odwróconego równania stochastycznego różniczkowego, warunkowanego wektorem cech wizualnych i instrukcją językową. W ten sposób polityka dyfuzyjna jest w stanie bez trudu modelować skomplikowane, multimodalne rozkłady prawdopodobieństwa: sieć decyduje się na jeden z poprawnych wariantów ominięcia przeszkody, zachowując idealną spójność czasową całej trajektorii.
Kluczową innowacją techniczną okazało się generowanie całych horyzontów czasowych akcji, tak zwanego przewidywania horyzontalnego. W każdym cyklu pracy sterownika sieć generuje trajektorię obejmującą na przykład szesnaście kolejnych kroków czasowych w przyszłość, po czym robot wykonuje tylko pierwsze kilka kroków, zanim nie otrzyma nowej aktualizacji sensorycznej. Zapewnia to niezwykłą płynność ruchu, eliminuje drżenia serwonapędów i pozwala maszynie na dynamiczną adaptację do nagłych zakłóceń zewnętrznych, na przykład gdy popchnięty z zewnątrz przedmiot zmienia swoje położenie w trakcie wykonywania chwytu.
Architektury dwupoziomowe: Rozdział kory mózgowej od układu autonomicznego
Współczesny konsensus inżynieryjny w robotyce humanoidalnej doprowadził do ukształtowania się hierarchicznych architektur dwupoziomowych, które wiernie odzwierciedlają podział funkcji w biologicznym układzie nerwowym. Na poziomie nadrzędnym funkcjonuje powolny, ale dysponujący głęboką wiedzą o świecie model VLA, pełniący rolę kory nowej. Ten gigantyczny model przetwarza obrazy z kamer o wysokiej rozdzielczości, interpretuje abstrakcyjne cele zadania, prowadzi wewnętrzny dialog dekomponujący złożone misje na proste etapy i wyznacza cele podrzędne, na przykład zlokalizowanie odpowiedniego narzędzia i zbliżenie dłoni do jego rękojeści.
Na poziomie wykonawczym działa lekka, wyspecjalizowana sieć dyfuzyjna lub polityka uczenia przez wzmacnianie uruchamiana bezpośrednio na pokładowym układzie scalonym robota. Poziom ten otrzymuje od kory nowej wektor reprezentacji semantycznej oraz cel przestrzenny, po czym w ścisłej pętli częstotliwości od stu do pięciuset herców przetwarza bezpośrednie sygnały z czujników dotykowych, tensometrów umieszczonych w nadgarstkach oraz jednostek inercjalnych IMU. To właśnie ten poziom odpowiada za utrzymanie stabilności pionowej całego humanoida, kompensację momentów bezwładności i mikrokorekty siły docisku palców, zapobiegając zmiażdżeniu delikatnego kubka lub upuszczeniu śliskiego elementu metalowego.
Taki rozdział ról rozwiązuje problem krytycznej latencji. Gdyby robot o masie siedemdziesięciu kilogramów musiał czekać kilkaset milisekund na odpowiedź chmurowego transformatora w celu skorygowania równowagi po poślizgnięciu się na mokrej posadzce, upadek na ziemię byłby nieunikniony. Dzięki autonomicznej polityce stabilizacji niskiego poziomu korpus robota zachowuje dynamiczną sprężystość i natychmiast reaguje na zaburzenia mechaniczne, podczas gdy model wysokiego poziomu może spokojnie planować kolejne posunięcia logistyczne.
Skalowanie danych manipulacyjnych i symulacje fizyczne
Podczas gdy duże modele językowe mogły trenować na niemal nieskończonych zasobach zdigitalizowanego tekstu w internecie, rozwój robotyki humanoidalnej napotkał na fundamentalny problem braku ustrukturyzowanych danych manipulacyjnych. Przez lata zbiory demonstracji fizycznych były miniaturowe, obejmując zaledwie dziesiątki lub setki godzin nagrań z pojedynczych typów robotów laboratoryjnych. Sytuację zmieniły dopiero inicjatywy otwartego gromadzenia danych, takie jak Open X-Embodiment, w ramach których wiodące laboratoria akademickie i komercyjne połączyły swoje zasoby, tworząc bazę ponad miliona trajektorii zarejestrowanych na dwudziestu dwóch różnych platformach sprzętowych.
Okazało się, że trenowanie modeli na danych pochodzących z drastycznie odmiennych ramion robotycznych nie tylko jest możliwe, ale prowadzi do zjawiska pozytywnego transferu międzysprzętowego. Model uczony na chwytakach dwuszczękowych, ramionach scara oraz ramionach antropomorficznych buduje wewnętrzną reprezentację przestrzeni działań, która pozwala na błyskawiczne dostrojenie do całkowicie nowej mechaniki za pomocą zaledwie kilkunastu demonstracji. Aby jeszcze bardziej przyspieszyć pozyskiwanie danych, producenci robotów wdrożyli systemy teleoperacji oparte na goglach wirtualnej rzeczywistości oraz lekkich szkieletach zewnętrznych zakładanych na dłonie operatora, co pozwala człowiekowi na naturalne kierowanie maszyną w warunkach rzeczywistych i generowanie tysięcy idealnych trajektorii dziennie.
Równolegle kluczowym filarem staje się symulacja typu sim-to-real. Nowoczesne silniki fizyczne renderujące na procesorach graficznych, takie jak NVIDIA Isaac Sim oparte na platformie Omniverse oraz MuJoCo, pozwalają na uruchamianie tysięcy równoległych instancji środowisk wirtualnych w czasie przyspieszonym setki razy względem czasu rzeczywistego. Zastosowanie randomizacji domenowej, polegającej na ciągłej, losowej zmianie współczynników tarcia, masy obiektów, opóźnień sensorycznych, szumów kamer oraz tekstur oświetlenia, zmusza trenowane polityki do wykształcenia odporności na wszelkie niedoskonałości świata realnego. Polityka wytrenowana w ten sposób w symulatorze po wgraniu do fizycznego humanoida wykazuje natychmiastową stabilność i bezbłędne wykonywanie zadań bez potrzeby długotrwałego, kosztownego douczania na fizycznym sprzęcie.
Wyzwania sprzętowe i rewolucja siłowników antropomorficznych
Oprogramowanie oparte na modelach VLA wymaga jednak radykalnego postępu w samej inżynierii mechanicznej i materiałowej. Klasyczne przekładnie falowe oraz precyzyjne przekładnie cykloidalne, choć cechują się zerowym luzem nawrotnym, są niezwykle sztywne i podatne na uszkodzenia udarowe w momencie nagłego uderzenia kończyny o przeszkodę. W robotyce humanoidalnej nowej generacji standardem stają się siłowniki quasi-bezpośrednie QDD (Quasi-Direct Drive) oraz układy ze zmienną sztywnością SEA (Series Elastic Actuators). Charakteryzują się one niskim stopniem redukcji przełożenia, co pozwala na pełną przezroczystość mechaniczną i bezpośrednie szacowanie sił zewnętrznych na podstawie prądu pobieranego przez bezszczotkowe silniki synchroniczne.
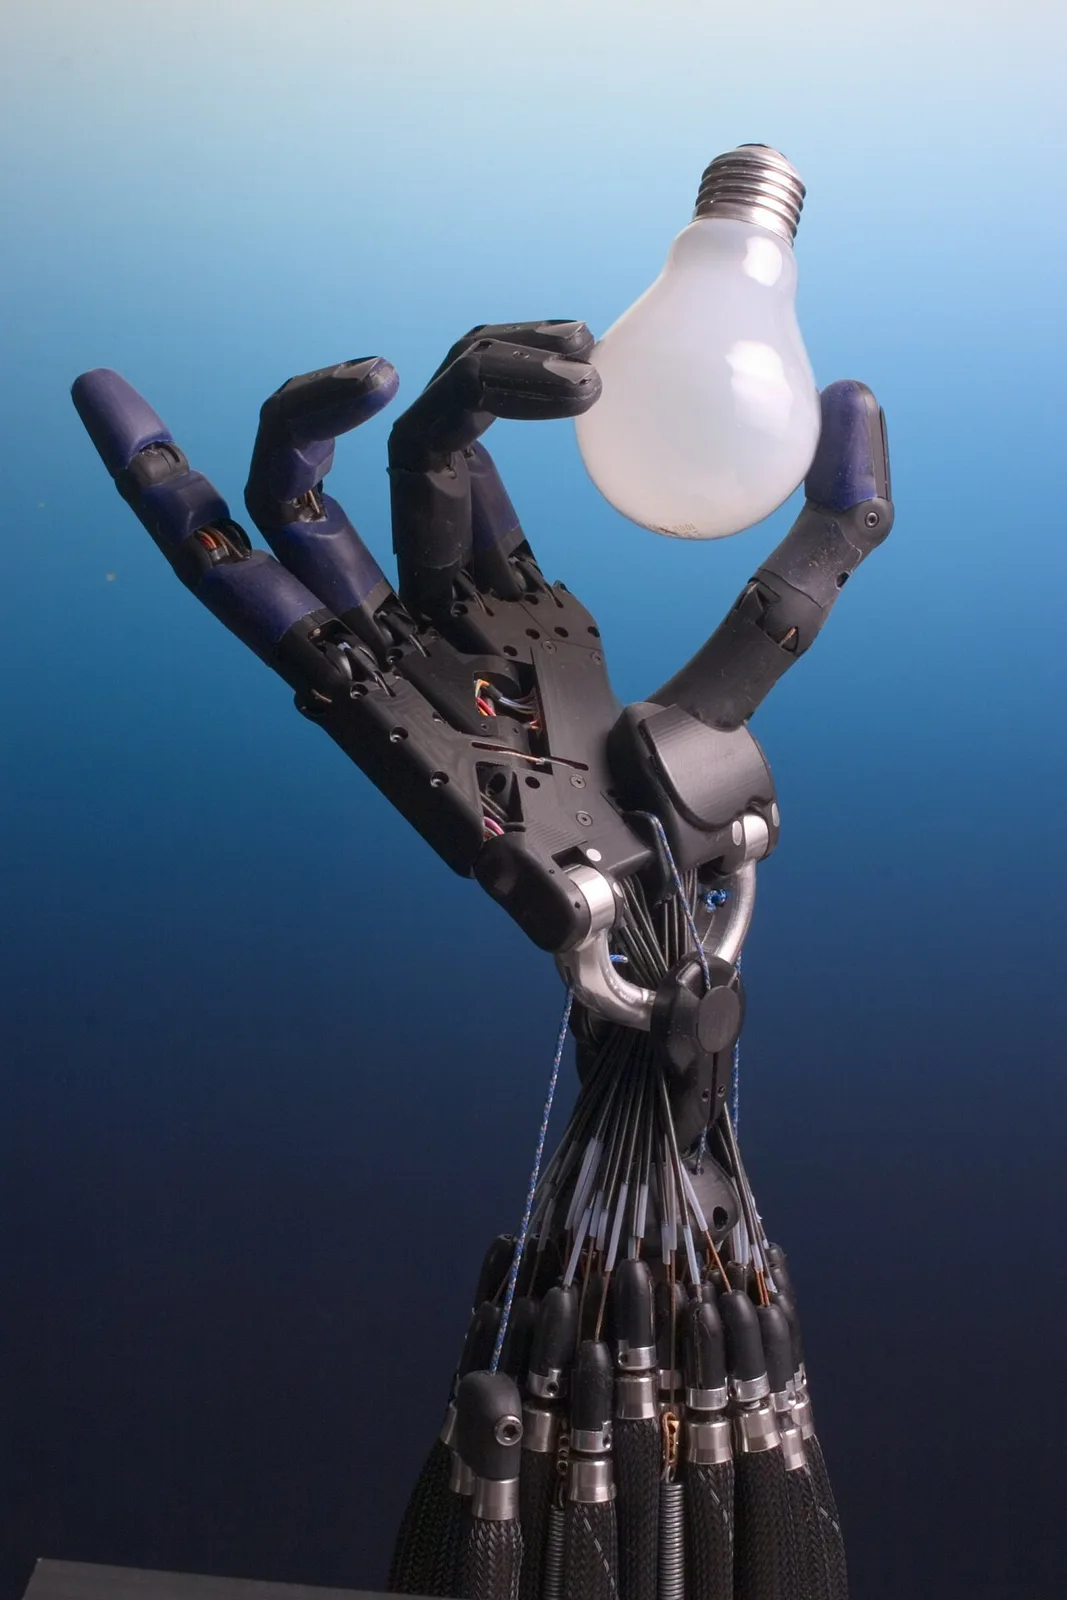
Kolejnym obszarem intensywnych innowacji są dłonie antropomorficzne. Ludzka dłoń posiada dwadzieścia siedem stopni swobody, co pozwala jej na nieskończoną gamę chwytów siłowych i precyzyjnych. Odtworzenie tej geometrii w robocie przy jednoczesnym zmieszczeniu siłowników, przekładni cięgnowych oraz elektroniki sterującej w objętości ludzkiego przedramienia wymaga stosowania stopów z pamięcią kształtu, sztucznych mięśni elektrostatycznych lub miniaturowych silników bezrdzeniowych zintegrowanych bezpośrednio w paliczkach. Niezbędna staje się również integracja gęstych matryc czujników dotykowych opartych na zjawisku piezorezystywności lub optycznych sensorach elastomerowych, które rejestrują nie tylko wektor siły nacisku, ale również kierunek wektora ścinającego, informując kontroler o początku zjawiska mikropoślizgu zanim trzymany przedmiot wypadnie z dłoni.
Na poziomie elektroniki pokładowej kluczowe staje się upakowanie akceleratorów wnioskowania AI o mocy setek teraflopsów przy budżecie energetycznym nieprzekraczającym kilkudziesięciu watów. Zastosowanie kwantyzacji wag do formatów FP8 i INT4 pozwala na uruchamianie zaawansowanych wizualnych modeli korytarzowych bezpośrednio na zintegrowanych procesorach brzegowych, eliminując zależność od łączności radiowej z chmurą obliczeniową, co stanowi warunek konieczny dla certyfikacji bezpieczeństwa maszyn w przemyśle.
Wpływ przemysłowy i transformacja geopolityczna
Wejście humanoidalnych robotów napędzanych modelami Foundation na hale produkcyjne nie jest już odległą wizją futurologiczną, lecz procesem wdrażanym na masową skalę w fabrykach motoryzacyjnych w Ameryce Północnej, Niemczech i Azji Wschodniej. Zamiast budować dedykowane, sztywne linie automatyczne, których koszt przeprojektowania przy zmianie modelu pojazdu sięga dziesiątek milionów dolarów, koncerny wdrażają uniwersalne platformy humanoidalne zdolne do operowania tymi samymi narzędziami ręcznymi, wkrętarkami i elementami montażowymi, którymi dotychczas posługiwali się ludzie.
Humanoid potrafi przejść wzdłuż linii montażowej, zidentyfikować wadliwie ułożoną wiązkę przewodów, poprawić jej mocowanie z użyciem elastycznego chwytu i powrócić na swoje stanowisko, nie wymagając ani jednej linii kodu napisanego przez programistę PLC. Wszelkie instrukcje przekazywane są językiem naturalnym lub poprzez krótką demonstrację teleoperacyjną. To zjawisko prowadzi do radykalnego obniżenia barier wejścia dla robotyzacji małych i średnich przedsiębiorstw, które dotychczas nie mogły sobie pozwolić na zatrudnianie wyspecjalizowanych integratorów robotyki przemysłowej.
Jednocześnie technologia ta staje się nowym polem bezwzględnej rywalizacji geopolitycznej. Administracje państwowe zdają sobie sprawę, że kraj, który jako pierwszy osiągnie dominację w produkcji ucieleśnionych modeli Foundation oraz masowej fabrykacji siłowników i przekładni, zyska przewagę strukturalną w światowym łańcuchu wartości dodanej. Stany Zjednoczone przodują obecnie w rozwoju bazowych modeli wielomodalnych oraz architektur programistycznych, podczas gdy Chiny posiadają niemal całkowity monopol na wytwarzanie magnesów neodymowych NdFeB niezbędnych w wysokosprawnych silnikach synchronicznych oraz dysponują niezrównaną bazą poddostawców precyzyjnej obróbki mechanicznej. Przełamanie paradoksu Moraveca nie oznacza jedynie sukcesu akademickiego, lecz otwiera erę, w której praca fizyczna staje się bezpośrednio skalowalnym zasobem cyfrowym.
Perspektywy ewolucji algorytmów i horyzont pełnej autonomii
W perspektywie najbliższych lat kluczowym kierunkiem badań nad modelami Vision-Language-Action będzie integracja wnioskowania przyczynowo-skutkowego oraz długoterminowego planowania przestrzennego. Obecne systemy, mimo imponującej sprawności w wykonywaniu sekwencji kilkunastu powiązanych czynności, wciąż wykazują kruchość logiczną w sytuacjach wymagających geometrycznego przewidywania konsekwencji na wiele kroków naprzód. Rozwiązaniem staje się włączanie do modeli polityk neuronowych tak zwanych modeli świata, które potrafią w ukrytej przestrzeni cech symulować przyszłe stany fizyczne otoczenia pod wpływem potencjalnych działań robota, zanim którykolwiek silnik zostanie fizycznie uruchomiony.
Symulowanie przyszłości w przestrzeni utajonej pozwala na natychmiastowe odrzucenie trajektorii grożących kolizją, utratą równowagi lub uszkodzeniem manipulowanego obiektu. Co więcej, rozwój samonadzorowanego uczenia się na podstawie ciągłego strumienia wideo pozwala robotom na nieustanne aktualizowanie swojej wiedzy o dynamice otoczenia podczas codziennej pracy bez konieczności interwencji inżyniera. Tego typu samodoskonalenie zamyka lukę między laboratoryjnymi demonstracjami a niezawodnością wymaganą w operacjach chirurgicznych, inspekcji infrastruktury krytycznej i misjach kosmicznych.
Równocześnie następuje standaryzacja interfejsów sprzętowo-programowych, co umożliwia uniezależnienie rozwoju algorytmów sztucznej inteligencji od specyfiki konkretnych producentów siłowników czy platform kroczących. Powstanie uniwersalnych systemów operacyjnych dla robotyki humanoidalnej zintegrowanych z modelami Foundation stworzy ekosystem analogiczny do tego, jaki ukształtował się w branży smartfonów. Deweloperzy z całego świata będą mogli dostarczać wyspecjalizowane pakiety umiejętności motorycznych, które każdy użytkownik humanoida pobierze i zainstaluje w kilka sekund, przekształcając maszynę z pracownika magazynowego w precyzyjnego kucharza lub asystenta laboratoryjnego.
Zaawansowana analityka danych telemetrycznych rejestrowanych przez tysiące połączonych w chmurze robotów humanoidalnych tworzy unikalny efekt sieciowy. Każdy błąd wykonawczy, każde potknięcie na nietypowej nawierzchni i każdy przypadek trudnego chwytu zarejestrowany przez pojedynczą jednostkę trafia do centralnego repozytorium uczącego, gdzie po zanonimizowaniu staje się przypadkiem brzegowym w nocnych cyklach treningowych modeli Foundation. W ten sposób wiedza całej floty maszyn podlega ciągłej kumulacji, sprawiając, że rozwiązanie problemu napotkanego przez robota na jednym kontynencie staje się natychmiast dostępne dla wszystkich pozostałych jednostek pracujących w fabrykach na całym świecie. Ta dynamika wykładniczego uczenia się floty sprawia, że dystans dzielący roboty humanoidalne od ludzkiej zręczności i wszechstronności adaptacyjnej kurczy się w tempie, którego nie przewidywali nawet najwięksi optymiści automatyzacji przemysłowej.
Zaawansowana analityka danych telemetrycznych rejestrowanych przez tysiące połączonych w chmurze robotów humanoidalnych tworzy unikalny efekt sieciowy. Każdy błąd wykonawczy, każde potknięcie na nietypowej nawierzchni i każdy przypadek trudnego chwytu zarejestrowany przez pojedynczą jednostkę trafia do centralnego repozytorium uczącego, gdzie po zanonimizowaniu staje się przypadkiem brzegowym w nocnych cyklach treningowych modeli Foundation. W ten sposób wiedza całej floty maszyn podlega ciągłej kumulacji, sprawiając, że rozwiązanie problemu napotkanego przez robota na jednym kontynencie staje się natychmiast dostępne dla wszystkich pozostałych jednostek pracujących w fabrykach na całym świecie. Ta dynamika wykładniczego uczenia się floty sprawia, że dystans dzielący roboty humanoidalne od ludzkiej zręczności i wszechstronności adaptacyjnej kurczy się w tempie, którego nie przewidywali nawet najwięksi optymiści automatyzacji przemysłowej.
Zaawansowana analityka danych telemetrycznych rejestrowanych przez tysiące połączonych w chmurze robotów humanoidalnych tworzy unikalny efekt sieciowy. Każdy błąd wykonawczy, każde potknięcie na nietypowej nawierzchni i każdy przypadek trudnego chwytu zarejestrowany przez pojedynczą jednostkę trafia do centralnego repozytorium uczącego, gdzie po zanonimizowaniu staje się przypadkiem brzegowym w nocnych cyklach treningowych modeli Foundation. W ten sposób wiedza całej floty maszyn podlega ciągłej kumulacji, sprawiając, że rozwiązanie problemu napotkanego przez robota na jednym kontynencie staje się natychmiast dostępne dla wszystkich pozostałych jednostek pracujących w fabrykach na całym świecie. Ta dynamika wykładniczego uczenia się floty sprawia, że dystans dzielący roboty humanoidalne od ludzkiej zręczności i wszechstronności adaptacyjnej kurczy się w tempie, którego nie przewidywali nawet najwięksi optymiści automatyzacji przemysłowej.
Zaawansowana analityka danych telemetrycznych rejestrowanych przez tysiące połączonych w chmurze robotów humanoidalnych tworzy unikalny efekt sieciowy. Każdy błąd wykonawczy, każde potknięcie na nietypowej nawierzchni i każdy przypadek trudnego chwytu zarejestrowany przez pojedynczą jednostkę trafia do centralnego repozytorium uczącego, gdzie po zanonimizowaniu staje się przypadkiem brzegowym w nocnych cyklach treningowych modeli Foundation. W ten sposób wiedza całej floty maszyn podlega ciągłej kumulacji, sprawiając, że rozwiązanie problemu napotkanego przez robota na jednym kontynencie staje się natychmiast dostępne dla wszystkich pozostałych jednostek pracujących w fabrykach na całym świecie. Ta dynamika wykładniczego uczenia się floty sprawia, że dystans dzielący roboty humanoidalne od ludzkiej zręczności i wszechstronności adaptacyjnej kurczy się w tempie, którego nie przewidywali nawet najwięksi optymiści automatyzacji przemysłowej.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Architektury pamięci wewnątrzprocesorowej PIM i optoelektroniczne macierze akceleratorów: Jak przełamanie wąskiego gardła pamięci HBM rewolucjonizuje trenowanie modeli frontierowych z bilionem parametrów
Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.