
Architektury pamięci wewnątrzprocesorowej PIM i optoelektroniczne macierze akceleratorów: Jak przełamanie wąskiego gardła pamięci HBM rewolucjonizuje trenowanie modeli frontierowych z bilionem parametrów

Ewolucja wielkich modeli sztucznej inteligencji, dążących do przekroczenia bariery biliona parametrów oraz osiągnięcia multimodalnej spójności w czasie rzeczywistym, doprowadziła do zderzenia z najbardziej bezwzględną ścianą fizyczną współczesnej mikroelektroniki. Przez ostatnie pół wieku rozwój architektury komputerowej opierał się na paradygmacie von Neumanna, w którym jednostki wykonawcze odpowiedzialne za operacje arytmetyczno-logiczne są fizycznie odseparowane od podsystemu pamięci operacyjnej magistralami transmisyjnymi. O ile gęstość tranzystorów oraz surowa moc obliczeniowa akceleratorów GPU i TPU rosły w tempie geometrycznym, o tyle przepustowość i opóźnienia magistrali pamięci rozwijały się wielokrotnie wolniej. W rezultacie zjawisko określane mianem Memory Wall, czyli ściany pamięci, przestało być jedynie akademickim problemem inżynierii krzemowej, a stało się głównym czynnikiem dławiącym efektywność klastrów sztucznej inteligencji w centrach danych na całym świecie.
Współczesne flagowe akceleratory graficzne, wykorzystujące zaawansowane stosy pamięci o wysokiej przepustowości HBM3e oraz raczkujące standardy HBM4 połączone z krzemową matrycą logiczną za pośrednictwem pasywnych interposerów krzemowych CoWoS, oferują przepustowości sięgające kilku terabajtów na sekundę. Jednakże w przypadku modeli autoregresyjnych faza dekodowania, polegająca na generowaniu kolejnych tokenów sekwencji tekstowej, wymaga nieustannego odczytywania pełnej macierzy wag z pamięci operacyjnej dla każdego pojedynczego kroku inferencyjnego. W tym reżimie pracy potężne macierze jednostek tensorowych przez ponad osiemdziesiąt procent czasu pozostają w stanie bezczynności, oczekując na dostarczenie danych z zewnętrznych stosów DRAM. Co gorsza, energetyczny koszt przesłania pojedynczego bajta informacji przez magistralę interposera przewyższa koszt wykonania samej operacji matematycznej na tym bajcie o ponad dwa rzędy wielkości. Odpowiedzią na ten energetyczny i wydajnościowy impas staje się przetwarzanie wewnątrz pamięci PIM oraz zintegrowane macierze optoelektroniczne.
Fizyka zjawiska Memory Wall i dylemat energetyczny magistral krzemowych
Aby w pełni zrozumieć konieczność porzucenia klasycznej architektury pamięci, należy przeanalizować bilans energetyczny współczesnego chipletu obliczeniowego. W konwencjonalnym procesorze graficznym operacja mnożenia i akumulacji macierzowej w formacie zmiennoprzecinkowym FP8 lub FP16 pochłania poniżej jednego pikodżula energii. W tym samym czasie odczytanie argumentów tej operacji z odległego banku pamięci DRAM, przesłanie ich przez wewnętrzne linie transmisyjne, buforowanie w kontrolerze pamięci, transmisja przez mikroskopijne wyprowadzenia kulkowe TSV na interposer krzemowy i wreszcie załadowanie do pamięci podręcznej SRAM poziomu pierwszego pochłania od kilkudziesięciu do nawet kilkuset pikodżuli na operację.
W klastrach treningowych zasilanych setkami megawatów mocy elektrycznej oznacza to, że ponad sześćdziesiąt procent całkowitego zużycia energii elektrycznej przez centrum danych jest marnotrawione nie na generowanie nowej wiedzy czy optymalizację gradientów sieci neuronowej, lecz na czyste, pasożytnicze grzanie krzemowych połączeń miedzianych podczas bezustannego transferu danych w obie strony. Zjawisko to prowadzi do powstania lokalnych punktów przegrzania w strukturze 2.5D i 3D, zmuszając projektantów do obniżania częstotliwości taktowania zegarów bazowych i komplikując systemy chłodzenia cieczowego. Fizyczna bariera pojemności cieplnej krzemu sprawia, że dalsze zwiększanie szerokości szyny pamięci w tradycyjnym modelu staje się ekonomicznie i inżynieryjnie niewykonalne.
Architektury Processing-In-Memory: Renesans idei przetwarzania w bankach DRAM
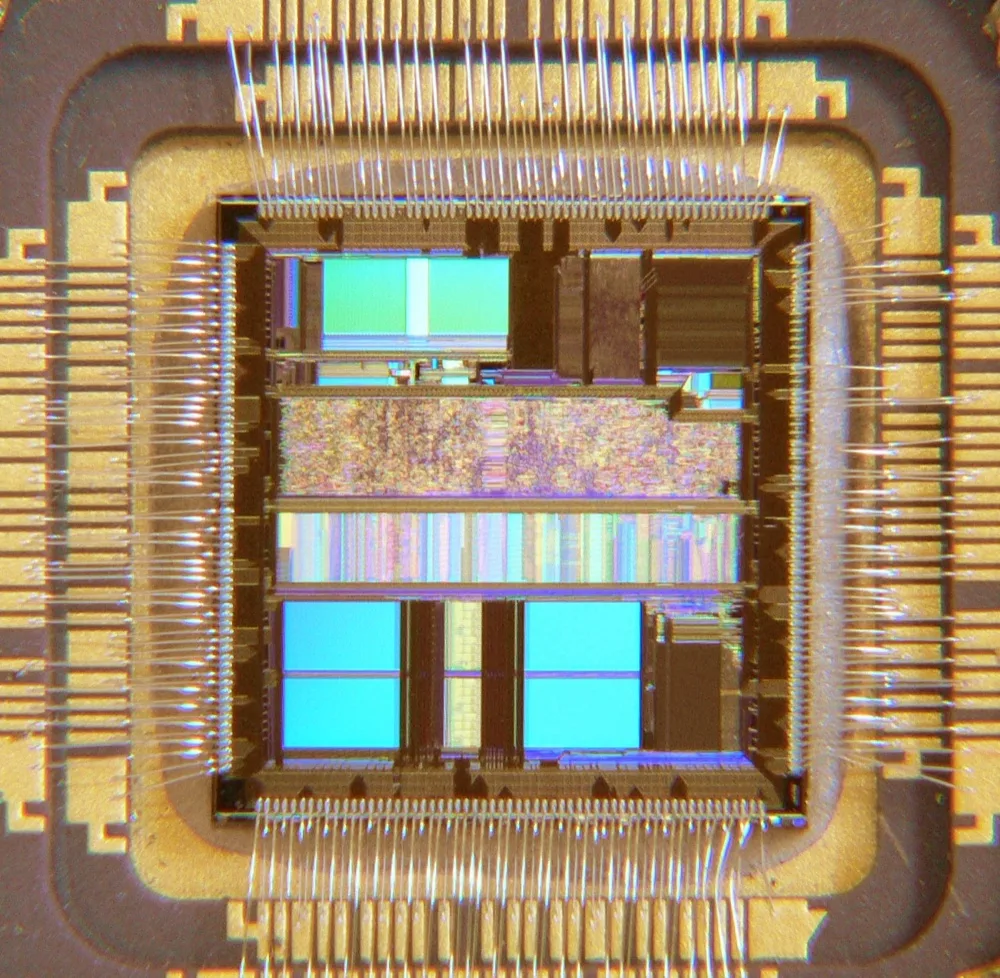
Koncepcja przetwarzania wewnątrz pamięci PIM, choć postulowana teoretycznie już w latach siedemdziesiątych ubiegłego stulecia, doczekała się dojrzałej realizacji inżynieryjnej dopiero dzięki opanowaniu technologii zaawansowanego pakowania trójwymiarowego 3D TSV oraz technologii hybrydowego łączenia bezpośredniego miedź-miedź Direct Copper Bonding. Zamiast traktować stos pamięci DRAM jako bierny magazyn bitów, inżynierowie integrują miniaturowe, wysoce zrównoleglone procesory arytmetyczne SIMD bezpośrednio w strukturze matrycy krzemowej pamięci, tuż obok wzmacniaczy odczytu i dekoderów wierszy poszczególnych banków pamięciowych.
Wiodącymi przykładami tej filozofii są rozwiązania komercyjne rozwijane przez liderów rynku półprzewodników, w tym technologie HBM-PIM oraz Aquabolt-XL. W takiej architekturze komendy obliczeniowe są przesyłane bezpośrednio przez standardowy protokół magistrali pamięciowej, a operacje algebry liniowej, takie jak mnożenie wektora przez macierz GEMV, operacje aktywacji nieliniowych ReLU i GeLU oraz normalizacja Softmax, są wykonywane bezpośrednio na miejscu w pamięci, z wykorzystaniem wewnętrznej, gigantycznej przepustowości magistrali wewnętrznej DRAM, sięgającej dziesiątek terabajtów na sekundę. W rezultacie do głównego rdzenia graficznego zwracany jest jedynie zredukowany wynik końcowy, co redukuje ruch na magistralach międzymatrycowych o ponad dziewięćdziesiąt procent i eliminuje przestój jednostek obliczeniowych.
Pamięci nieulotne MRAM i ReRAM w roli analogowych jednostek mnożenia
Jeszcze bardziej radykalnym krokiem w ewolucji PIM jest odejście od ulotnych komórek pojemnościowych DRAM na rzecz technologii pamięci rezystywnych ReRAM oraz magnetycznych pamięci ze sprzężeniem spinowo-momentowym STT-MRAM i SOT-MRAM. Pamięci te przechowują informacje nie w postaci ładunku elektrycznego na mikroskopijnym kondensatorze, lecz w postaci rezystancji cienkowarstwowego tlenku metalu lub konfiguracji magnetycznej złącza tunelowego MTJ. Właściwość ta pozwala na realizację operacji matematycznych w domenie analogowej w oparciu o fundamentalne prawa fizyki obwodów elektrycznych.
Zgodnie z prawem Ohma prąd płynący przez element rezystywny jest iloczynem napięcia i przewodności, natomiast zgodnie z pierwszym prawem Kirchhoffa prądy w węźle elektrycznym sumują się algebraicznie. Gdy matryca pamięci ReRAM zostanie skonfigurowana w postaci siatki krzyżowej Crossbar Array, wagi warstw sieci neuronowej mogą zostać zaprogramowane bezpośrednio jako przewodności poszczególnych komórek pamięciowych. Podanie wektora wejściowego w postaci poziomów napięcia na linie wierszy powoduje, że na liniach kolumn w ułamku nanosekundy pojawia się wektor prądów stanowiący dokładny wynik operacji mnożenia macierzowego. Cały proces zachodzi w sposób w pełni równoległy przy niemal zerowym zużyciu energii, ponieważ komórki pamięci nie wymagają ciągłego odświeżania, a proces obliczeniowy nie wymaga wyodrębniania cykli zegarowych procesora.
Optoelektroniczne macierze akceleratorów: Przełamanie opóźnień światłem
Podczas gdy PIM rewolucjonizuje przetwarzanie wewnątrz pojedynczego węzła krzemowego, integracja optoelektroniczna staje się fundamentem nowej generacji superskalarnych procesorów AI. Klasyczne połączenia metaliczne napotykają na ograniczenia pasma przenoszenia wywołane pojemnością pasożytniczą oraz zjawiskiem naskórkowości w wysokich częstotliwościach mikrofalowych. Zastąpienie miedzianych ścieżek zintegrowanymi falowodami fotonicznymi ze azotku krzemu SiN oraz krzemu na izolatorze SOI pozwala na bezstratny transport danych z prędkością światła przy minimalnej dyssypacji energii cieplnej.
Szczytowym osiągnięciem w tym segmencie są optyczne procesory macierzowe OPU oparte na siatkach interferometrów Macha-Zehndera MZI. W układach tych wagi macierzy transformera są kodowane za pomocą przesunięć fazowych wiązek laserowych w mikrofalowodach, a operacja mnożenia i sumowania jest realizowana na drodze konstruktywnej i destruktywnej interferencji fal elektromagnetycznych. Sygnał świetlny przechodzi przez siatkę fotoniczną w czasie pikosekund, bez generowania strat rezystancyjnych. Integracja takich fotonicznych matryc obliczeniowych bezpośrednio ze stosami pamięci HBM poprzez optyczne połączenia chipletowe CPO pozwala na stworzenie klastrów o przepustowościach rzędu petabitów na sekundę, otwierając zupełnie nową erę w trenowaniu architektur zawierających biliony parametrów.
Implikacje dla modeli frontierowych z bilionem parametrów
Przejście na architektury PIM i akcelerację optoelektroniczną zmienia reguły gry w wyścigu o sztuczną inteligencję ogólnego przeznaczenia AGI. Modele frontierowe nowej generacji, takie jak systemy oparte na architekturze rzadkich ekspertów Mixture-of-Experts MoE z setkami miliardów aktywnych parametrów, są w sposób szczególny podatne na opóźnienia pamięciowe. W architekturze MoE każdy token tekstu lub klatka obrazu jest kierowana do innego, wąsko wyspecjalizowanego zestawu podsieci neuronowych, co wywołuje zjawisko losowych, nieregularnych skoków adresowych w przestrzeni pamięci operacyjnej.
Tradycyjne procesory graficzne w takich warunkach doświadczają potężnego załamania wydajności, ponieważ mechanizmy wstępnego pobierania danych Pre-fetching okazują się bezradne wobec nieprzewidywalności routingu warstw. W architekturze PIM każdy bank pamięci obsługuje przypisanych do niego ekspertów lokalnie, eliminując konieczność przesyłania setek gigabajtów parametrów przez magistralę centralną. Umożliwia to liniowe skalowanie wydajności klastra obliczeniowego wraz ze wzrostem liczby parametrów modelu, redukując całkowity czas treningu z wielu miesięcy do zaledwie kilkunastu dni przy jednoczesnym obniżeniu rachunków za energię elektryczną o miliony dolarów.
Ekosystem oprogramowania i kompilatorów: Przełamywanie bariery abstrakcji
Największym wyzwaniem stojącym na drodze masowej komercjalizacji technologii PIM i optoelektroniki nie jest obecnie fizyka materiałowa czy litografia krzemowa, lecz warstwa oprogramowania systemowego i kompilatorów. Od dziesięcioleci cały ekosystem programistyczny, od języków C i Python po frameworki PyTorch i JAX, zakłada istnienie jednolitej, płaskiej przestrzeni adresowej oraz hierarchii pamięci podręcznej zorganizowanej w tradycyjne warstwy L1, L2 i pamięć główną. Wdrożenie heterogenicznych układów PIM wymaga przepisania stosu kompilatorów w taki sposób, aby algorytm automatycznie potrafił podzielić graf obliczeniowy sieci neuronowej na operacje optymalne do wykonania w jednostkach tensorowych GPU oraz operacje podlegające zrzuceniu do banków pamięciowych.
Nowoczesne kompilatory pośrednie, takie jak Triton rozwijany przez OpenAI czy ekosystem MLIR i XLA wspierany przez Google, wprowadzają zaawansowane heurystyki poliedryczne, które w sposób automatyczny analizują lokalność danych i syntetyzują kod maszynowy zoptymalizowany pod kątem mikroarchitektury PIM. Dzięki temu inżynierowie trenujący modele sztucznej inteligencji mogą zachować dotychczasowy poziom abstrakcji wysokiego poziomu w kodzie modelarskim, podczas gdy kompilator w sposób przezroczysty dla użytkownika deleguje miliony wątków do fizycznych banków DRAM lub ReRAM, optymalizując przepływ danych w czasie rzeczywistym.
Geopolityka zaawansowanego pakowania i suwerenność krzemowa
Rozwój pamięci PIM i optoelektroniki przenosi również punkt ciężkości globalnej rywalizacji geopolitycznej. Przez dekady miernikiem potęgi technologicznej państwa była zdolność do naświetlania coraz mniejszych węzłów litograficznych w technologii EUV, w czym monopol utrzymuje tajwański TSMC i holenderski ASML. Jednak w erze przełamywania Memory Wall kluczowym wąskim gardłem staje się technologia zaawansowanego pakowania 3D oraz dostęp do certyfikowanych linii produkcyjnych pamięci HBM, kontrolowanych przez zaledwie trzy firmy na świecie: południowokoreański SK Hynix, Samsung Electronics oraz amerykański Micron Technology.
Państwa zachodnie, świadome tej krytycznej zależności, przeznaczają bezprecedensowe fundusze w ramach programów CHIPS Act na budowę zaawansowanych zakładów pakowania układów scalonych na własnym terytorium. Zdolność do wytwarzania procesorów zintegrowanych z pamięcią PIM oraz optycznymi interposerami staje się bezpośrednim wyznacznikiem suwerenności gospodarczej i militarnej. Ten, kto jako pierwszy zintegruje potęgę wielkich modeli językowych z bezstratną, energooszczędną fizyką pamięci wewnątrzprocesorowej, zyska decydującą przewagę w kształtowaniu technologicznego porządku nadchodzącej ery sztucznej inteligencji ogólnej.
Metrologia nanometrowa i defektometria złączy hybrydowych miedź-miedź
Kluczowym elementem warunkującym seryjną produkcję układów PIM w procesach 3D jest precyzja litograficzna i mechaniczna łączenia płytek krzemowych na poziomie złączy hybrydowych Cu-Cu Direct Bonding. W przeciwieństwie do tradycyjnych mikrokulek lutowniczych o średnicy kilkudziesięciu mikrometrów, bezpośrednie łączenie miedzi z miedzią wymaga osiągnięcia rozstawu padów kontaktowych poniżej jednego mikrometra. Przy tak ekstremalnej skali jakakolwiek cząstka kurzu o rozmiarze kilkunastu nanometrów lub nierówność planarizacji chemiczno-mechanicznej CMP przekraczająca ułamek nanometra prowadzi do powstania pustki delaminacyjnej, skutkującej przerwaniem połączenia setek tysięcy linii sygnałowych.
W celu zapewnienia stuprocentowej kontroli jakości w liniach produkcyjnych fabryk półprzewodników stosuje się zaawansowaną defektometrię akustyczną o wysokiej częstotliwości gigachercowej oraz synchrotronową tomografię rentgenowską X-ray Topography. Narzędzia te skanują połączone wafelki krzemowe bez ich niszczenia, mapując rozkład naprężeń wewnątrz sieci krystalicznej miedzi oraz weryfikując poprawność dyfuzji atomowej na styku ziaren metalu pod wpływem wygrzewania termicznego w temperaturze trzystu stopni Celsjusza. Opanowanie tego procesu pozwala na osiągnięcie gęstości połączeń przekraczającej milion pionowych linii transmisyjnych na milimetr kwadratowy, co stanowi fizyczny fundament dla bezstratnego transferu danych w architekturach PIM nowej generacji.
Dychotomia architektoniczna: Near-Memory Computing a In-Memory Processing
W debacie inżynieryjnej nad optymalizacją podsystemów pamięciowych wykształcił się wyraźny podział na dwa komplementarne podejścia: obliczenia bliskie pamięci określane jako Near-Memory Computing oraz właściwe przetwarzanie wewnątrz pamięci In-Memory Computing. W podejściu Near-Memory jednostki obliczeniowe są umieszczane na osobnej matrycy logicznej Base Die znajdującej się u podstawy pionowego stosu pamięci HBM, połączonej z warstwami DRAM za pomocą przelotek TSV. Zaletą tego rozwiązania jest możliwość wykonania rdzeni logicznych w najbardziej zaawansowanym węźle litograficznym, na przykład trzech nanometrach, podczas gdy same warstwy DRAM są produkowane w tańszych i bardziej wyspecjalizowanych procesach technologicznych.
Z kolei właściwe przetwarzanie In-Memory integruje obwody arytmetyczne bezpośrednio na poziomie pojedynczych podmacierzy Sub-array wewnątrz warstw pamięciowych. W tym układzie operacje są realizowane równolegle na tysiącach linii bitowych Bitlines, co pozwala na wykorzystanie pełnej, wewnętrznej szerokości pasma matrycy krzemowej, niemożliwej do wyprowadzenia na zewnątrz ze względów geometrycznych. O ile Near-Memory Computing doskonale sprawdza się w przypadku operacji wymagających wysokiej precyzji zmiennoprzecinkowej i złożonego sterowania rozgałęzieniami, o tyle In-Memory Processing deklasuje konkurencję w powtarzalnych, masowych operacjach iloczynu skalarnego, stanowiących ponad dziewięćdziesiąt procent obciążenia w sieciach neuronowych.
Formaty mikroskalowania MX i niska precyzja numeryczna w macierzach PIM
Radykalny wzrost wydajności energetycznej układów PIM osiągany jest również poprzez harmonijną synergię z nowymi formatami reprezentacji liczb zmiennoprzecinkowych. Tradycyjne formaty FP32 oraz FP16 ustępują miejsca standardom mikroskalowania Microscaling Formats MX opracowanym przez konsorcjum OCP Open Compute Project, obejmującym formaty MXFP8, MXFP6 oraz MXFP4. W formatach tych pojedynczy blok kilkunastu lub kilkudziesięciu liczb współdzieli wspólny wykładnik potęgowy, co drastycznie redukuje liczbę bitów niezbędnych do zakodowania mantysy poszczególnych wag modelu.
Wdrożenie formatów MXFP4 w analogowych macierzach krzyżowych ReRAM i PIM pozwala na podwojenie gęstości upakowania operacji arytmetycznych w jednostce objętości krzemu oraz czterokrotne obniżenie pojemności pasożytniczej linii sygnałowych. Dynamiczne skalowanie zakresu wartości wewnątrz bloków mikroskalowania zapobiega zjawisku zanikania gradientów podczas trenowania modeli frontierowych, umożliwiając zachowanie pełnej zbieżności procesu optymalizacyjnego przy jednoczesnym obniżeniu zapotrzebowania na pamięć roboczą o ponad siedemdziesiąt procent. Połączenie zaawansowanej reprezentacji numerycznej z bezstratną fizyką przetwarzania wewnątrz pamięci definiuje nowy standard efektywności obliczeniowej, który pozwoli na demokratyzację trenowania modeli sztucznej inteligencji na niespotykaną dotąd skalę.
Termomechanika naprężeń w pakietach wielowarstwowych 3D i zarządzanie ciepłem
Integracja pionowa pamięci i logiki w układach PIM niesie ze sobą bezprecedensowe wyzwania w dziedzinie fizyki materiałowej i inżynierii cieplnej. Kiedy komórki pamięci DRAM, które są tradycyjnie wysoce wrażliwe na temperaturę ze względu na przyspieszony upływ ładunku z kondensatorów i konieczność częstszego odświeżania, zostaną umieszczone bezpośrednio nad lub pod gorącymi rdzeniami logicznymi generującymi setki watów ciepła na centymetr kwadratowy, stabilność termiczna całego układu staje się krytyczna. Wzrost temperatury komórek pamięci powyżej osiemdziesięciu pięciu stopni Celsjusza drastycznie skraca czas retencji danych, wymuszając podwojenie częstotliwości odświeżania i niwecząc zyski energetyczne wynikające ze skrócenia magistrali.
Inżynierowie mikroelektroniki rozwiązują ten dylemat poprzez zastosowanie innowacyjnych materiałów interfejsu termicznego TIM opartych na nanorurkach węglowych oraz syntetycznych warstwach diamentowych CVD o przewodności cieplnej przewyższającej miedź pięciokrotnie. Dodatkowo w strukturze krzemowej implementowane są mikrokanły cieczowe, przez które dielektryczne chłodziwo przepływa bezpośrednio pomiędzy poszczególnymi warstwami stosu krzemowego, odbierając ciepło u samego źródła jego powstawania. Równolegle zaawansowane symulacje elementów skończonych FEM pozwalają na precyzyjne mapowanie naprężeń termosprężystych wywołanych różnicami współczynników rozszerzalności cieplnej CTE poszczególnych warstw metalu, krzemu i polimerów podkładowych, zapobiegając mikropęknięciom połączeń TSV podczas wieloletniej, nieprzerwanej eksploatacji w warunkach ekstremalnego obciążenia obliczeniowego.
Koherentne protokoły magistral międzychipletowych: CXL 3.1 i UCIe w ekosystemie PIM
Praktyczne wdrożenie pamięci PIM w skali klastra wymaga również standaryzacji interfejsów komunikacyjnych łączących heterogeniczne komponenty od różnych producentów krzemu. Tradycyjne protokoły magistrali PCIe, obarczone wysokim narzutem programowym i brakiem natywnej koherencji pamięci podręcznej, zostały zastąpione przez otwarte standardy Compute Express Link CXL w wersji 3.1 oraz Universal Chiplet Interconnect Express UCIe. Standardy te umożliwiają dynamiczne współdzielenie i łączenie puli pamięci PIM pomiędzy setkami akceleratorów bez konieczności pośrednictwa systemu operacyjnego.
Dzięki protokołom koherentnym CXL akcelerator PIM może bezpośrednio odpytywać komórki pamięci znajdujące się w innym module klastra, traktując całą infrastrukturę pamięciową centrum danych jako jedną, spójną przestrzeń adresową o niemal zerowych opóźnieniach sprzętowych. Zastosowanie komutatorów krzemowych CXL z obsługą wielopoziomowego routingu pozwala na elastyczne przydzielanie mocy obliczeniowej PIM do zmieniających się obciążeń treningowych, zapobiegając fragmentacji zasobów i optymalizując wskaźnik zwrotu z inwestycji kapitałowej dla operatorów chmur obliczeniowych. W ten sposób pamięć wewnątrzprocesorowa przestaje być jedynie lokalną modyfikacją pojedynczego układu scalonego, a staje się nowym paradygmatem architektonicznym dla całego globalnego przemysłu przetwarzania informacji.
Integracja rdzeni RISC-V z rozszerzeniami wektorowymi jako elastycznych kontrolerów PIM
Kluczowym kierunkiem w rozwoju programowalnych architektur PIM staje się wykorzystanie otwartej architektury zestawu instrukcji RISC-V, a w szczególności oficjalnego rozszerzenia wektorowego RISC-V Vector Extension RVV 1.0. W przeciwieństwie do zamkniętych i sztywnych architektur mikroprocesorowych, modułowa struktura RISC-V pozwala projektantom krzemu na dodawanie dedykowanych instrukcji niestandardowych Custom Instructions, które bezpośrednio sterują przełączaniem banków DRAM i aktywacją wbudowanych jednostek mnożących MAC bez pośrednictwa rozbudowanych układów dekodowania instrukcji x86 czy ARM.
Zastosowanie mikro-rdzeni RISC-V o powierzchni zaledwie ułamka milimetra kwadratowego, rozmieszczonych równomiernie pomiędzy strukturami pamięciowymi, zapewnia pełną elastyczność programową przy zachowaniu skrajnie niskiego poboru mocy w stanie spoczynku. Taki heterogeniczny układ pozwala na dynamiczną adaptację akceleratora do zupełnie nowych topologii sieci neuronowych, takich jak transformery ze zmienną długością kontekstu, rekurencyjne modele stanowe SSM typu Mamba czy hybrydowe sieci grafowe GNN. Dzięki temu inwestycje w infrastrukturę sprzętową PIM nie tracą na aktualności wraz z kolejnymi falami innowacji w algorytmach sztucznej inteligencji, zapewniając centrom danych długoterminową opłacalność ekonomiczną i odporność na dynamiczne zmiany rynkowe.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca
Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.