
Światowe modele symulacji fizycznej i robotyka humanoidów: Jak architektury World Models, uczenie przestrzenne 3D i wieloagentowy Sim-to-Real zamykają przepaść między generatywnym AI a robotyką ucieleśnioną
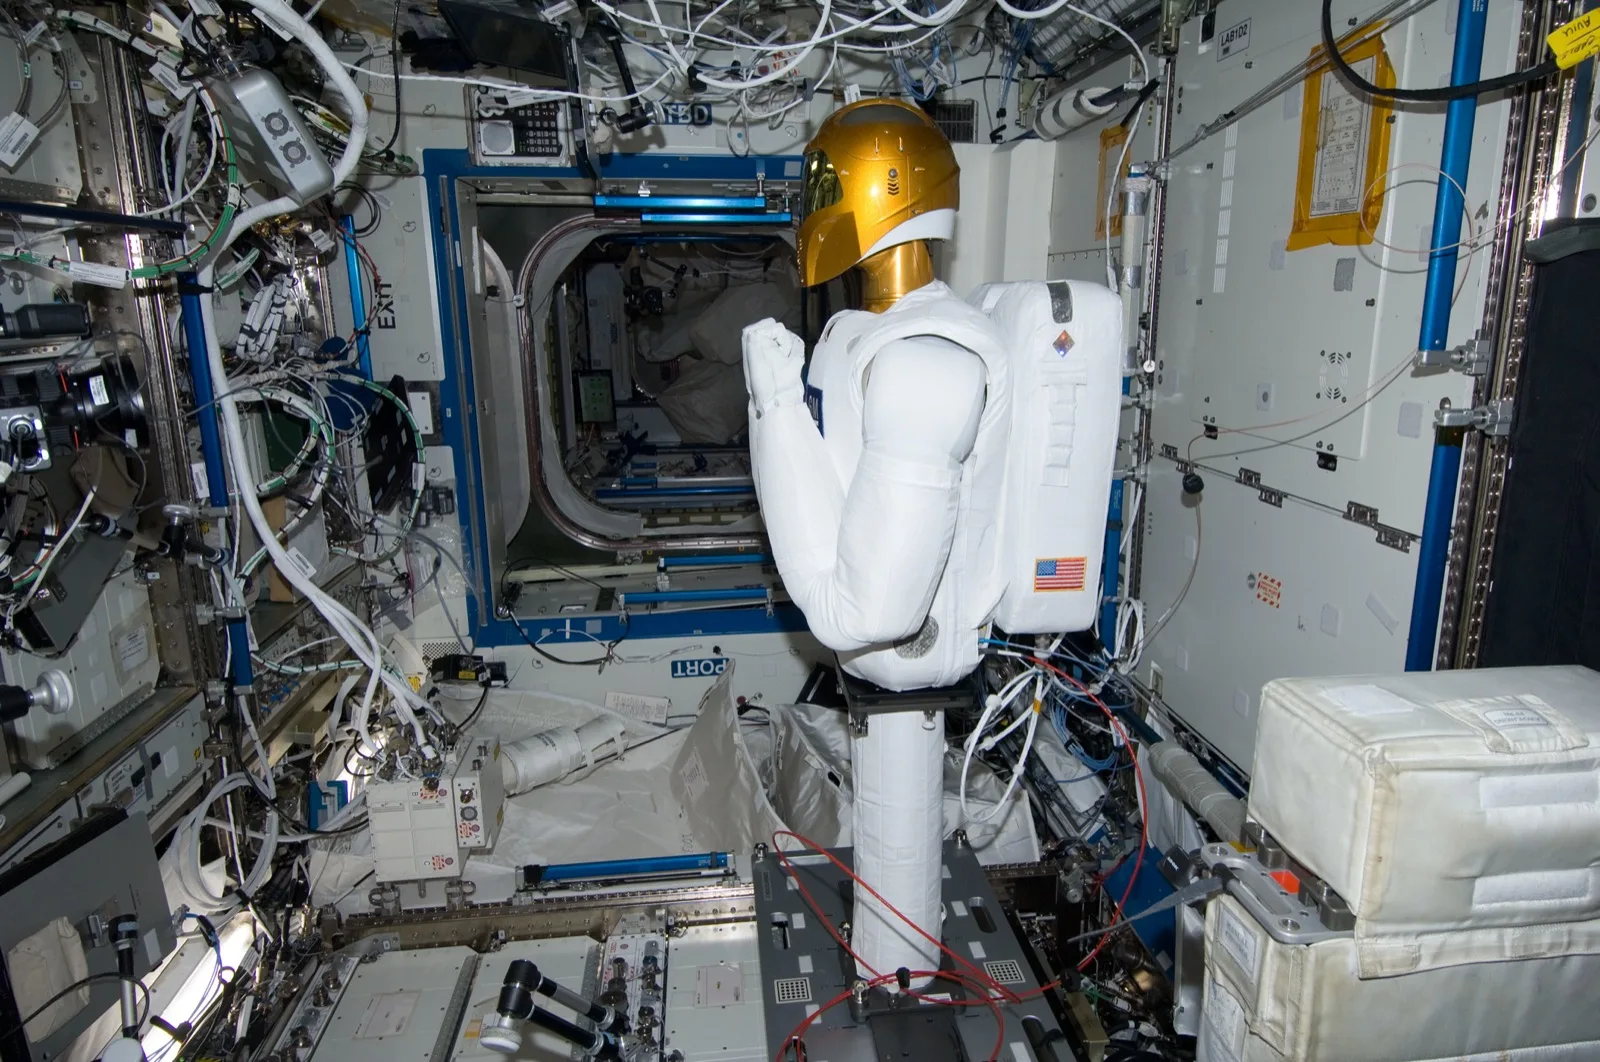
Eksplozja modeli wielkich architektur językowych LLM oraz multimodalnych generatorów obrazu i wideo zdominowała ostatnie lata debaty technologicznej, wprowadzając do powszechnego użycia systemy zdolne do pisania kodu, analizy dokumentów prawnych czy prowadzenia wielojęzycznego dialogu. Jednak w miarę jak możliwości cyfrowego rozumowania zbliżają się do granic wyznaczonych przez dostępność tekstu w Internecie, najbystrzejsze umysły sztucznej inteligencji uświadomiły sobie fundamentalne ograniczenie obecnego paradygmatu: modele językowe są odcięte od fizycznej rzeczywistości. Dziecko w wieku dwóch lat bez trudu rozumie pojęcie grawitacji, tarcie, kruchość szkła, nieodwracalność rozlania płynu czy trójwymiarową geometrię przeszkód, nie przeczytawszy w życiu ani jednego podręcznika fizyki. Współczesny model językowy z bilionem parametrów, pozbawiony ciała i zmysłów, może perfekcyjnie zdefiniować równania Naviera-Stokesa, a jednocześnie okazać się całkowicie bezradny przy próbie włożenia wtyczki do kontaktu.
To dramatyczne pęknięcie pomiędzy inteligencją symboliczną a motoryczną, znane w robotyce jako paradoks Moraveca, staje się obecnie areną największego przełomu naukowego dekady. Na styku generatywnych modeli wideo, geometrii różniczkowej, symulacji wieloagentowych i mechatroniki precyzyjnej rodzi się nowy paradygmat: ucieleśniona sztuczna inteligencja Embodied AI napędzana przez modele świata World Models. Modele świata to architektury uczenia głębokiego, które nie ograniczają się do przewidywania kolejnego tokena tekstowego, lecz budują wewnętrzną, probabilistyczną reprezentację czterowymiarowej czasoprzestrzeni, przewidując skutki działań fizycznych zanim robot poruszy jakimkolwiek siłownikiem.
Od generowania pikseli do reprezentacji przyczynowej JEPA
Początki modeli świata w uczeniu maszynowym wiązały się z modelami generatywnymi operującymi bezpośrednio na pikselach obrazu, takimi jak modele dyfuzyjne znane z generowania wideo czy wczesne rekurencyjne sieci neuronowe ze sprzężeniem zwrotnym. Podejście to, choć wizualnie spektakularne, obarczone jest potężną wadą obliczeniową: model próbujący przewidzieć każdy pojedynczy piksel kolejnej klatki wideo marnuje gigantyczne zasoby na modelowanie szumu sensorycznego, ruchu liści na wietrze czy refleksów światła na lakierze, zamiast skupić się na niezmiennych prawach mechaniki i relacjach geometrycznych.
Odpowiedzią na ten impas stała się koncepcja architektur predykcji osadzonych w przestrzeni latentnej JEPA od Joint Embedding Predictive Architecture, rozwijana intensywnie przez zespół Yanna LeCuna w Meta AI. W architekturze JEPA model nie próbuje rekonstruować szczegółów fotometrycznych sceny. Zamiast tego koder przetwarza wejściowy strumień wizualny do zwartej przestrzeni reprezentacji pojęciowej, a predyktor uczy się przewidywać stan tej reprezentacji w czasie pod wpływem wektora akcji motorycznej robota.
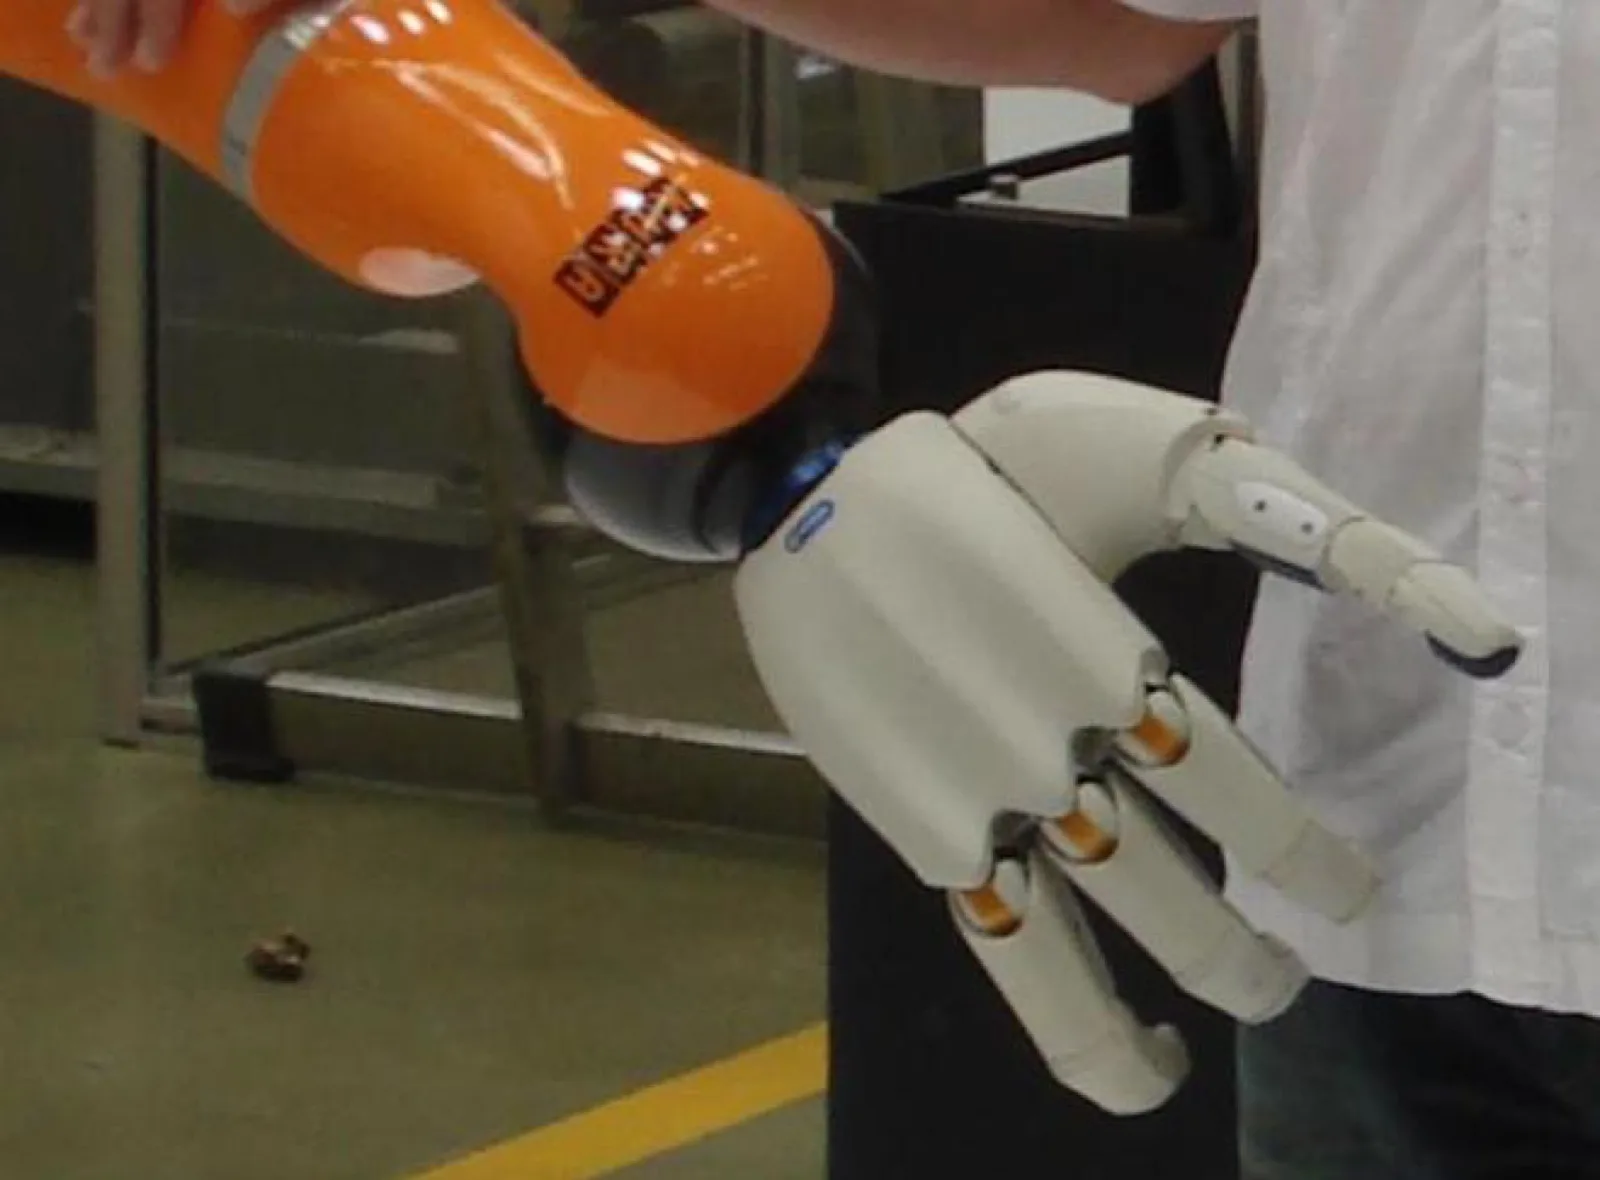
Dzięki temu robot operujący na modelu JEPA nie zastanawia się nad kolorem cienia rzucanego przez kubek, lecz koduje fundamentalne własności fizyczne: fakt, że kubek jest sztywnym ciałem stałym o określonej masie i środku ciężkości, posiadającym otwartą krawędź u góry i podatnym na przewrócenie przy przyłożeniu siły bocznej powyżej określonego momentu obrotowego. Pozwala to na planowanie sekwencji manipulacji w przestrzeni latentnej z prędkością setek symulacji na sekundę, eliminując ryzyko kosztownych kolizji w świecie rzeczywistym.
Architektury Vision-Language-Action i tokenizacja motoryki ciągłej
Drugim filarem rewolucji ucieleśnienia są modele łączące widzenie, język i działanie, znane powszechnie jako VLA od Vision-Language-Action Models, zapoczątkowane przez projekty Google DeepMind RT-1 oraz RT-2, a obecnie rozwijane w ramach globalnej inicjatywy Open X-Embodiment. Podstawowym wyzwaniem w unifikacji modeli językowych z robotyką była fundamentalna sprzeczność w naturze danych: podczas gdy tekst jest zbiorem dyskretnych symboli tokenów, sterowanie robotem wymaga generowania ciągłych trajektorii wielowymiarowych w przestrzeni konfiguracyjnej.
Rozwiązaniem okazała się sprytna dyskretyzacja i tokenizacja wektorów sterowania. Trajektoria końcówki robota End-Effector o sześciu stopniach swobody – obejmująca pozycję kartezjańską w osiach x, y i z, orientację kątową kątów Eulera roll, pitch i yaw oraz stan otwarcia chwytaka – jest dzielona na dwieście pięćdziesiąt sześć dyskretnych przedziałów binarnych. W ten sposób sygnały motoryczne stają się po prostu kolejnymi tokenami w słowniku modelu transformerowego, dokładnie takimi samymi jak słowa w języku naturalnym.
Model VLA przyjmuje jako wejście obraz z kamer robota oraz polecenie w języku naturalnym na przykład podnieś czerwoną puszkę i postaw ją na górnej półce, a następnie bezpośrednio generuje ciąg tokenów akcji. Co najbardziej fascynujące, dzięki wykorzystaniu gigantycznej wiedzy semantycznej nabytej podczas pretreningu internetowego, model wykazuje zdolność do emergencji i uogólniania: potrafi zmanipulować przedmiot, którego nigdy wcześniej nie widział w trakcie treningu robotycznego, dedukując jego przeznaczenie i sposób chwytu z kontekstu wizualnego i językowego.
Przestrzenne widzenie 3D: Od chmur punktów do 3D Gaussian Splatting
Kluczowym elementem każdego modelu świata jest zdolność do błyskawicznego przekształcania płaskiego obrazu z kamer pokładowych w precyzyjną, metryczną mapę otoczenia w czasie rzeczywistym. Tradycyjne metody fotogrametrii i rekonstrukcji wielowidokowej oparte na chmurach punktów oraz siatkach wielokątów Mesh były zbyt wolne i podatne na błędy okluzji, aby obsłużyć dynamiczne ruchy humanoida poruszającego się w nieznanym pomieszczeniu.
Prawdziwą rewolucję w percepcji przestrzennej przyniosło zaadaptowanie technologii neuronowych pól promienistości NeRF oraz ich nowocześniejszego następcy – 3D Gaussian Splatting 3DGS. W podejściu 3DGS przestrzeń wokół robota jest reprezentowana nie jako statyczna siatka geometryczna, lecz jako zbiór milionów anizotropowych, trójwymiarowych elipsoid Gaussa, z których każda posiada określone położenie, orientację, skalę, kolor oraz nieprzezroczystość.
Dzięki zastosowaniu wysoce zoptymalizowanych algorytmów rasteryzacji na układach graficznych GPU zintegrowanych na pokładzie robota, 3D Gaussian Splatting pozwala na ciągłą rekonstrukcję i renderowanie fotorealistycznej geometrii sceny z częstotliwością ponad sześćdziesięciu klatek na sekundę. Co najważniejsze dla modeli świata, reprezentacja ta jest w pełni różniczkowalna Differentiable Representation. Oznacza to, że błędy przewidywania fizycznego mogą być bezpośrednio propagowane wstecznie przez koder percepcyjny, umożliwiając robotowi ciągłą autokorektę swojego wewnętrznego modelu geometrii stołu, przeszkód na podłodze czy położenia manipulowanych narzędzi w trakcie wykonywania zadania.
Przepaść Sim-to-Real i potęga wielkoskalowej randomizacji domenowej
Największym historycznym przekleństwem robotyki manipulacyjnej i lokomocyjnej była tak zwana przepaść rzeczywistości Reality Gap. Algorytm uczenia przez wzmacnianie Reinforcement Learning wytrenowany w symulatorze komputerowym, w którym fizyka jest idealna, tarcie niezmienne, a odczyty sensorów pozbawione opóźnień i szumów, niemal zawsze ponosił spektakularną porażkę w momencie wdrożenia na fizycznym robocie. W rzeczywistym świecie luzy na przekładniach, spadek napięcia w akumulatorze, zmienna wilgotność powietrza czy mikroskopijne nierówności podłoża prowadzą do natychmiastowej utraty stabilności i upadku maszyny.
Rozwiązaniem tego dylematu stało się połączenie gigantycznych farm symulacyjnych pracujących na silnikach GPU – takich jak NVIDIA Isaac Sim oparty na platformie Omniverse czy Google MuJoCo – z techniką wielkoskalowej randomizacji domenowej Domain Randomization. Zamiast trenować robota w jednym, precyzyjnie wymodelowanym środowisku wirtualnym, model świata uczy się w milionach równoległych instancji symulacji, w których parametry fizyczne są celowo i losowo zaburzane w szerokich granicach.
W jednym świecie wirtualnym grawitacja jest o dziesięć procent wyższa, w innym tarcie podłoża odpowiada lodowisku, w kolejnym masa dłoni robota jest sztucznie zwiększona o pół kilograma, a opóźnienie w szynie komunikacyjnej CAN waha się od pięciu do pięćdziesięciu milisekund. Polityka sterowania neuronalnego wytrenowana w tak ekstremalnie zróżnicowanym krajobrazie dynamicznym przestaje polegać na precyzyjnych założeniach fizycznych, a wykształca odporną, adaptacyjną strategię motoryczną. Gdy robot staje na prawdziwej podłodze w magazynie, rzeczywistość jest dla niego po prostu kolejną, łagodną wariacją znaną z symulacji, co pozwala na bezbłędny transfer zerostrzałowy Zero-Shot Sim-to-Real Transfer.
Sterowanie niskopoziomowe: Sterowanie impedancyjne i optymalizacja całego ciała WBC
Podczas gdy model świata planuje trajektorie na poziomie wysokim, rzeczywiste wykonanie ruchu wymaga ultra-szybkiej pętli sterowania niskopoziomowego działającej z częstotliwością co najmniej jednego kiloherca na procesorach czasu rzeczywistego RT-Linux. W robotyce humanoidalnej sztywne sterowanie pozycyjne znane ze starych maszyn fabrycznych prowadzi do katastrofy: jeśli ramię robota natrafi na nieprzewidzianą przeszkodę, próba osiągnięcia zadanej pozycji skutkuje połamaniem mechanizmu lub zniszczeniem otoczenia.
Nowoczesne roboty wykorzystują sterowanie impedancyjne Impedance Control oraz sterowanie admitancyjne. W tym reżimie siłowniki nie zachowują się jak nieustępliwe siłowniki hydrauliczne, lecz jak wirtualne sprężyny i tłumiki o dynamicznie regulowanej sztywności. Gdy robot wchodzi w kontakt z człowiekiem lub dotyka blatu, mechanika naturalnie ustępuje, absorbując energię kinetyczną.
Na szczycie tej architektury operują solwery sterowania całym ciałem Whole-Body Control WBC, oparte na programowaniu kwadratowym Quadratic Programming QP. Solwer w czasie rzeczywistym rozwiązuje problem optymalizacji z więzami, równoważąc jednocześnie dziesiątki sprzecznych celów: utrzymanie punktu zerowego momentu Zero-Moment Point ZMP wewnątrz wielokąta podparcia stóp, uniknięcie przekroczenia maksymalnych momentów obrotowych silników, ominięcie osobliwości kinematycznych oraz precyzyjne śledzenie pozycji dłoni manipulującej narzędziem. W przypadku nagłego pchnięcia przez człowieka solwer natychmiast rekonfiguruje obciążenia wszystkich stawów, dynamicznie przestawiając stopę do kroku kompensacyjnego bez przerywania operacji trzymanego obiektu.
Platformy sprzętowe nowej generacji: Figure 02, Tesla Optimus i Boston Dynamics Atlas
Równolegle do postępów w algorytmach modeli świata dokonał się gigantyczny skok w konstrukcji mechanicznej samych robotów humanoidalnych. Poprzednia generacja maszyn badawczych – takich jak japoński ASIMO czy wczesne wersje Atlasa – opierała się na potężnych, głośnych i podatnych na wycieki układach hydraulicznych, sterowanych sztywnymi algorytmami dynamiki odwrotnej. Dzisiejsze roboty to w pełni elektryczne, ciche i zintegrowane platformy mechatroniczne projektowane z myślą o seryjnej produkcji przemysłowej.
Model Figure 02, zaprezentowany przez kalifornijski startup Figure AI współpracujący z OpenAI i BMW, stanowi szczytowe osiągnięcie w dziedzinie integracji modeli wielkich sieci multimodalnych z biomechaniką. Maszyna posiada dwadzieścia stopni swobody w samym tułowiu i nogach oraz szesnaście stopni swobody w dłoniach, wykorzystując zminiaturyzowane siłowniki elektromechaniczne oparte na silnikach bezszczotkowych BLDC z przekładniami falowymi Harmonic Drive oraz wbudowanymi czujnikami momentu obrotowego. Zintegrowane mikrofony i kamery RGB o szerokim kącie widzenia połączone z modelami percepcji pozwalają Figure 02 na autonomiczną pracę na linii produkcyjnej fabryki samochodów, gdzie robot pobiera i precyzyjnie pozycjonuje elementy blacharskie z tolerancją poniżej milimetra.
Z kolei Tesla intensywnie rozwija platformę Optimus Gen 2 i Gen 3, czerpiąc z doświadczeń produkcyjnych gigafabryk samochodowych. Optimus wyróżnia się unikalnymi, autorskimi siłownikami liniowymi i obrotowymi zintegrowanymi z elektroniką mocy bezpośrednio w strukturze kości nośnych ze stopów tlenku aluminium. Najbardziej zaawansowanym elementem konstrukcyjnym Tesli są dłonie wyposażone w jedenaście stopni swobody z napędem linkowym, w których każdy opuszek palca posiada sensory dotykowe oparte na elastycznych matrycach pojemnościowych, zdolne do bezpiecznego chwytania zarówno surowego jajka, jak i ciężkiego klucza pneumatycznego.
Wreszcie, legendarna firma Boston Dynamics dokonała historycznego zwrotu, całkowicie wycofując hydraulicznego Atlasa na rzecz w pełni elektrycznego humanoida nowej generacji. Nowy Atlas posiada unikalne, nieograniczone przeguby obrotowe o kącie obrotu trzystu sześćdziesięciu stopni w stawach biodrowych, kolanowych i ramionach, co pozwala maszynie na wykonywanie manewrów niemożliwych dla ludzkiej anatomii, takich jak wstawanie z podłogi poprzez płynny obrót miednicy bez konieczności odwracania całego korpusu.
Sensoryka dotykowa i sztuczna skóra: Mechanoreceptory w krzemie
Jednym z najtrudniejszych problemów ucieleśnienia pozostaje zmysł dotyku. Człowiek manipulujący przedmiotami w ciemności opiera się niemal wyłącznie na mechanoreceptorach skóry – ciałkach Meissnera, Paciniego, Ruffiniego i tarczkach Merkela – które rejestrują nie tylko statyczny nacisk, ale przede wszystkim mikrowibracje towarzyszące początkowi poślizgu przedmiotu w dłoni. Tradycyjne chwytaki robotyczne wyposażone w pojedyncze czujniki siły F/T w nadgarstku były ślepe na te zjawiska, co zmuszało inżynierów do stosowania nadmiernej siły ścisku grożącej zgnieceniem delikatnych obiektów.
Przełomem w sensoryce dotykowej stały się optyczne sensory dotykowe oparte na kamerach elastomerowych, takie jak GelSight oraz TacTip. W sensorach tych opuszek palca robota stanowi przezroczysta kopułka z elastomeru silikonowego pokryta od zewnątrz elastyczną warstwą odblaskową z mikroskopijnymi znacznikami geometrycznymi. Wewnątrz palca miniaturowa kamera rejestruje odkształcenia elastomeru pod wpływem kontaktu z przedmiotem, a sieć konwolucyjna CNN przekształca ten obraz w trójwymiarową mapę sił nacisku i wektorów tarcia z mikrometrową rozdzielczością przestrzenną.
Równolegle rozwijana jest piezorezystywna i pojemnościowa sztuczna skóra neuromorficzna Neuromorphic Electronic Skin, w której impulsy elektryczne są generowane w sposób asynchroniczny, naśladując potencjały czynnościowe ludzkich nerwów obwodowych. W połączeniu z modelami świata informacja dotykowa pozwala robotowi na natychmiastowe korygowanie siły chwytu w ułamku milisekundy w momencie wykrycia mikroskopijnego poślizgu, umożliwiając manipulowanie mokrymi, śliskimi czy podatnymi na deformację obiektami z gracją dorównującą ludzkiej dłoni.
World Labs Feifei Li i nowa fala modeli przestrzennych
Świadectwem wagi modeli świata stało się spektakularne wejście na scenę startupu World Labs, założonego przez profesor Feifei Li – pionierkę sztucznej inteligencji i twórczynię bazy ImageNet, która dała początek rewolucji głębokiego uczenia. World Labs w rekordowym tempie pozyskało setki milionów dolarów finansowania od czołowych funduszy venture capital, stawiając sobie za cel zbudowanie wielkich modeli przestrzennych Large World Models LWM zdolnych do rozumowania o trójwymiarowej geometrii, dynamice płynów, plastyczności materiałów i ciągłości czasowej.
W przeciwieństwie do tradycyjnych modeli wizyjnych, które generują obrazy w przestrzeni dwuwymiarowej bez zrozumienia głębi, architektury World Labs traktują trójwymiarowy świat jako pierwotny aksjomat obliczeniowy. Model Li uczy się z gigantycznych repozytoriów danych przestrzennych LiDAR, skanów fotogrametrycznych oraz symulacji syntetycznych, budując reprezentację zdolną do generowania spójnych, interaktywnych środowisk 3D na podstawie pojedynczego zdjęcia lub opisu tekstowego. Dla robotyki oznacza to możliwość błyskawicznego wyobrażenia sobie niewidocznej części pokoju czy wnętrza szafki, zanim robot w ogóle do niej podejdzie.
Wyzwania przemysłowe i geopolityczne: Wojna o łańcuchy dostaw robotyki
Przejście od laboratoryjnych prototypów do masowej komercjalizacji humanoidalnych robotów pracujących w fabrykach, centrach logistycznych i domach opieki rodzi potężne napięcia geopolityczne i gospodarcze. Podobnie jak w przypadku półprzewodników i baterii litowych, świat staje w obliczu bezwzględnej rywalizacji pomiędzy Stanami Zjednoczonymi a Chińską Republiką Ludową o dominację nad łańcuchem dostaw komponentów mechatronicznych.
Chiny, dysponując bezkonkurencyjnym ekosystemem produkcyjnym w prowincji Guangdong i delcie rzeki Jangcy, kontrolują ponad siedemdziesiąt procent globalnej produkcji precyzyjnych przekładni cykloidalnych, miniaturowych silników bezszczotkowych, magnesów neodymowych NdFeB oraz baterii litowo-żelazowo-fosforanowych LFP niezbędnych do zasilania robotów. Chińskie Ministerstwo Przemysłu i Technologii Informacyjnych MIIT opublikowało oficjalną strategię narodową, stawiając sobie za cel masową produkcję robotów humanoidalnych przed końcem 2026 roku i osiągnięcie światowego przywództwa w tej dziedzinie przed rokiem 2030, wspierając państwowych czempionów takich jak Fourier Intelligence, Unitree czy AgiBot.
W odpowiedzi Stany Zjednoczone dążą do utrzymania przewagi w obszarze krzemowych procesorów wnioskowania na krawędzi sieci Edge AI, systemów operacyjnych oraz fundamentowych modeli świata, dążąc jednocześnie do reonshoringu precyzyjnej obróbki mechanicznej i produkcji stopów tytanowych. Kraj, który jako pierwszy osiągnie zdolność do masowego wdrażania tanich, niezawodnych robotów ogólnego przeznaczenia, zyska asymetryczną przewagę w produktywności przemysłowej, neutralizując kryzys demograficzny i starzenie się społeczeństwa.
Nowy świt robotyki ogólnego przeznaczenia
Połączenie modeli świata ze zwinnymi, elektrycznymi platformami humanoidalnymi wyznacza koniec ery sztywnej automatyzacji przemysłowej, w której roboty były niebezpiecznymi, odizolowanymi klatkami ramionami potrafiącymi powtarzać jedynie z góry zaprogramowaną trajektorię w milimetrowo skalibrowanym otoczeniu. Wkraczamy w erę robotyki ogólnego przeznaczenia General Purpose Robotics, w której maszyna rozumie strukturę otoczenia, adaptuje się do nieprzewidzianych zmian i uczy się nowych zadań poprzez obserwację ludzkich demonstracji lub eksplorację w symulacji.
Przekształcenie generatywnego AI z gadającego programu komputerowego w fizycznego agenta zdolnego do manipulowania materią to ostateczny krok na drodze do stworzenia ogólnej sztucznej inteligencji AGI. W świecie, w którym komputery zyskują nie tylko wzrok i słuch, ale dłonie, nogi i intuicyjne rozumienie praw fizyki, definicja pracy, przemysłu i relacji człowieka z technologią zostanie napisana na nowo.
Przełamywanie luki sim-to-real i randomizacja domenowa w silnikach fizycznych nowej generacji
Kluczową barierą uniemożliwiającą bezpośrednie przeniesienie modeli świata wyszkolonych w środowiskach wirtualnych na fizyczne platformy wykonawcze jest tak zwana luka rzeczywistości, czyli sim-to-real gap. Żadna numeryczna symulacja oparta na klasycznych równaniach dynamiki bryły sztywnej nie jest w stanie w pełni odzwierciedlić mikroskopijnych fluktuacji tarcia, nieliniowych odkształceń elastycznych elastomerów na opuszkach palców, luzów międzyzębnych w miniaturowych przekładniach falowych czy opóźnień w magistralach komunikacyjnych EtherCAT. Przez lata inżynierowie próbowali kalibrować parametry symulacji z laboratoryjną precyzją, co okazywało się syzyfową pracą skazaną na porażkę przy pierwszej zmianie wilgotności powietrza lub zużyciu mechanicznym łożysk.
Przełom przyniosło połączenie zaawansowanych technik randomizacji domenowej z generatywnymi modelami świata. W nowoczesnych klastrach obliczeniowych opartych na akceleratorach graficznych silniki fizyki równoległej, takie jak Isaac Sim czy najnowsze implementacje MuJoCo XLA, generują miliony równoległych wariantów tego samego zadania manipulacyjnego. W każdym z tych wirtualnych wątków parametry środowiska są celowo zaburzane w losowych granicach. Algorytmy zmieniają masę przenoszonych obiektów, współczynniki tarcia statycznego i kinetycznego, sztywność przegubów, a nawet dodają sztuczny szum do pomiarów z enkoderów optycznych i jednostek IMU. Model świata, zamiast uczyć się jednej idealnej trajektorii, jest zmuszony do wygenerowania reprezentacji odpornej na niepewność pomiarową i parametryczną.
Co więcej, najnowsze generatywne modele wideo pozwalają na fotorealistyczne nakładanie tekstur i warunków oświetleniowych w czasie rzeczywistym. Oznacza to, że sieć neuronowa odpowiedzialna za percepcję wzrokową trenuje nie na uproszczonych modelach geometrycznych, lecz na fotorealistycznych scenach uwzględniających refleksy światła, zniekształcenia soczewek kamer, cienie rzucane przez dynamiczne przeszkody oraz zakłócenia wynikające z kurzu osiadającego na matrycach optycznych. W efekcie robot po wyjęciu z fabrycznego opakowania i postawieniu w nieznanym magazynie lub hali produkcyjnej nie doświadcza szoku dystrybucyjnego, ponieważ przestrzeń zmienności fizycznego świata mieści się wewnątrz hiperprzestrzeni, którą model zwiedził podczas treningu w klastrze GPU.
Ekonomia skali, bezpieczeństwo funkcjonalne i horyzont wdrożeniowy
Wdrożenie ucieleśnionych modeli świata w fabrykach i przestrzeniach publicznych stawia przed inżynierami bezprecedensowe wymagania z zakresu bezpieczeństwa funkcjonalnego. W przeciwieństwie do robotów przemysłowych zamkniętych w klatkach bezpieczeństwa, humanoidy poruszają się w tym samym środowisku co ludzie. Zderzenie stutrzydziestokilogramowej konstrukcji ze stalowym szkieletem przy prędkości dwóch metrów na sekundę niesie ze sobą śmiertelne zagrożenie. Z tego względu architektura oprogramowania wymaga ścisłego rozdzielenia warstwy kognitywnej od deterministycznych układów zabezpieczających.
W nowoczesnych konstrukcjach generatywny model świata działa jako doradca planujący trajektorie o wysokim poziomie abstrakcji, lecz każdy sygnał sterujący musi przejść przez certyfikowaną warstwę barier ochronnych, tak zwanych Control Barrier Functions. Te matematyczne filtry działają z częstotliwością kilkunastu kiloherców na dedykowanych mikrokontrolerach czasu rzeczywistego i gwarantują, że polecenia generowane przez sieć neuronową nie naruszą zdefiniowanych ograniczeń kinematycznych, dopuszczalnych sił nacisku oraz stref bezpieczeństwa wokół współpracowników ludzkich. Jeśli model neuronowy zaproponuje trajektorię grożącą kolizją lub utratą stabilności dynamicznej, filtr natychmiast modyfikuje momenty obrotowe, sprowadzając maszynę do bezpiecznego stanu zatrzymania lub kontrolowanego odzyskania równowagi.
Z punktu widzenia ekonomicznego znajdujemy się w punkcie zwrotnym. Koszt wytworzenia jednostki humanoidalnej, zdominowany przez precyzyjne silniki bezszczotkowe, stopy tytanu, włókna węglowe i lidary półprzewodnikowe, spada z roku na rok w tempie przekraczającym dwadzieścia procent. Jednak prawdziwą wartością nie jest sam sprzęt, lecz oprogramowanie kognitywne. Firmy, które zgromadzą największe korpusy danych z fizycznych interakcji i wytrenują najbardziej wszechstronne modele świata, staną się właścicielami cyfrowego układu nerwowego globalnej gospodarki. Wkraczamy w erę, w której maszyny przestają być zaprogramowanymi automatami wykonującymi powtarzalne cykle, a stają się autonomicznymi podmiotami zdolnymi do głębokiego rozumienia i przekształcania materii.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.