
Rewolucja modeli typu Jev. Jak TypeSafe AI i Diogo Almeida odrzucili czat na rzecz maszynowych decyzji Systemu Pierwszego
Przez ostatnie cztery lata branża sztucznej inteligencji żyła w niemal całkowitym przekonaniu, że uniwersalnym interfejsem dla wszystkich problemów obliczeniowych ludzkości jest okno dialogowe oraz autoregresyjny model językowy generujący tekst słowo po słowie. Inżynierowie oprogramowania na całym świecie próbowali zaprząc czatboty do zadań czysto infrastrukturalnych: od filtrowania i klasyfikacji poczty elektronicznej, przez routing zapytań w architekturach mikrousługowych, aż po podejmowanie krytycznych decyzji w pętlach sterowania autonomicznych agentów. Efekt tych starań okazał się jednak bolesnym zderzeniem z rzeczywistością inżynieryjną. Zmuszanie modeli zoptymalizowanych pod kątem ludzkiej konwersacji do pełnienia roli deterministycznych silników decyzyjnych ujawniło szereg fundamentalnych wad paradygmatu generatywnego, w tym destrukcyjną dla systemów produkcyjnych latencję, absurdalnie wysokie koszty wnioskowania oraz nieustanną podatność na halucynacje formatowe i semantyczne.
Przełom nadszedł jesienią 2026 roku za sprawą amerykańskiego laboratorium TypeSafe AI z San Francisco. Zaprezentowana przez zespół architektura Jev nie stanowi kolejnej ewolucyjnej wersji znanego modelu językowego z kilkoma dodatkowymi miliardami parametrów, lecz jest radykalnym zerwaniem z dotychczasowym dogmatem tokenizacji i generowania tekstu. Zamiast silić się na elokwentną prozę, Jev nie potrafi wygenerować ani jednego zdania. Jest to wyspecjalizowany model decyzji maszynowych, który w ułamku sekundy przetwarza dowolny stan wejściowy i zwraca ściśle stypizowane, zwalidowane wartości logiczne, numeryczne lub kategoryczne wraz z matematycznie precyzyjną kalibracją prawdopodobieństwa. Reakcja Doliny Krzemowej była natychmiastowa. Kilka tygodni po wyjściu z fazy utajnienia i pozyskaniu rundy zalążkowej w wysokości czterdziestu milionów dolarów od funduszu DCVC, TypeSafe AI zamknęło gigantyczną rundę finansowania Serii A o wartości ośmiuset siedemdziesięciu milionów dolarów pod przewodnictwem Andreessen Horowitz oraz Sequoia Capital, osiągając astronomiczną wycenę na poziomie siedmiu i pół miliarda dolarów.
Koniec złudzeń wokół czatbotów w infrastrukturze backendowej
Aby w pełni zrozumieć, dlaczego pojawienie się modeli typu Jev wywołało tak gigantyczne poruszenie wśród architektów oprogramowania enterprise, należy cofnąć się do genezy problemu, z jakim boryka się współczesna inżynieria danych. W tradycyjnym modelu generatywnym każde zadanie decyzyjne – nawet tak banalne jak odpowiedź na pytanie, czy dany e-mail stanowi próbę phishingu – wymagało zainicjowania pełnego cyklu wnioskowania autoregresyjnego. Model musiał krok po kroku generować tokeny tekstu, formatować je w składnię JSON, a następnie parser po stronie serwera aplikacyjnego modlił się, aby w strumieniu danych nie pojawił się niespodziewany przecinek, ucięty nawias klamrowy lub niepotrzebny komentarz wstępny w stylu naturalnym.
Cały przemysł IT przez lata próbował łatać ten problem protezami inżynieryjnymi. Tworzono wyspecjalizowane biblioteki do sterowania gramatyką, maskowano prawdopodobieństwa tokenów na poziomie próbkowania za pomocą reguł formalnych BNF, a najwięksi dostawcy chmurowi wprowadzali funkcje wymuszonego formatowania JSON. Wszystkie te rozwiązania maskowały jedynie objawy, nie dotykając źródła problemu. Klasyczny model językowy jest z natury maszyną do zgadywania kolejnego najbardziej prawdopodobnego fragmentu tekstu w przestrzeni lingwistycznej. Zmuszanie go do symulowania twardej logiki biznesowej przypominało używanie traktora do precyzyjnego zegarmistrzostwa. Koszt operacyjny takiego podejścia był druzgocący. Typowe zapytanie decyzyjne do dużego modelu frontier pochłaniało od pięciuset milisekund do nawet kilku sekund, a rachunki za zużycie pamięci podręcznej i przetwarzanie tokenów wyjściowych w chmurach obliczeniowych drenowały budżety przedsiębiorstw.
Co gorsza, modele generatywne cierpią na chroniczną niezdolność do uczciwego komunikowania własnej niewiedzy. Zjawisko halucynacji w kontekście konwersacyjnym bywa zabawne lub irytujące, lecz w architekturze backendowej jest katastrofą. Gdy system antyfraudowy lub moduł automatycznego zatwierdzania przelewów otrzymuje odpowiedź twierdzącą wygenerowaną wyłącznie na skutek statystycznego dryfu wag modelu, konsekwencje finansowe i prawne obciążają bezpośrednio firmę wdrażającą technologię. Branża desperacko potrzebowała narzędzia, które potrafi myśleć szybko, kategorycznie i z mierzalnym stopniem pewności, całkowicie pomijając etap werbalizacji.
Od badań nad RLHF w OpenAI do narodzin paradygmatu Systemu Pierwszego
Za koncepcją stojącą za modelami typu Jev stoi postać, której wkład w rozwój nowoczesnej sztucznej inteligencji jest trudny do przecenienia. Założycielem i dyrektorem generalnym TypeSafe AI jest Diogo Almeida, wybitny brazylijski badacz, który spędził niemal cztery lata w laboratoriach OpenAI w San Francisco. Almeida był jednym z kluczowych współtwórców metodologii uczenia ze sprzężeniem zwrotnym od ludzi, znanej powszechnie jako RLHF, oraz bezpośrednim architektem przełomowych projektów InstructGPT, pierwotnego ChatGPT oraz GPT-4. Wraz z nim firmę współtworzą inni uznani inżynierowie systemowi, w tym Erik Gafni oraz Sasha Sheng.
To właśnie bezpośrednie doświadczenie z wdrażaniem modeli konwersacyjnych na skalę setek milionów użytkowników doprowadziło Almeidę do fundamentalnego wniosku: dialog jest fenomenalnym interfejsem dla ludzi, lecz fatalnym dla oprogramowania. Komputery nie komunikują się ze sobą za pomocą zdań złożonych, metafor czy uprzejmości. Oprogramowanie wymienia między sobą ściśle zdefiniowane stany, typy danych, kody błędów i flagi binarne. Próba wciśnięcia lingwistycznego pośrednika pomiędzy dwie usługi sieciowe była błędem architektonicznym popełnionym z braku lepszych alternatyw.
Projektując architekturę Jev, Almeida odwołał się bezpośrednio do teorii procesów poznawczych Daniela Kahnemana, laureata Nagrody Nobla w dziedzinie ekonomii i autora klasycznego dzieła o pułapkach myślenia. Kahneman podzielił ludzki umysł na dwa współpracujące tryby: System Pierwszy, działający automatycznie, szybko, intuicyjnie i bez wysiłku werbalnego, oraz System Drugi, powolny, analityczny, wymagający skupienia i sekwencyjnego rozumowania logicznego. Podczas gdy dotychczasowy rozwój modeli frontier skupiał się na emulacji Systemu Drugiego poprzez techniki wnioskowania w łańcuchu myśli i generowanie rozwlekłych analiz krok po kroku, TypeSafe AI postanowiło zbudować pierwszy w historii czysty model Systemu Pierwszego dla oprogramowania.
Anatomia architektury Jev. Matematyczne odrzucenie pętli autoregresyjnej
Fundament technologiczny modeli typu Jev opiera się na całkowitym wyeliminowaniu tradycyjnego dekodera autoregresyjnego. W klasycznym transformatorze tekstowym proces generowania odpowiedzi jest z konieczności sekwencyjny. Model musi obliczyć reprezentację ukrytą dla pierwszego słowa, wyemitować token, dołączyć go do kontekstu wejściowego i ponownie uruchomić kosztowne obliczenia uwagi dla każdego kolejnego elementu sekwencji. Powoduje to powstawanie gigantycznego narzutu pamięciowego znanego jako KV Cache, który gwałtownie rośnie wraz z długością odpowiedzi i blokuje przepustowość akceleratorów graficznych.
Architektura Jev działa w sposób całkowicie odmienny. Zapytanie kierowane do modelu składa się z dwóch integralnych komponentów: Bloku Stanu oraz Zestawu Typowanych Pytań. Blok Stanu może być dowolnym ustrukturyzowanym lub nieustrukturyzowanym obiektem danych. Może to być surowy fragment tekstu, zrzut obiektu w formacie JSON, rekord z bazy danych, kod źródłowy, a nawet tablica wielowymiarowa reprezentująca stan sesji użytkownika. Blok Stanu jest przetwarzany przez potężny, gęsty enkoder uwagi jednorazowo, w jednym, w pełni równoległym przebiegu w przód.
W tym samym przebiegu obliczeniowym enkoder rzutuje reprezentację stanu na zdefiniowane w zapytaniu pytania prymitywne. Zamiast generować znaki tekstowe, model bezpośrednio optymalizuje wielowymiarowy rozkład prawdopodobieństw w ściśle określonych przestrzeniach docelowych. Całość operacji wnioskowania kończy się w momencie dotarcia sygnału do warstwy wyjściowej enkodera. Nie ma tu żadnej pętli zwrotnej, żadnego oczekiwania na kolejne tokeny i żadnego ryzyka, że model utknie w nieskończonej pętli powtórzeń. W rezultacie model Jev osiąga czasy odpowiedzi rzędu od dziesięciu do czterdziestu milisekund, co stanowi wynik nieosiągalny dla jakiegokolwiek wielomiliardowego modelu generatywnego operującego na tekście.
Trzy nienaruszalne prymitywy decyzyjne. Choice, Score i Noul
Jednym z najbardziej eleganckich rozwiązań zaproponowanych przez TypeSafe AI jest ograniczenie przestrzeni decyzyjnej do trzech matematycznych prymitywów. Zamiast zmuszać programistę do pisania zawiłych promptów instruujących model, jak ma wyglądać poprawny JSON, API modelu Jev operuje na natywnych typach, które silnik kompilatora może zweryfikować przed wysłaniem zapytania do klastra obliczeniowego.
Pierwszym prymitywem jest Choice, czyli kategoryczny wybór jednej opcji z jawnie zdefiniowanego, dyskretnego zbioru możliwości. Programista przesyła listę dopuszczalnych etykiet, na przykład kategorie zgłoszenia serwisowego lub ścieżki routingu płatności. Model nie wpisuje nazwy kategorii w ciele odpowiedzi, lecz oblicza bezpośredni wektor prawdopodobieństw softmax nad przekazaną listą. Zwracana jest opcja o najwyższej masie prawdopodobieństwa wraz z pełnym rozkładem statystycznym. Co najważniejsze z punktu widzenia niezawodności oprogramowania, model z przyczyn czysto matematycznych nie jest w stanie zwrócić wartości spoza zdefiniowanego zbioru. Ryzyko zwrócenia nieistniejącej kategorii spada do zera bez konieczności stosowania zewnętrznych filtrów walidacyjnych.
Drugim fundamentalnym prymitywem jest Score, służący do porządkowania i oceny badanego stanu w ramach określonej skali lub ciągłego spektrum wagowego. Prymityw ten znajduje zastosowanie w algorytmach oceny ryzyka kredytowego, wykrywania podatności w kodzie czy ustalania priorytetu zadań w kolejkach asynchronicznych. Model kalibruje ocenę na podstawie wewnętrznych reprezentacji semantycznych wyuczonych na gigantycznych zbiorach danych referencyjnych, dostarczając inżynierom stabilną metrykę numeryczną, która nie fluktuuje losowo w zależności od drobnych zmian w sformułowaniu zapytania.
Trzecim, niezwykle unikalnym elementem architektury jest prymityw Noul. Jest to wysoce wyspecjalizowana ocena prawda lub fałsz, której wynik stanowi znormalizowane prawdopodobieństwo bayesowskie w przedziale od zera do jedynki. Nazwa prymitywu odzwierciedla jego zdolność do precyzyjnego uchwycenia stanu niepewności poznawczej. W odróżnieniu od tradycyjnego typu boolean, który w systemach informatycznych przyjmuje binarną wartość zero lub jeden, Noul informuje system nadrzędny, z jaką siłą dowodową model potwierdza zachodzenie określonego warunku. Umożliwia to tworzenie progów decyzyjnych w oprogramowaniu enterprise, w których akcja krytyczna jest podejmowana automatycznie wyłącznie przy wskaźniku przekraczającym dziewięćdziesiąt dziewięć procent, a przypadki graniczne trafiają do weryfikacji operacyjnej.
Kalibracja prawdopodobieństwa jako święty Graal niezawodności systemowej
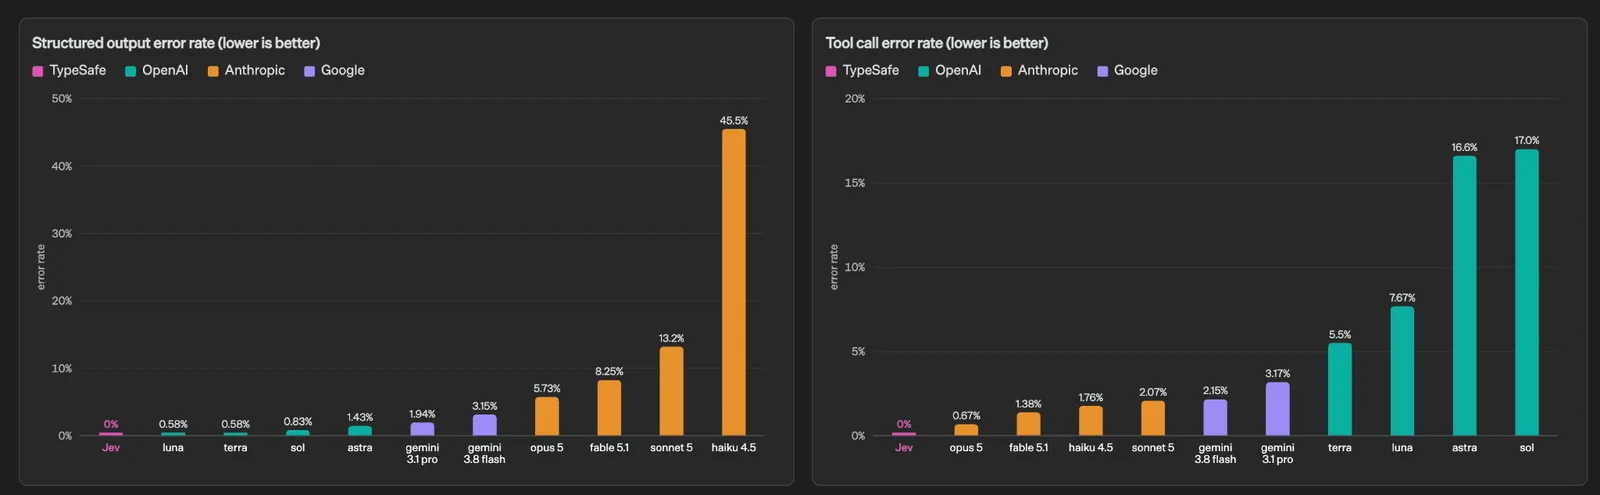
Wśród wielu zalet technicznych modeli typu Jev jedna cecha wybija się na plan pierwszy w oczach inżynierów bezpieczeństwa i architektów systemów bankowych. Jest nią rygorystyczna kalibracja prawdopodobieństwa. W klasycznych modelach językowych wartości logitów na warstwie wyjściowej są powszechnie znane ze swojej fatalnej kalibracji. Model potrafi z dziewięćdziesięciodziewięcioprocentową pewnością wygenerować całkowitą bzdurę lub halucynację, ponieważ proces dopasowywania wag w mechanizmie RLHF promuje elokwencję i asertywność wypowiedzi kosztem prawdy statystycznej.
TypeSafe AI poświęciło znaczną część swojego kapitału badawczego na rozwiązanie tego problemu u samych podstaw matematycznych. W modelach Jev wskaźnik pewności nie jest wtórnym dodatkiem lingwistycznym, lecz bezwzględnym parametrem optymalizacyjnym podczas fazy treningu wstępnego i dostrajania. Oznacza to, że jeżeli model przypisuje danej decyzji wskaźnik pewności na poziomie osiemdziesięciu procent, to w rygorystycznych testach empirycznych na próbie miliona zapytań dokładnie osiemdziesiąt procent takich decyzji okazuje się obiektywnie poprawnych.
Dla branży finansowej, ubezpieczeniowej oraz medycznej taka właściwość stanowi różnicę między bezużyteczną ciekawostką technologiczną a gotowym komponentem produkcyjnym. Systemy automatycznego audytu transakcji mogą skonfigurować precyzyjne reguły biznesowe: transakcje, w których model Jev wykazuje wskaźnik pewności oszustwa powyżej dziewięćdziesięciu ośmiu procent, są blokowane natychmiast bez udziału człowieka. Zgłoszenia z przedziału od czterdziestu do dziewięćdziesięciu procent kierowane są do analityków ryzyka z automatycznie wyodrębnionym kontekstem, a te o pewności znikomej przechodzą natychmiastowo. Znika konieczność budowania skomplikowanych heurystyk opartych na analizie sentymentu wygenerowanego tekstu.
Ekonomiczne korzenie nazwy. Jak paradoks Williama Stanleya Jevonsa zdefiniował przyszłość AI
Wielu obserwatorów rynku zastanawiało się nad genezą samej nazwy Jev. Nie jest to akronim od kolejnych terminów technicznych, lecz bezpośredni hołd złożony wybitnemu dziewiętnastowiecznemu angielskiemu ekonomiście i logikowi Williamowi Stanleyowi Jevonsowi. W tysiąc osiemset sześćdziesiątym piątym roku Jevons opublikował przełomową pracę poświęconą kwestii zasobów węglowych w dobie rewolucji przemysłowej w Wielkiej Brytanii, w której sformułował słynny aforyzm ekonomiczny, znany dziś jako paradoks Jevonsa.
Paradoks ten głosi, że wbrew intuicji postęp technologiczny zwiększający wydajność wykorzystania danego zasobu nie prowadzi do zmniejszenia jego całkowitego zużycia, lecz wręcz przeciwnie – do dramatycznego wzrostu popytu na ten zasób. Gdy silniki parowe Jamesa Watta stały się wielokrotnie bardziej wydajne energetycznie od prymitywnych maszyn Newcomena, zapotrzebowanie na węgiel nie spadło. Tani i efektywny napęd parowy stał się opłacalny w tysiącach nowych gałęzi przemysłu, co wywołało eksplozję globalnego zużycia węgla na bezprecedensową skalę.
Diogo Almeida i inwestorzy z Doliny Krzemowej dostrzegli identyczną prawidłowość w realiach współczesnego wnioskowania sztucznej inteligencji. Dopóki pojedyncze zapytanie decyzyjne do modelu AI kosztuje kilka centów i wymaga sekundy oczekiwania, przedsiębiorstwa używają sztucznej inteligencji oszczędnie, ograniczając się do powierzchownych czatbotów i doraźnych analiz dokumentów. W momencie, gdy architektura Jev obniża koszt podjęcia inteligentnej decyzji maszynowej o trzy rzędy wielkości, a czas reakcji skraca do kilkunastu milisekund, ekonomia całego oprogramowania ulega transformacji. Sztuczna inteligencja przestaje być doradcą człowieka, a staje się podstawowym budulcem każdego zapytania sieciowego, każdego wywołania bazy danych i każdego filtra pakietów w sieciach telekomunikacyjnych.
Dramatyczna redukcja kosztów, latencji i obciążenia infrastruktury chmurowej
Aby uświadomić sobie skalę przewagi infrastrukturalnej, jaką oferują modele typu Jev nad tradycyjnymi rozwiązaniami, warto zestawić ze sobą twarde parametry techniczne środowisk wykonawczych. W klasycznym klastrze serwerów dedykowanych wnioskowaniu modeli LLM głównym wąskim gardłem jest przepustowość magistrali pamięciowej akceleratorów graficznych. Utrzymywanie w pamięci VRAM gigantycznych tabel uwagi dla tysięcy równoległych sesji użytkowników drastycznie ogranicza gęstość upakowania procesów na pojedynczym serwerze.
Ponieważ model Jev eliminuje proces sekwencyjnego dekodowania, problem bufora pamięci podręcznej kluczy i wartości całkowicie znika. Węzeł obliczeniowy może przetwarzać zapytania w sposób strumieniowy, wykorzystując pełną moc obliczeniową rdzeni tensorowych bez konieczności rezerwowania pamięci na przyszłe tokeny wyjściowe. Oznacza to, że pojedynczy serwer wyposażony w akceleratory AI jest w stanie obsłużyć nawet do stu razy więcej zapytań decyzyjnych na sekundę w porównaniu z tą samą konfiguracją sprzętową uruchamiającą model generatywny o zbliżonej liczbie parametrów.
Różnica ta przekłada się bezpośrednio na bilans finansowy przedsiębiorstw technologicznych. Koszt operacyjny infrastruktury spada z tysięcy dolarów miesięcznie do ułamka tej kwoty, a czasy odpowiedzi rzędu dwudziestu milisekund pozwalają na wpięcie modelu Jev bezpośrednio w krytyczną ścieżkę synchroniczną aplikacji internetowych bez obawy o przekroczenie limitów czasu oczekiwania klientów. Rozwiązanie to sprawia, że inteligentna klasyfikacja staje się równie powszechna i tania, jak tradycyjne zapytanie do szybkiej bazy klucz-wartość w pamięci operacyjnej.
Przemysłowe spektrum zastosowań. Gdzie modele Jev deklasują generatywne LLM
Praktyczne zastosowania modeli nowej architektury wykraczają daleko poza proste sortowanie wiadomości e-mail. Jednym z najważniejszych obszarów ekspansji TypeSafe AI jest automatyzacja nowoczesnych ekosystemów agentowych. W architekturach opartych na protokołach takich jak Model Context Protocol czy bibliotekach integracyjnych typu LangChain, agenci programistyczni spędzają lwią część czasu na podejmowaniu mikro-decyzji o kolejnym kroku: które narzędzie wywołać, czy bieżący wynik wykonania polecenia jest satysfakcjonujący, czy należy powtórzyć zapytanie do bazy danych, czy też zakończyć realizację zadania.
Wykorzystywanie wielkich modeli generatywnych do kręcenia takich pętli sterowania przypominało angażowanie profesora uniwersyteckiego do ciągłego sprawdzania, czy światło w pokoju jest włączone. Zastąpienie wewnętrznego mechanizmu decyzyjnego agenta modelem Jev pozwala na przyspieszenie pracy całego systemu agentowego nawet o kilkaset procent. Agent nie marnuje czasu na generowanie myśli wstępnych, lecz błyskawicznie otrzymuje stypizowaną flagę warunkową i przechodzi do natychmiastowego wykonania kolejnej akcji systemowej.
Kolejnym potężnym sektorem jest e-commerce i cyberbezpieczeństwo w czasie rzeczywistym. Podczas gigantycznych akcji wyprzedażowych systemy transakcyjne przetwarzają dziesiątki tysięcy koszyków zakupowych na sekundę. Zastosowanie modelu Jev umożliwia natychmiastowy scoring intencji zakupowej, dynamiczne korygowanie polityki cenowej, blokowanie botów scrapujących oraz zapobieganie nadużyciom kart płatniczych w momencie kliknięcia przycisku finalizacji zamówienia, bez wprowadzania zauważalnego opóźnienia dla klienta końcowego.
Równie imponujące rezultaty osiągane są w obszarze moderacji treści i zgodności regulacyjnej. Zamiast budować wieloetapowe filtry oparte na wyrażeniach regularnych, które łatwo ominąć drobną zmianą pisowni, lub kosztowne kolejki analizy tekstu przez czatboty, platformy społecznościowe mogą weryfikować publikowane komentarze i multimedia pod kątem kilkudziesięciu nienaruszalnych zasad prawnych jednocześnie, w jednym przebiegu enkodera Jev, natychmiast odrzucając treści naruszające standardy bezpieczeństwa.
Reakcja gigantów technologicznych i nieuchronna bifurkacja rynku
Pojawienie się modeli typu Jev i ich bezprecedensowy sukces finansowy wywołały falę konsternacji w zarządach największych korporacji technologicznych. Przez lata giganci tacy jak Google, Meta, Microsoft czy OpenAI przekonywali rynek, że przyszłość należy wyłącznie do gigantycznych modeli multimodalnych potrafiących robić wszystko. Doświadczenie rynkowe pokazuje jednak, że o ile uniwersalność sprawdza się doskonale w aplikacjach konsumenckich i asystentach osobistych, o tyle w środowiskach inżynierii przemysłowej wygrywa bezwzględna specjalizacja, determinizm formatowy i przewidywalność kosztowa.
Eksperci z Doliny Krzemowej przewidują, że w najbliższych miesiącach będziemy świadkami wyraźnego pęknięcia rynku sztucznej inteligencji na dwa odrębne segmenty technologiczne. Po jednej stronie barykady pozostaną elokwentne, generatywne modele konwersacyjne i kreatywne, operujące na poziomie Systemu Drugiego, dedykowane do tworzenia artykułów, generowania kodu źródłowego, komponowania grafiki czy prowadzenia wielogodzinnych dyskusji strategicznych z człowiekiem. Po drugiej stronie uformuje się potężny, niewidoczny dla przeciętnego użytkownika ekosystem maszynowych modeli decyzyjnych Systemu Pierwszego, których jedynym zadaniem będzie błyskawiczne, ciche i bezbłędne sterowanie całą globalną infrastrukturą cyfrową.
Już teraz pojawiają się doniesienia, że konkurencyjne laboratoria badawcze rozpoczęły prace nad własnymi odpowiednikami architektury Jev. Google bada możliwości wykorzystania wyspecjalizowanych wariantów enkoderów z rodziny Gemini do zadań czysto strukturalnych, a środowiska open-source intensywnie pracują nad destylacją wiedzy z dużych modeli lingwistycznych do lekkich, stypizowanych silników probabilistycznych, które będzie można uruchamiać bezpośrednio na procesorach urządzeń brzegowych.
Nowy paradygmat w inżynierii oprogramowania. Zrozumieć istotę zmiany
Lekcja płynąca z fenomenu modeli typu Jev ma wymiar głęboko filozoficzny dla całej dyscypliny inżynierii oprogramowania. Przez kilka ostatnich lat środowisko programistyczne uległo złudzeniu, że postęp w dziedzinie sztucznej inteligencji zwolni twórców aplikacji z obowiązku dbania o rygor typograficzny, czystość architektoniczną i precyzję struktur danych. Wydawało się, że wystarczy rzucić nieuporządkowany ciąg znaków w stronę gigantycznego modelu, a ten magicznie domyśli się intencji programisty i zwróci idealny rezultat.
TypeSafe AI udowodniło, że prawdziwa dojrzałość technologiczna polega na czymś dokładnie odwrotnym. Zamiast zmuszać komputery do naśladowania ludzkiego gadulstwa w miejscach, gdzie potrzebna jest precyzja matematyczna, należy stworzyć modele, które szanują naturę maszyn. Modele Jev nie próbują być poetami, filozofami ani kompanami do rozmowy. Są wysoce wyspecjalizowanymi, błyskawicznymi i bezlitośnie precyzyjnymi mechanizmami wnioskowania o stanie systemu.
Dla branży IT nadejście ery modeli decyzyjnych oznacza definitywne pożegnanie z epoką kruchych parserów tekstu, niepewnych wyrażeń regularnych i kosztownych eksperymentów z prompt engineeringiem w warstwie backendowej. Oprogramowanie przyszłości nie będzie rozmawiać ze sztuczną inteligencją – oprogramowanie przyszłości będzie bezpośrednio korzystać ze stypizowanych funkcji wnioskowania tak naturalnie, jak dzisiaj korzysta z instrukcji warunkowych w kodzie źródłowym. W tym sensie William Stanley Jevons miał absolutną rację. Gdy inteligencja decyzyjna staje się tak tania i wszechobecna jak woda w kranie, świat przestaje być taki sam, a machina innowacji technologicznej przyspiesza w tempie, którego nikt z nas nie jest w stanie w pełni przewidzieć.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.