
Od wideo-generacji do fizycznych silników świata: Jak modele World Models i dyfuzja czasoprzestrzenna uczą sztuczną inteligencję praw dynamiki
Granice paradygmatu autoregresyjnego i potrzeba reprezentacji świata fizycznego
Przez pierwszą dekadę głębokiego uczenia maszynowego dominował paradygmat modeli językowych, które traktowały rzeczywistość jako jednowymiarowy ciąg dyskretnych symboli. Choć architektura transformatorowa osiągnęła zdumiewające sukcesy w generowaniu spójnego tekstu, tłumaczeniu maszynowym oraz pisaniu kodu źródłowego, jej fundamentalnym ograniczeniem pozostawał brak ucieleśnionego zakotwiczenia semantycznego, znany w kognitywistyce jako symbol grounding problem. Model językowy może bezbłędnie zacytować wzór na przyspieszenie ziemskie czy opisać zjawisko tarcia kinetycznego, lecz nie posiada wewnętrznej, intuicyjnej reprezentacji tego, co stanie się ze szklanką zrzuconą ze stołu na marmurową posadzkę.
Ta poznawcza ułomność stała się główną barierą w rozwoju robotyki autonomicznej oraz systemów sterowania pojazdami autonomicznymi. Tradycyjne podejście inżynieryjne, polegające na łączeniu modułów percepcji wizyjnej z klasycznymi silnikami fizycznymi opartymi na sztywnych równaniach dynamiki Newtona, okazywało się kruche i nieelastyczne w obliczu nieprzewidywalności realnego świata. Wszelkie odchylenia od idealnych założeń modelu matematycznego, takie jak nagłe zmiany oświetlenia, deformacje plastyczne miękkich obiektów czy turbulentne zachowanie cieczy, prowadziły do załamania algorytmów planowania trajektorii.
Prawdziwym przełomem stało się przeniesienie akcentu z modelowania symbolicznego na generowanie symulacji wizualnych w czasie i przestrzeni. Wprowadzenie zaawansowanych modeli generowania wideo, zapoczątkowane przez architekturę Sora oraz pokrewne badania w czołowych ośrodkach laboratoryjnych, ujawniło zdumiewającą właściwość emergentną: trenowanie sieci neuronowej na setkach milionów godzin nagrań wideo wymusza na niej odtworzenie wewnętrznego, uogólnionego modelu praw fizyki. Taki system nie jest już jedynie statystycznym generatorem pikseli, lecz staje się tak zwanym modelem świata World Model, zdolnym do symulowania przyszłych stanów środowiska w odpowiedzi na hipotetyczne akcje podmiotu.
Dyfuzja czasoprzestrzenna i tokenizacja ciągła w modelach generacji wideo
Zrozumienie działania modeli świata wymaga przeanalizowania mechanizmów, w jakich współczesne sieci przetwarzają sygnał wizualny o czterech wymiarach: dwóch wymiarach przestrzennych, kanale barwnym oraz osi czasu. Wczesne próby generowania sekwencji wideo opierały się na rekurencyjnym generowaniu kolejnych klatek pojedynczo, co prowadziło do szybkiej akumulacji błędów, utraty spójności geometrycznej i charakterystycznego zjawiska pływania tekstur. Przełom przyniosła koncepcja jednoczesnej dyfuzji czasoprzestrzennej na trójwymiarowych blokach danych, zwanych łatami czasoprzestrzennymi spacetime patches.
W architekturze tej surowy materiał wideo jest najpierw poddawany kompresji za pomocą czasoprzestrzennego autoenkodera wariacyjnego VAE, który redukuje rozmiar danych o rzędy wielkości, mapując sekwencję pikseli na ciągłą, skompresowaną przestrzeń ukrytą. Następnie trójwymiarowa macierz cech zostaje podzielona na bloki obejmujące zarówno wycinek przestrzeni kadru, jak i kilka kolejnych kroków czasowych. Każda taka łata staje się pojedynczym tokenem wejściowym dla gigantycznej sieci transformatorowej Diffusion Transformer DiT.
Proces generowania rozpoczyna się od całkowitego szumu gaussowskiego o wymiarach odpowiadających docelowemu nagraniu. W kilkudziesięciu iteracjach odszumiania mechanizm atencji czasoprzestrzennej Spacetime Self-Attention jednocześnie analizuje relacje pomiędzy odległymi fragmentami kadru oraz ich ewolucję wzdłuż osi czasu. Pozwala to na zachowanie absolutnej trwałości obiektów object permanence: jeśli samochód wjeżdża za budynek i znika z pola widzenia kamery na kilkadziesiąt klatek, model utrzymuje w przestrzeni ukrytej wektor jego trajektorii i prędkości, bezbłędnie renderując jego pojawienie się po drugiej stronie przeszkody w dokładnie wyliczonym momencie.
Wewnętrzne modele fizyki: Grawitacja, inercja i kolizje w przestrzeni ukrytej
Najbardziej fascynującym zjawiskiem obserwowanym w wielkoskalowych modelach wideo jest wyłanianie się fundamentalnych praw mechaniki klasycznej bez jakiegokolwiek jawnego programowania reguł fizycznych. Model uczony wyłącznie na surowych strumieniach wideo z kamer w sposób autonomiczny odkrywa istnienie wektora grawitacji, zjawiska bezwładności oraz zachowania pędu podczas zderzeń sprężystych i niesprężystych.
Gdy w wygenerowanej scenie postać upuszcza porcelanowy talerz, model nie zawiesza go w powietrzu ani nie pozwala mu lecieć w górę: obiekt przyspiesza w kierunku podłoża zgodnie z paraboliczną trajektorią spadku swobodnego, a w momencie kontaktu z ziemią rozpada się na dziesiątki odłamków, których wektory rozrzutu precyzyjnie odpowiadają kątowi uderzenia i prędkości początkowej. Co więcej, sieć poprawnie symuluje zachowanie materiałów o różnej sprężystości: gumowa piłka odbija się od betonu, ciasto ulega plastycznemu spłaszczeniu, a tafla wody rozchodzi się w koncentryczne fale hydrodynamiczne z uwzględnieniem napięcia powierzchniowego.
Badania nad reprezentacjami wewnętrznymi sieci DiT ujawniły, że w głębokich warstwach transformatora dochodzi do wykształcenia wyspecjalizowanych obwodów neuronowych kodujących trójwymiarową geometrię sceny oraz relacje oświetlenia. Model rozumie, że źródło światła umieszczone po lewej stronie kadru musi rzucać cień o ściśle określonej długości i miękkości krawędzi, a przemieszczający się obiekt musi powodować dynamiczne zmiany refleksów na powierzchniach metalicznych i szklanych. To dowodzi, że sieć nie zapamiętuje sekwencji pikseli, lecz buduje matematyczną reprezentację przestrzeni euklidesowej i fizyki optycznej.
Zastosowanie World Models w sterowaniu robotami humanoidalnymi
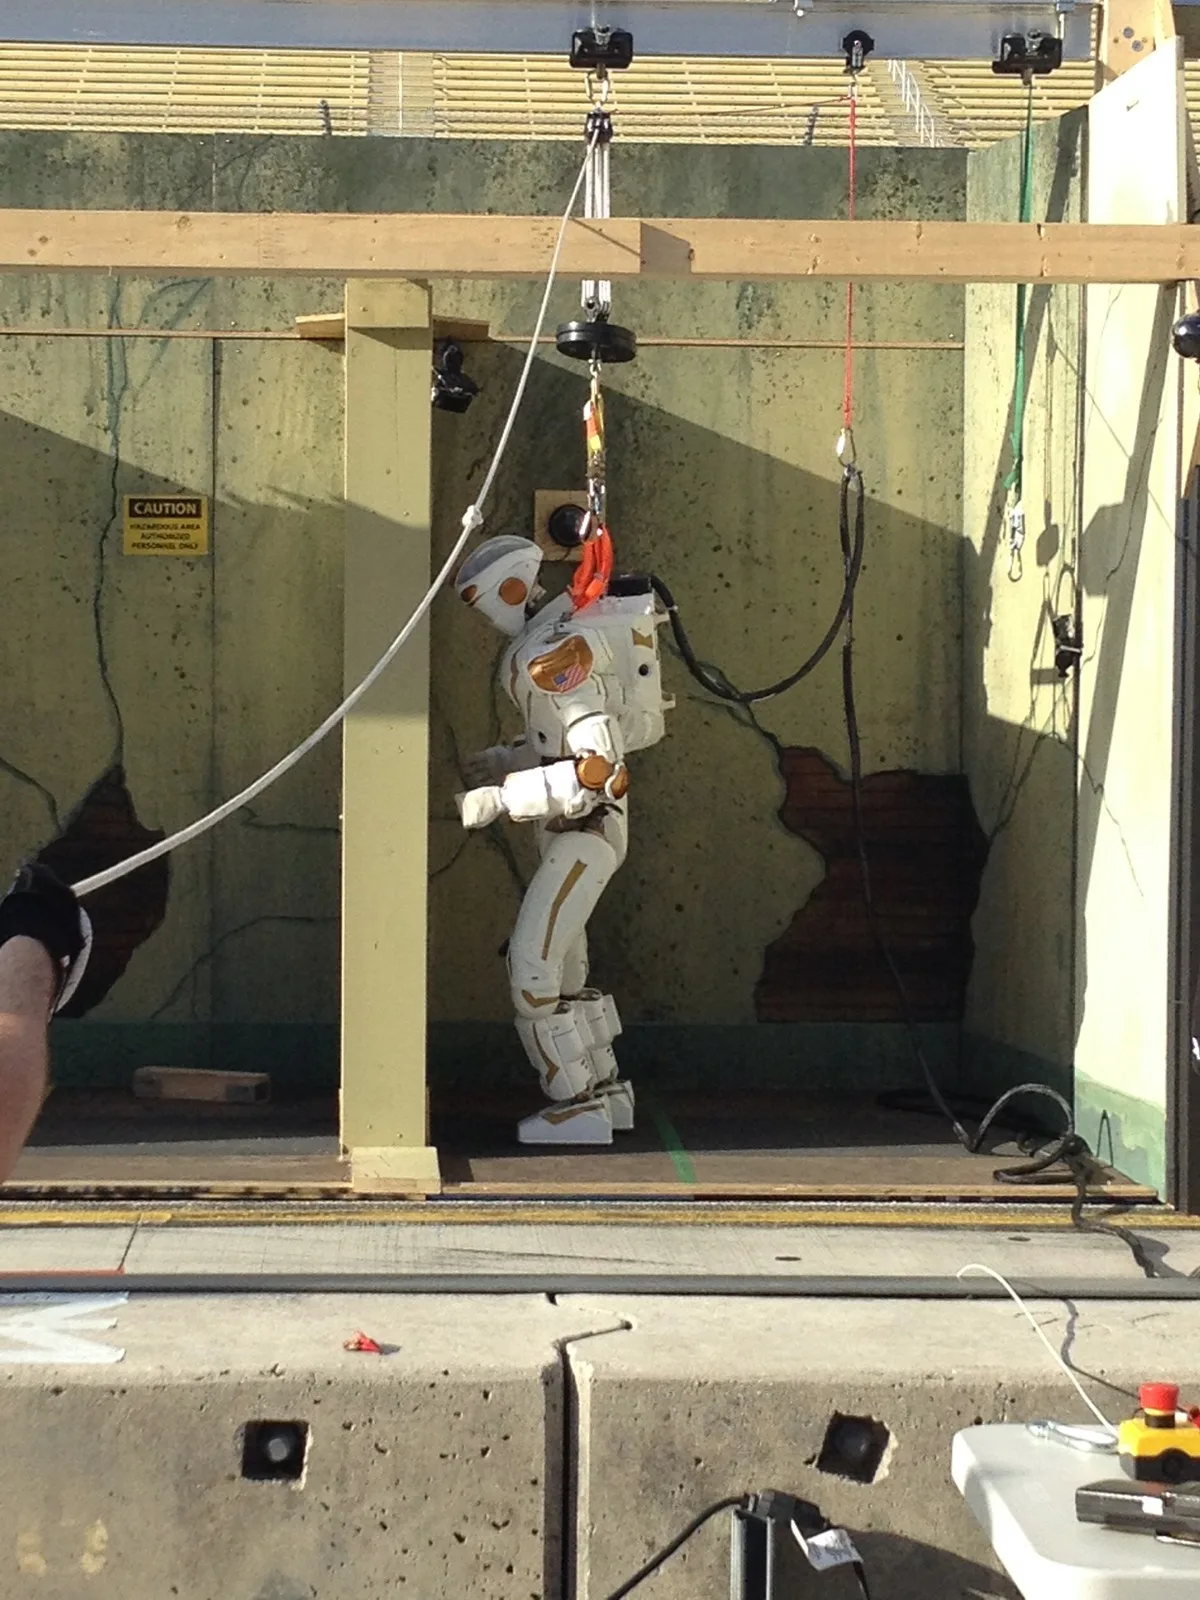
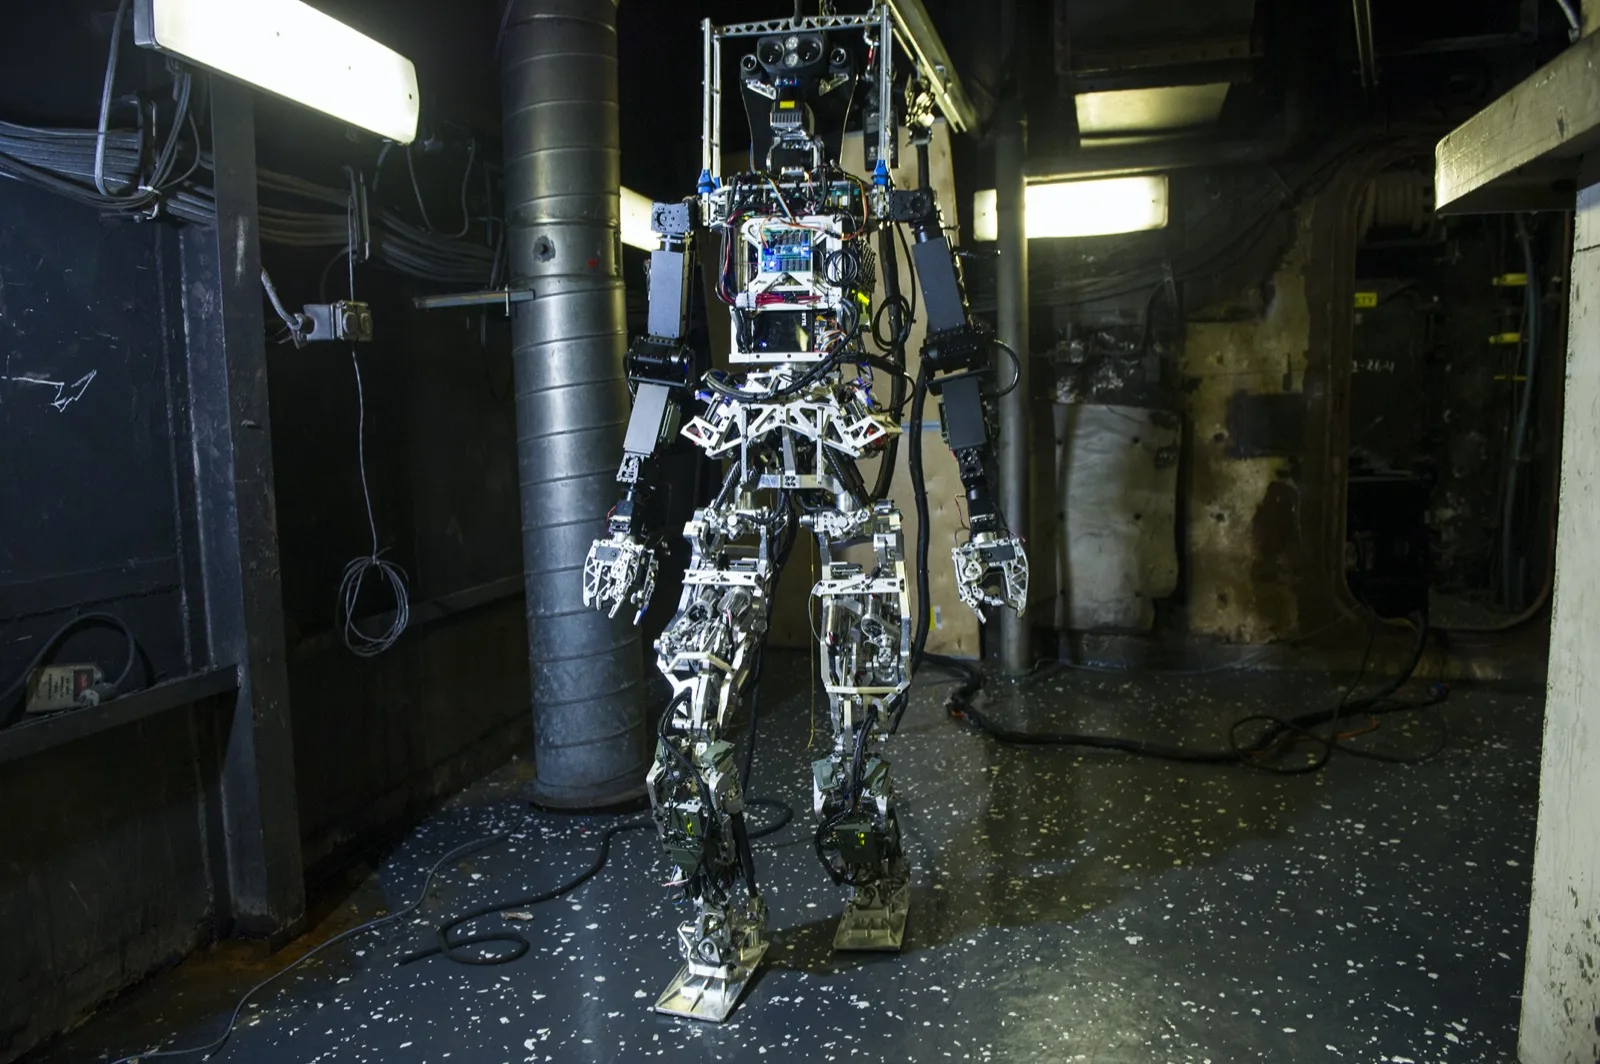
Bezpośrednim beneficjentem rewolucji modeli świata staje się dynamicznie rozwijający się sektor robotyki ucieleśnionej embodied AI, a w szczególności roboty humanoidalne przeznaczone do pracy w logistyce, przemyśle i usługach. Dotychczas największym wyzwaniem w autonomicznej manipulacji i lokomocji był brak wyobraźni fizycznej: robot musiał fizycznie wykonać każdy ruch, aby przekonać się o jego skutkach, co w przypadku pomyłki prowadziło do uszkodzenia manipulatorów, przewrócenia konstrukcji lub zniszczenia otaczających przedmiotów.
Integracja robota z pokładowym modelem świata całkowicie zmienia tę dynamikę. Zanim sterownik wyśle impulsy prądowe do serwomotorów w stawach kolanowych czy palcach chwytaka, robot przeprowadza w przestrzeni ukrytej symulację wyobrażeniową rollout. Pobierając bieżący obraz z kamer stereoskopowych jako klatkę początkową, model świata generuje kilkadziesiąt alternatywnych trajektorii wideo przedstawiających potencjalne konsekwencje różnych sekwencji ruchów. W ułamku sekundy algorytm optymalizacyjny ocenia symulowane warianty pod kątem stabilności środka ciężkości, prawdopodobieństwa poślizgu oraz precyzji chwytu, wybierając trajektorię o najwyższym wskaźniku sukcesu.
Taka architektura pozwala robotom humanoidalnym na natychmiastową adaptację do nieznanego otoczenia bez konieczności wielogodzinnego douczania na konkretnym stanowisku pracy. Jeśli podłoga okazuje się śliska lub przenoszony przedmiot ma nierównomiernie rozłożoną masę, model świata natychmiast rejestruje anomalię w relacjach sensorycznych i generuje korektę ułożenia stóp, dynamicznie kompensując siły odchylające z precyzją przewyższającą reakcje ludzkich operatorów.
Od symulacji do rzeczywistości: Rozwiązanie problemu Sim2Real transfer
Przez lata fundamentalną przeszkodą w trenowaniu zaawansowanych algorytmów sterowania robotami był tak zwany problem luki symulacyjnej Reality Gap lub Sim2Real transfer. Tradycyjne symulatory oparte na silnikach gier komputerowych, takich jak MuJoCo, Isaac Sim czy Bullet, oferowały wprawdzie zawrotną prędkość obliczeń, lecz ich uproszczona grafika, sztuczne tekstury i wyidealizowane modele tarcia sprawiały, że algorytmy nauczone w symulacji całkowicie zawodziły po przeniesieniu na fizyczną platformę sprzętową.
Modele świata oparte na dyfuzji wideo likwidują tę barierę w sposób definitywny. Ponieważ uczą się one bezpośrednio na fotorealistycznych nagraniach ze świata rzeczywistego, ich symulacje charakteryzują się identycznym poziomem szumu optycznego, niedoskonałościami oświetlenia, ziarnistością sensorów oraz realistyczną dynamiką zabrudzeń i zużycia materiałowego. Robot trenowany wewnątrz neuronowego modelu świata widzi środowisko dokładnie tak, jak będzie je postrzegał w trakcie rzeczywistej misji produkcyjnej.
Co więcej, neuronowy symulator pozwala na prowadzenie treningu z wykorzystaniem wzmocnienia Reinforcement Learning na niewyobrażalną dotąd skalę. Zamiast ryzykować uszkodzenie drogich prototypów w fizycznym laboratorium, miliony wirtualnych robotów mogą równolegle eksplorować ekstremalne scenariusze w chmurze obliczeniowej: symulować poślizgi na rozlanym oleju, reakcje na nagłe pchnięcie przez człowieka czy manipulację kruchymi przedmiotami z cienkiego szkła, zdobywając stulecia doświadczeń w ciągu pojedynczego dnia obliczeniowego.
Autonomiczna jazda nowej ery: Wayve, Tesla FSD i modele predykcji ruchu
Równolegle z robotyką stacjonarną modele świata dokonują rewolucji w architekturze autonomicznych pojazdów. Wczesne systemy jazdy autonomicznej, oparte na skomplikowanych potokach składających się z detekcji obiektów, śledzenia kounding boksów, regułowych maszyn stanów oraz manualnie kodowanych map wysokiej rozdzielczości HD Maps, osiągnęły kres swoich możliwości, generując setki trudnych do obsłużenia przypadków brzegowych edge cases w gęstym ruchu miejskim.
Pionierzy nowego podejścia, tacy jak brytyjski start-up Wayve z modelem GAIA czy inżynierowie rozwijający architekturę Tesla FSD v12, przestawili swoje systemy na całościowe modele od pikseli do akcji end-to-end, których sercem jest właśnie predykcyjny model świata. Samochód wyposażony w zestaw kamer nie próbuje klasyfikować każdego pieszego czy znaku drogowego do sztywnej bazy danych; zamiast tego model świata generuje w czasie rzeczywistym wielowariantową prognozę rozwoju sytuacji na drodze na kilka sekund w przód.
Jeśli na jezdnię wtacza się piłka zza zaparkowanego vana, model świata na podstawie kontekstu sceny przewiduje z wysokim prawdopodobieństwem pojawienie się biegnącego dziecka, zanim jeszcze pojawi się ono w bezpośrednim polu widzenia sensorów. System natychmiast inicjuje manewr zwalniania i przygotowuje układ hamulcowy, wykazując się zdolnością do defensywnej, proaktywnej jazdy wzorowanej na doświadczonych ludzkich kierowcach. Eliminacja sztywnych map HD sprawia, że pojazd staje się całkowicie autonomiczny w dowolnym zakątku globu, polegając wyłącznie na własnej zdolności widzenia i rozumienia praw dynamiki przestrzennej.
Wyzwania obliczeniowe: Skalowanie inferencji wideo w czasie rzeczywistym
Mimo oszałamiających możliwości teoretycznych i demonstracyjnych, powszechne wdrożenie modeli świata w urządzeniach brzegowych napotyka na potężne wyzwania natury obliczeniowej. Generowanie sekwencji wideo za pomocą modeli dyfuzyjnych jest procesem skrajnie zasobożernym, wymagającym wielokrotnego przepuszczania macierzy przez gigantyczne transformatory, co na standardowych akceleratorach serwerowych zajmuje od kilkunastu sekund do kilku minut na jedną sekundę wygenerowanego materiału.
W zastosowaniach robotycznych i motoryzacyjnych opóźnienie decyzyjne musi tymczasem mieścić się w przedziale kilkunastu milisekund. Rozwiązaniem tego impasu staje się gwałtowny rozwój technik destylacji modeli dyfuzyjnych, takich jak Consistency Models oraz Rectified Flow Matching. Metody te pozwalają na zredukowanie liczby kroków odszumiania z kilkudziesięciu do zaledwie jednego lub dwóch kroków bez zauważalnej degradacji spójności geometrycznej sceny.
Równolegle projektowane są dedykowane procesory neuromorficzne i akceleratory przestrzenne, zoptymalizowane pod kątem przetwarzania operacji na łatach czasoprzestrzennych z minimalnym poborem energii. Dzięki agresywnej kwantyzacji wag do formatów FP8 i FP4 oraz architekturze obliczeń w pamięci SRAM, możliwe staje się uruchomienie kompaktowych modeli świata o parametrach rzędu kilku miliardów wag bezpośrednio na pokładzie autonomicznego drona czy robota kroczącego, uniezależniając go od łączności z chmurą obliczeniową.
Przyszłość ucieleśnionej sztucznej inteligencji: Od pikseli do ogólnej inteligencji
Kierunek ewolucji modeli świata wskazuje na to, że stanowią one brakujący pomost pomiędzy wąską sztuczną inteligencją a ogólną inteligencją sztuczną AGI. Zdolność do tworzenia spójnych symulacji mentalnych, testowania hipotez w wyobraźni przed ich fizyczną realizacją oraz uogólniania wiedzy na całkowicie nowe środowiska to rdzeń ludzkiego geniuszu poznawczego, który odróżnia istoty rozumne od bezrefleksyjnych automatów.
W nadchodzących latach będziemy świadkami fuzji modeli świata z multimodalnymi modelami językowymi w jednolite systemy poznawcze. Taki zintegrowany agent będzie potrafił nie tylko prowadzić błyskotliwy dialog filozoficzny i pisać analizy naukowe, lecz przede wszystkim bezpiecznie i skutecznie manipulować materią w świecie rzeczywistym: budować konstrukcje inżynieryjne, przeprowadzać precyzyjne operacje chirurgiczne i eksplorować niebezpieczne środowiska pozaziemskie. Przejście od biernego rozumienia języka do aktywnego panowania nad prawami fizyki wyznacza najważniejszy skok cywilizacyjny w całej historii informatyki.
Od reprezentacji pikselowej do modeli dynamiki w przestrzeni cech JEPA
Chociaż modele dyfuzji wideo generujące fotorealistyczne piksele osiągnęły oszałamiający poziom wizualny, ich bezpośrednie zastosowanie w systemach decyzyjnych robotów napotyka na fundamentalną barierę efektywności obliczeniowej. Generowanie każdego pojedynczego piksela w wysokiej rozdzielczości zmusza sieć neuronową do modelowania zjawisk całkowicie irrelewantnych z punktu widzenia fizyki działania: mikroskopijnych szumów matrycy aparatu, drobnych zmarszczek na odzieży czy przypadkowych układów liści na drzewach w tle sceny. Z tego względu czołowi teoretycy uczenia maszynowego, w tym Yann LeCun, zaproponowali architekturę Joint Embedding Predictive Architecture JEPA, która przenosi modelowanie świata z poziomu pikseli do zwartej przestrzeni cech semantycznych.
W architekturze V-JEPA Video Joint Embedding Predictive Architecture model nie próbuje przewidzieć dokładnego wyglądu przyszłych klatek wideo, lecz prognozuje wektory reprezentacji w przestrzeni ukrytej. Zadaniem sieci jest odrzucenie szumu wizualnego i skupienie całej pojemności informacyjnej na topologii przestrzennej, prędkościach względnych oraz relacjach interakcji pomiędzy obiektami. Taki model świata operuje na poziomie pojęciowym: wie, że popchnięcie klocka spowoduje jego przesunięcie o dziesięć centymetrów, nie marnując ani jednego cyklu obliczeniowego na renderowanie faktury drewna czy odbić światła.
Przejście na poziom reprezentacji ukrytych pozwala na zredukowanie złożoności obliczeniowej o kilka rzędów wielkości. Robot humanoidalny wyposażony w moduł JEPA może symulować tysiące alternatywnych planów działania w ciągu pojedynczej sekundy, realizując optymalizację trajektorii w czasie rzeczywistym na kompaktowym akceleratorze brzegowym o poborze mocy rzędu kilkunastu watów, co jest warunkiem koniecznym dla masowej produkcji autonomicznych maszyn przemysłowych.
Generowanie danych syntetycznych dla rzadkich scenariuszy awaryjnych
Kolejnym potężnym zastosowaniem neuronowych modeli świata jest rozwiązywanie problemu deficytu danych treningowych dla sytuacji skrajnych, tak zwanych corner cases. W realnym świecie zbieranie nagrań z wypadków drogowych, pożarów hal produkcyjnych, gwałtownych poślizgów pojazdów czy upadków robotów ze schodów jest skrajnie niebezpieczne, kosztowne i trudne do zreplikowania w kontrolowanych warunkach. Floty pojazdów testowych mogą przejechać miliony kilometrów po autostradach bez napotkania ani jednego pieszego wyskakującego zza przeszkody w ulewnym deszczu.
Modele świata pozwalają na fotorealistyczne generowanie nieograniczonej liczby syntetycznych scenariuszy krytycznych na żądanie. Wykorzystując mechanizmy sterowania promptem tekstowym lub warunkowaniem trajektorii akcji, inżynierowie mogą wygenerować setki tysięcy wariantów kolizyjnych: od nagłego pęknięcia opony na oblodzonej nawierzchni, przez oślepienie sensorów laserem z przeciwległego pasa, aż po manipulację kruchymi probówkami chemicznymi w warunkach silnych wstrząsów sejsmicznych.
Trening systemów sterowania na takich syntetycznych, fizycznie spójnych symulacjach drastycznie podnosi wskaźniki bezpieczeństwa algorytmów przed ich dopuszczeniem do ruchu publicznego. Algorytm, który w przestrzeni wirtualnego modelu świata przetrwał miliony symulowanych katastrof i wypracował optymalne odruchy obronne, reaguje w świecie fizycznym ze zwinnością i precyzją wykraczającą poza zdolności biologicznego mózgu człowieka.
Ewaluacja wierności fizycznej: Benchmarki PhyWorld i IntPhys
Kluczowym elementem weryfikacji modeli świata przed ich wdrożeniem do systemów sterowania robotami przemysłowymi jest opracowanie rygorystycznych, ilościowych narzędzi ewaluacyjnych, zdolnych do mierzenia stopnia zgodności symulacji z prawami fizyki klasycznej. W ostatnich miesiącach wiodącymi standardami w tej dziedzinie stały się benchmarki PhyWorld oraz IntPhys Intuitive Physics Benchmark, opracowane przez konsorcja akademicko-przemysłowe.
Testy te polegają na konfrontowaniu modelu świata z setkami syntetycznych sekwencji testowych zawierających celowo wprowadzone aberracje fizyczne: obiekty przenikające przez lite ściany, piłki odbijające się z energią kinetyczną wyższą niż przed zderzeniem czy ciecze płynące pod górę bez zewnętrznego ciśnienia. Zadaniem modelu jest matematyczna ocena prawdopodobieństwa obserwowanej sceny poprzez pomiar zaskoczenia poznawczego surprise metric mierzonego entropią rozkładu predykcji. Wyniki wykazują, że zaawansowane modele dyfuzji czasoprzestrzennej bezbłędnie identyfikują naruszenia zasad zachowania pędu i energii, osiągając poziom kognitywnej intuicji fizycznej zbliżony do dorosłego człowieka, co otwiera drogę do certyfikacji bezpieczeństwa autonomicznych robotów w środowiskach pracy z ludźmi.
Co szczególnie istotne, benchmarki te badają również zdolność modelu do ekstrapolacji praw fizyki na obiekty o niespotykanych dotąd parametrach geometrycznych i materiałowych. Jeśli robot ma manipulować nowo zaprojektowanym kompozytem polimerowym lub unosić pojemnik z cieczą o zmiennej lepkości nienewtonowskiej, model świata musi wygenerować poprawną prognozę zachowania układu bez wcześniejszych danych treningowych dla tej konkretnej substancji. Sukces w testach zero-shot physics transfer dowodzi, że sztuczna inteligencja przechodzi od powierzchownego dopasowywania wzorców wizualnych do głębokiego, niezmienniczego modelowania struktury czasoprzestrzeni.
Zarządzanie czasem i termodynamiczna strzałka przyczynowości
Fundamentalnym wyzwaniem teoretycznym w projektowaniu modeli czasoprzestrzennych pozostaje zachowanie ścisłej asymetrii czasu, zwanej w fizyce termodynamiczną strzałką czasu. Klasyczne mechanizmy atencji w sieciach transformatorowych charakteryzują się symetrią dwukierunkową, co oznacza, że model analizując sekwencję może równie łatwo wnioskować w przód, jak i wstecz. W symulacji fizycznej prowadziło to wczesne modele wideo do kuriozalnych błędów: pęknięta szklanka potrafiła samoczynnie scalić się w całość i wskoczyć z powrotem na stół, a dym z ogniska ulegał kondensacji z powrotem do polana drewna, łamiąc drugą zasadę termodynamiki.
Wdrożenie kauzalnych masek atencji Causal Attention Masking w połączeniu z dyfuzyjnymi modelami dopasowania przepływu Rectified Flow Matching wymusiło na sieciach zachowanie ścisłej monotoniczności entropii. Model uczy się, że procesy dysypatywne, takie jak tarcie, rozpraszanie ciepła czy pękanie kruche, są zjawiskami nieodwracalnymi w czasie. Reprezentacja przyczynowości przyczynowo-skutkowej sprawia, że generowane predykcje stają się zgodne z prawami natury, eliminując aberracje i halucynacje fizyczne w pętli decyzyjnej agenta.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.