
Neurosymboliczna sztuczna inteligencja i formalna weryfikacja kodu: Jak integracja LLM z asystentami dowodzenia Lean 4, solwerami SMT i logiką pierwszego rzędu eliminuje halucynacje w systemach o krytycznym znaczeniu
Współczesna rewolucja w dziedzinie sztucznej inteligencji, napędzana przez transformatory i wielkie modele językowe LLM, doprowadziła do bezprecedensowego skoku produktywności w inżynierii oprogramowania. Zdolność generowania tysięcy linii kodu źródłowego na podstawie zwięzłego opisu w języku naturalnym zmieniła paradygmat programowania, przesuwając rolę inżyniera z twórcy składni na recenzenta i architekta systemów. Jednakże pod tą spektakularną fasadą kryje się fundamentalna wada architektury czysto statystycznej: brak jakichkolwiek gwarancji poprawności semantycznej i logicznej. Modele głębokie operują na rozkładach prawdopodobieństwa kolejnych tokenów, nie posiadając wewnętrznego aparatu dedukcyjnego. W rezultacie nawet najbardziej zaawansowane modele generują kod zawierający subtelne halucynacje, luki w logice biznesowej oraz krytyczne podatności bezpieczeństwa, które wymykają się tradycyjnym testom jednostkowym.
W aplikacjach konsumenckich czy komercyjnych serwisach internetowych sporadyczny błąd w logice programu może oznaczać co najwyżej konieczność restartu usługi lub korekty rekordu w bazie danych. Sytuacja ulega jednak dramatycznej zmianie w systemach o krytycznym znaczeniu dla życia i bezpieczeństwa państwa mission-critical systems. Oprogramowanie sterujące fly-by-wire w myśliwcach piątej generacji, systemy kontroli prętów regulacyjnych w reaktorach jądrowych, algorytmy podawania leków w medycznych pompach infuzyjnych czy wreszcie zdecentralizowane protokoły finansowe i kontrakty kryptograficzne zarządzające miliardami dolarów nie dopuszczają marginesu błędu na poziomie jednego promila. W tych domenach statystyczna przybliżona poprawność empiryczna jest bezwartościowa, a jedynym akceptowalnym standardem pozostaje matematyczny dowód absolutnej zgodności kodu z formalną specyfikacją.
W odpowiedzi na tę egzystencjalną barierę rozwoju sztucznej inteligencji na styku informatyki teoretycznej i inżynierii uczenia maszynowego narodził się paradygmat neurosymboliczny Neurosymbolic AI. Stanowi on hybrydową syntezę dwóch historycznie przeciwstawnych nurtów informatyki: subsymbolicznego uczenia głębokiego, reprezentującego intuicyjny, szybki System 1 według koncepcji Daniela Kahnemana, oraz klasycznej sztucznej inteligencji symbolicznej GOFAI, opartej na logice pierwszego rzędu, solwerach spełnialności teorii SMT i interaktywnych asystentach dowodzenia, uosabiających analityczny i rygorystyczny System 2. Połączenie twórczej heurystyki modeli LLM z bezwzględną precyzją weryfikatorów formalnych, takich jak Lean 4 czy Z3, eliminuje zjawisko halucynacji u samego źródła, otwierając drogę do generowania kodu o matematycznie certyfikowanej niezawodności.
Granice statystycznego uczenia maszynowego i semantyczna przepaść
Aby zrozumieć, dlaczego skalowanie samych wag sieci neuronowych i powiększanie kontekstu nie rozwiąże problemu halucynacji w logice, należy przyjrzeć się mechanice działania mechanizmu atencji Attention is All You Need. Transformator optymalizuje minimalizację entropii krzyżowej na korpusie tekstowym, przewidując najbardziej prawdopodobny rozkład wektorów osadzeń kolejnych słów. Model potrafi z niezwykłą wiernością naśladować styl programistyczny, idiomy języka C++ czy wzorce projektowe w Rust, ponieważ widział miliardy podobnych sekwencji w publicznych repozytoriach kodu. Nie dokonuje jednak ewaluacji stanu pamięci maszyny wirtualnej, nie śledzi przejść w automatach skończonych ani nie rozwiązuje układów nierówności opisujących warunki brzegowe pętli.
Zjawisko to, określane w literaturze naukowej jako semantyczna przepaść semantic gap, ujawnia się szczególnie jaskrawo przy generowaniu algorytmów optymalizacyjnych, systemów współbieżnych oraz operacji niskopoziomowych na wskaźnikach pamięci. Model LLM potrafi wygenerować z pozoru elegancką implementację kolejki bezblokowej lock-free queue, która przechodzi wszystkie standardowe testy jednostkowe na architekturze x86, lecz w specyficznych warunkach wyścigu na procesorach o słabym modelu spójności pamięci ARM doprowadza do zakleszczenia lub wycieku danych. Dla sieci neuronowej poprawność syntaktyczna jest tożsama z semantyczną, podczas gdy w rzeczywistości program poprawny składniowo może być katastrofalnie błędny w swojej semantyce wykonawczej.
Próby łagodzenia tego problemu za pomocą dostrajania z ludzką informacją zwrotną RLHF czy technik łańcucha myśli Chain-of-Thought CoT stanowią jedynie statystyczne środki zaradcze, które przesuwają rozkład prawdopodobieństwa, lecz nie eliminują ogona błędu. W systemach klasy DO-178C poziomu DAL-A, gdzie prawdopodobieństwo wystąpienia błędu krytycznego musi być niższe niż dziesięć do potęgi minus dziewiątej na godzinę lotu, opieranie się na statystyce jest niedopuszczalne. Odpowiedzią inżynierii oprogramowania nie jest więc lepszy model statystyczny, lecz wprowadzenie zewnętrznego, niezależnego arbitra logicznego, który weryfikuje każdy krok rozumowania maszyny.
Asystenci dowodzenia twierdzeń: Lean 4, Coq i teoria typów zależnych
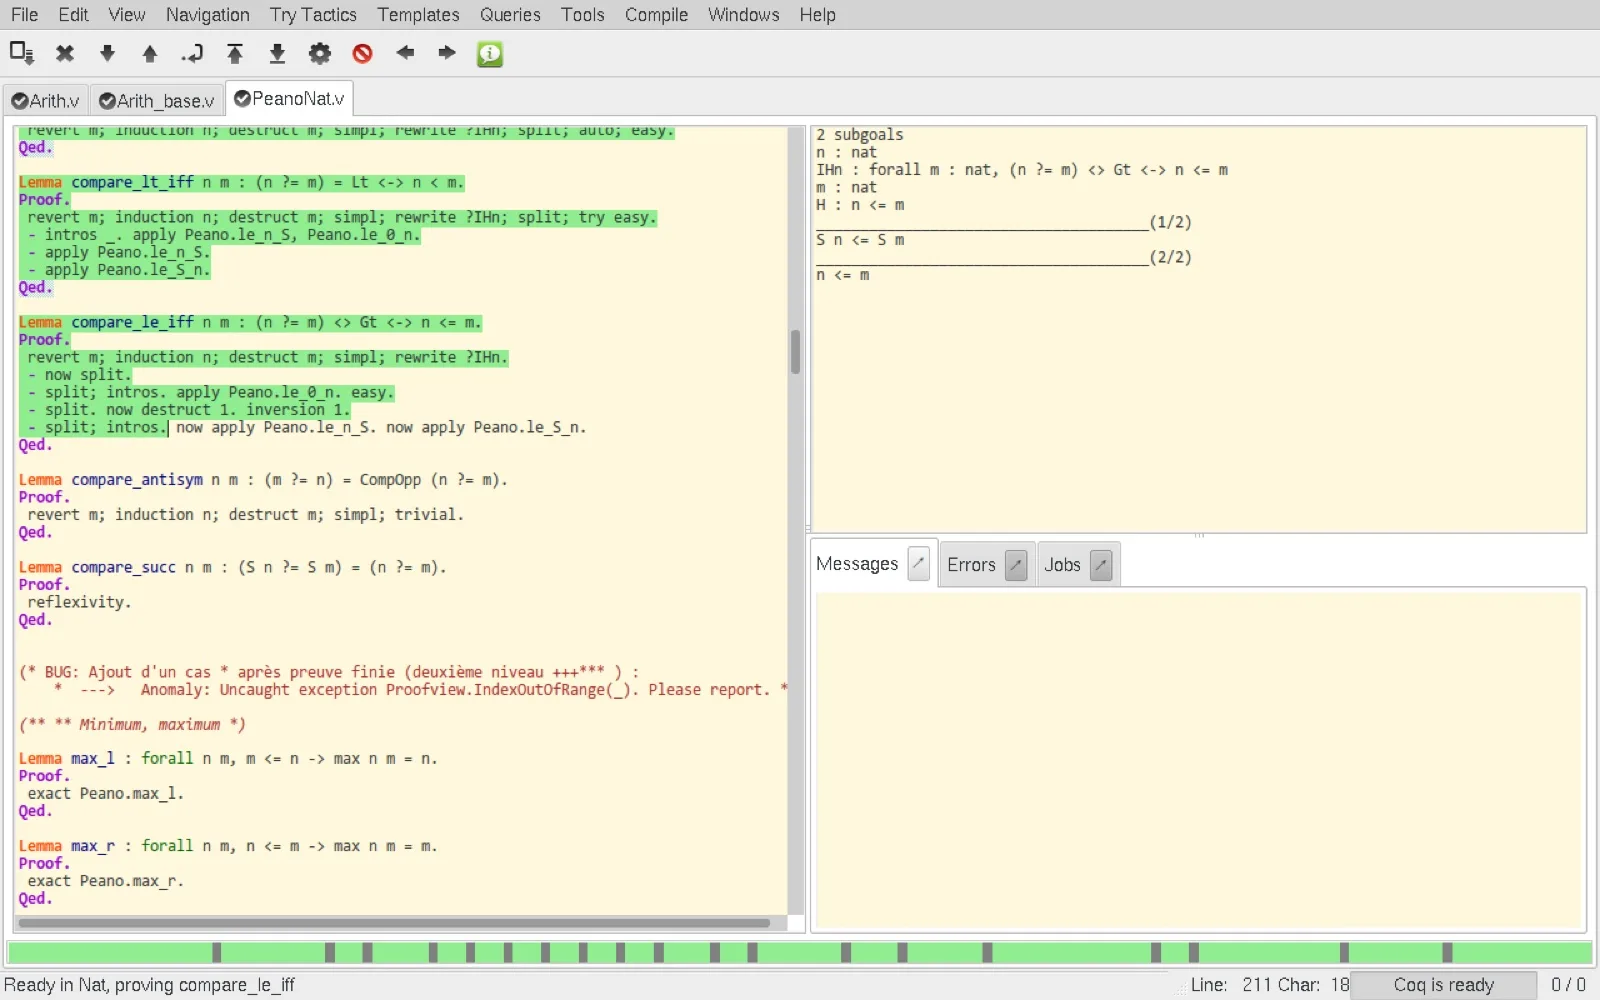
Fundamentem formalnej weryfikacji oprogramowania są interaktywne asystenci dowodzenia Interactive Theorem Provers ITP. Narzędzia te, rozwijane przez dekady w środowiskach akademickich, opierają się na głębokiej izomorficznej tożsamości między matematyką konstruktywną a informatyką teoretyczną, znanej jako korespondencja Curry'ego-Howarda. Zgodnie z tą zasadą twierdzenie matematyczne jest tożsame z typem danych w języku programowania, natomiast poprawny dowód tego twierdzenia jest równoważny programowi komputerowemu, który generuje wartość tego typu. Sprawdzenie poprawności dowodu sprowadza się zatem do sprawdzenia typów w kompilatorze.
W ostatnich latach bezapelacyjnym liderem rewolucji formalizacyjnej stał się język Lean 4, stworzony w Microsoft Research pod kierownictwem Leonardo de Moury. W odróżnieniu od starszych asystentów, takich jak Coq czy Isabelle/HOL, Lean 4 został zaprojektowany od podstaw nie tylko jako system dowodzenia, ale jako nowoczesny, w pełni kompilowalny język funkcyjny ogólnego przeznaczenia z mechanizmem zarządzania pamięcią bez odśmiecacza pamięci RC-bimodal. Lean 4 opiera się na rachunku konstrukcji indukcyjnych Calculus of Inductive Constructions CIC z hierarchią uniwersów typologicznych i typami zależnymi dependent types. Typ zależny to typ, którego definicja zależy od konkretnej wartości, na przykład typ wektora o długości n elementów.
Dzięki typom zależnym inżynier oprogramowania może zapisać w samej sygnaturze funkcji nie tylko typy argumentów wejściowych i wyjściowych, ale pełną specyfikację jej zachowania logicznego. Na przykład funkcja sortująca listę nie zwraca po prostu nowej listy liczb całkowitych, lecz parę składającą się z listy wynikowej oraz formalnego dowodu dwóch własności: że lista wynikowa jest posortowana niemalejąco oraz że jest permutacją listy wejściowej. Jeżeli funkcja zostanie skompilowana przez jądro kompilatora Lean 4, istnieje absolutna gwarancja, że dla każdego możliwego zestawu danych wejściowych zachowa się zgodnie ze specyfikacją. Nie ma tu miejsca na przepełnienie bufora, dzielenie przez zero czy błędy indeksowania poza zakresem tablicy.
W intuicjonistycznej teorii typów Martina-Löfa, leżącej u podstaw Lean 4, pojęcie prawdy jest nierozerwalnie związane z możliwością konstrukcji świadka dowodowego proof witness. Brak aksjomatu wyłączonego środka w logice konstruktywnej sprawia, że każdy dowód istnienia obiektu matematycznego jest w istocie wykonywalnym algorytmem wyliczającym ten obiekt. Dzięki mechanizmowi ekstrakcji kodu programista może automatycznie wygenerować z formalnego dowodu w Lean 4 lub Coq optymalny kod w języku C, OCaml czy Haskell, zachowując stuprocentową pewność, że proces kompilacji nie wprowadził żadnych błędów logicznych obecnych w specyfikacji źródłowej.
Neurosymboliczna pętla sprzężenia zwrotnego: LLM jako generator hipotez
Dlaczego zatem formalna weryfikacja nie wyparła tradycyjnego programowania dekady temu? Powodem była skrajna pracochłonność i bariera wejścia. Ręczne pisanie formalnych dowodów matematycznych dla tysięcy linii kodu źródłowego wymagało lat specjalistycznych studiów z logiki matematycznej i setek godzin żmudnego wprowadzania kroków dowodowych. Dowiedzenie poprawności mikrojądra systemu operacyjnego seL4 w asystencie Isabelle/HOL zajęło zespołowi naukowców z Australii ponad dwadzieścia osobolat pracy.
W tym miejscu pojawia się rewolucyjna synergia paradygmatu neurosymbolicznego. Model LLM zostaje obsadzony w roli kreatywnego generatora hipotez i taktyk dowodowych tactic generator. Sieć neuronowa analizuje cel dowodowy goal state wygenerowany przez asystenta Lean 4 i proponuje sekwencję taktyk, takich jak indukcja strukturalna, upraszczanie równościowe czy przeszukiwanie przestrzeni stanów. Propozycja ta trafia do mikroskopijnego, zaufanego jądra logicznego kernel Lean 4, które liczy zaledwie kilka tysięcy linii kodu i zostało wielokrotnie zweryfikowane.
Jądro logiczne działa w ułamku milisekundy, sprawdzając, czy proponowana przez model taktyka jest poprawna. Jeżeli tak, cel zostaje zredukowany do prostszych podcelów subgoals lub dowód zostaje domknięty słowem kluczowym Qed. Jeżeli natomiast model wygenerował błędny krok dowodowy, halucynując nieistniejącą właściwość algebraiczną, jądro natychmiast odrzuca propozycję i zwraca precyzyjny komunikat o błędzie typowania. Komunikat ten zostaje przekazany z powrotem do kontekstu modelu LLM w pętli wielokrotnego próbkowania Tree-of-Thought lub algorytmu przeszukiwania drzewa Monte Carlo MCTS. Model próbuje ponownie, korygując swoje rozumowanie w oparciu o twarde reguły formalne. W ten sposób halucynacja zostaje uwięziona i zneutralizowana w pętli weryfikacyjnej, zanim jakakolwiek linijka kodu trafi do środowiska produkcyjnego.
Solwery SMT i Z3: Automatyzacja dedukcji w architekturze DPLL(T)
Obok interaktywnych asystentów dowodzenia drugim potężnym filarem weryfikacji neurosymbolicznej są solwery spełnialności teorii Satisfiability Modulo Theories SMT, na czele ze stworzonym przez Microsoft Research solwerem Z3 oraz systemami CVC5 i Vampire. Solwer SMT łączy nowoczesne algorytmy rozwiązywania problemu spełnialności formuł rachunku zdań SAT oparte na architekturze CDCL Conflict-Driven Clause Learning ze specjalizowanymi modułami dedukcyjnymi dedykowanymi konkretnym teoriom matematycznym w ramach paradygmatu DPLL(T).
Architektura DPLL(T) rozdziela proces wnioskowania logicznego na dwa poziomy: moduł SAT zarządza strukturą boolowską problemu, a wyspecjalizowane solwery teorii T-solvers sprawdzają spójność koniunkcji literałów w odniesieniu do praw konkretnej dziedziny. Gdy konieczne jest łączenie wielu różnych teorii, na przykład teorii wektorów bitowych z teorią tablic o swobodnym dostępie, kluczową rolę odgrywa procedura Nelsona-Oppena. Poprzez wzajemną propagację równości zmiennych między niezależnymi modułami decyzyjnymi, solwer SMT potrafi w skończonym czasie udowodnić poprawność formuł, które w ogólnym przypadku logiki pierwszego rzędu są nierozstrzygalne.
Teorie te obejmują bezkwantyfikatorową algebrę bit-wektorów bit-vector arithmetic, modelującą zachowanie rejestrów procesora i operacje bitowe, liniową i nieliniową arytmetykę liczb całkowitych i rzeczywistych, teorię tablic z aksjomatami McCarthy'ego read-over-write oraz teorię funkcji niesinterpretowanych z równością EUF. W architekturze neurosymbolicznej solwery SMT pełnią rolę w pełni zautomatyzowanych wyroczni weryfikacyjnych. Inżynier nie musi prowadzić interaktywnego dowodu krok po kroku: wystarczy, że model LLM wygeneruje specyfikację warunków wstępnych preconditions i końcowych postconditions w logice Hoare'a, a kompilator narzędzia weryfikacji, takiego jak Dafny, F* czy Prusti dla języka Rust, automatycznie tłumaczy kod programu na zbiór warunków weryfikacyjnych Verification Conditions VC.
Warunki te zostają przekazane do solwera Z3 w ujednoliconym formacie SMT-LIB. Solwer w czasie milisekund podejmuje próbę udowodnienia, że negacja warunku weryfikacyjnego jest niespełnialna UNSAT. Jeżeli dowód się powiedzie, kod jest matematycznie poprawny. Jeżeli natomiast warunek jest spełnialny SAT, solwer SMT zwraca nie tylko suchą informację o błędzie, ale generuje konkretny, kontrprzykład kontrmodel counterexample: wektor wartości zmiennych wejściowych, dla których dochodzi do naruszenia założeń, na przykład przepełnienia arytmetycznego lub odwołania do pustego wskaźnika. Taki kontrprzykład jest bezcennym sygnałem zwrotnym dla modelu LLM, który natychmiast modyfikuje kod w celu obsłużenia wskazanego przypadku brzegowego.
Weryfikacja dedukcyjna: Logika Hoare'a i niezmienniki pętli
Praktyczna implementacja weryfikacji neurosymbolicznej w przemyśle oprogramowania opiera się na logice Hoare'a, wprowadzonej przez sir Tony'ego Hoare'a w 1969 roku. Centralną koncepcją tej teorii jest trójka Hoare'a, zapisywana schematycznie jako warunek wstępny P, program Q oraz warunek końcowy R. Znaczenie tej formuły jest następujące: jeżeli przed uruchomieniem programu Q spełniony jest warunek P, to po pomyślnym zakończeniu wykonania programu Q spełniony będzie warunek R.
Najtrudniejszym zadaniem w formalnej weryfikacji algorytmów iteracyjnych i rekurencyjnych jest synteza niezmienników pętli loop invariants. Niezmiennik pętli to relacja logiczna między zmiennymi stanu, która jest prawdziwa przed wejściem do pętli, pozostaje prawdziwa po wykonaniu każdej iteracji i wraz z warunkiem zakończenia pętli pociąga za sobą spełnienie warunku końcowego R. Przez dziesięciolecia odnajdywanie nietrywialnych niezmienników nieliniowych dla skomplikowanych algorytmów numerycznych było domeną wyłącznie wybitnych matematyków.
W paradygmacie neurosymbolicznym synteza niezmienników pętli staje się idealnym zadaniem dla wielkich modeli językowych. LLM, wytrenowany na milionach fragmentów kodu algorytmicznego, wykazuje niezwykłą intuicję geometryczną i algebraiczną, proponując kandydatów na niezmienniki pętli. Każdy zaproponowany niezmiennik jest natychmiast weryfikowany przez solwer SMT w trzech krokach: inicjalizacji, zachowania niezmiennika oraz implikacji końcowej. Połączenie twórczej intuicji sieci neuronowej z mechanicznym sprawdzaniem solwera pozwala na pełną automatyzację weryfikacji algorytmów, które dotychczas uchodziły za zbyt złożone do formalnego dowodu.
Weryfikacja sprzętowa i synteza mikroarchitektury układów scalonych
Zastosowanie paradygmatu neurosymbolicznego nie ogranicza się wyłącznie do oprogramowania wysokiego poziomu, lecz rewolucjonizuje również projektowanie krzemowych układów scalonych ASIC i programowalnych macierzy bramkowych FPGA. W przeciwieństwie do aplikacji software'owych, w których błąd można naprawić łatką OTA Over-The-Air, błąd logiczny wytrawiony w strukturze krzemowej procesora wiąże się ze stratami liczonymi w setkach milionów dolarów i koniecznością wycofania milionów chipów z rynku, czego historycznym przykładem był słynny błąd dzielenia FDIV w procesorach Intel Pentium.
Tradycyjna weryfikacja sprzętowa w językach SystemVerilog i VHDL opierała się na symulacjach pseudolosowych UVM Universal Verification Methodology, które pokrywały jedynie znikomy ułamek astronomicznej przestrzeni stanów nowoczesnego procesora. Nowoczesne podejście neurosymboliczne integruje modele LLM z narzędziami sprawdzania modeli Model Checking opartymi na logice czasu liniowego LTL Linear Temporal Logic i logice drzew obliczeniowych CTL. Systemy te, operując na językach opisu sprzętu nowej generacji, takich jak Chisel czy Bluespec, formułują formalne asercje bezpieczeństwa i żywotności safety and liveness properties.
Algorytmy ograniczonego sprawdzania modeli Bounded Model Checking BMC rozwijają pętle taktujące procesora do zadanej głębokości k cykli zegarowych i przekształcają zachowanie układu w gigantyczną formułę boolowską rozwiązywaną przez solwery SAT. Model LLM analizuje architekturę potoku wykonawczego pipeline rdzenia RISC-V, generując właściwości niezmiennicze dla jednostek przewidywania skoków branch predictors oraz kontrolerów spójności pamięci podręcznej cache coherence. W efekcie inżynierowie otrzymują matematyczny dowód, że mikroprocesor nigdy nie wejdzie w stan zakleszczenia deadlocked ani nie ujawni poufnych danych w wyniku spekulatywnego wykonania instrukcji, co definitywnie eliminuje podatności sprzętowe klasy Spectre i Meltdown.
Certyfikowana kompilacja i wyeliminowanie zachowań niezdefiniowanych
Nawet najbardziej rygorystyczny dowód poprawności kodu źródłowego staje się bezużyteczny, jeżeli kompilator tłumaczący kod na instrukcje procesora wprowadzi błędy semantyczne lub zoptymalizuje program w sposób naruszający intencje autora. Klasyczne kompilatory przemysłowe, takie jak GCC czy LLVM Clang, zawierają miliony linii wysoce złożonego kodu w C++, w którym regularnie odkrywane są błędy generacji kodu oraz agresywne optymalizacje oparte na założeniu o braku zachowań niezdefiniowanych Undefined Behavior UB. W skrajnych przypadkach optymalizator potrafi całkowicie wyciąć procedury czyszczenia kluczy kryptograficznych z pamięci RAM, uznając je za martwy kod.
Rozwiązaniem tego krytycznego problemu jest certyfikowana kompilacja, której najdoskonalszym przykładem jest kompilator CompCert opracowany pod kierownictwem Xaviera Leroya w instytucie Inria. CompCert jest w całości zaprogramowany i zweryfikowany w asystencie Coq. Posiada matematyczny dowód twierdzenia o zachowaniu semantyki semantic preservation theorem: dla każdego poprawnego programu w języku C kod asemblera wygenerowany przez CompCert wykonuje dokładnie te same operacje wejścia-wyjścia i zachowuje identyczny stan pamięci, co program źródłowy. W połączeniu z neurosymboliczną generacją kodu w językach formalnych, certyfikowana kompilacja tworzy nieprzerwany łańcuch matematycznego zaufania od specyfikacji w języku naturalnym aż po bity wykonywane przez krzemowy procesor.
Zastosowania strategiczne: Od mikrojądra seL4 po kryptografię i awionikę
Przejście od akademickich eksperymentów do przemysłowych wdrożeń neurosymbolicznej weryfikacji kodu jest napędzane przez rosnącą presję geopolityczną i cyberwojnę. W systemach obronnych standardem stają się formalnie zweryfikowane mikrojądra systemów operacyjnych, z których najważniejszym jest seL4. Mikrojądro to posiada matematyczny dowód integralności pamięci i izolacji procesów na poziomie kodu maszynowego. W połączeniu z neurosymboliczną generacją bezpiecznych sterowników urządzeń możliwe staje się budowanie systemów pokładowych dla dronów bojowych i satelitów rozpoznawczych, w których fizycznie wykluczone są exploity eskalacji uprawnień privilege escalation czy ataki wstrzykiwania kodu.
Równie rewolucyjne zmiany zachodzą w dziedzinie kryptografii postkwantowej i bezpieczeństwa transakcyjnego. Biblioteki kryptograficzne, takie jak HACL* rozwijana w ramach projektu Everest przez Inria i Microsoft Research, są w całości pisane w językach specyfikacji formalnej F* i automatycznie kompilowane do bezpiecznego kodu w C. Weryfikacja formalna gwarantuje nie tylko matematyczną poprawność implementacji algorytmów szyfrowania Kyber czy Dilithium, ale również ich odporność na ataki kanałami bocznymi side-channel attacks poprzez formalny dowód stałego czasu wykonania constant-time execution, niezależnego od wartości przetwarzanych kluczy prywatnych.
W sektorze energetyki jądrowej oraz lotnictwa cywilnego agencje certyfikujące FAA i EASA przygotowują nowe ramy regulacyjne uwzględniające sztuczną inteligencję w procesach wytwórczych. Czysty kod wygenerowany przez LLM nigdy nie uzyska certyfikatu DAL-A dla awioniki Boeinga czy Airbusa. Jednak kod wygenerowany przez model neurosymboliczny, któremu towarzyszy czytelny maszynowo certyfikat dowodu proof certificate wygenerowany w asystencie Lean 4 lub Coq, może zostać zweryfikowany przez niezależny audytor logiczny w kilka sekund. Oznacza to radykalne skrócenie cyklu wdrożeniowego nowego oprogramowania lotniczego z lat do tygodni przy jednoczesnym podniesieniu standardu bezpieczeństwa na poziom niedostępny dla tradycyjnych metod inżynierskich.
Neurosymboliczna sztuczna inteligencja nie jest jedynie kolejnym ulepszeniem architektury sieci neuronowych, lecz fundamentalną redefinicją pojęcia niezawodności w świecie cyfrowym. Łącząc statystyczną biegłość generatywnej AI z wieczną pewnością praw logiki matematycznej, tworzymy technologię zdolną nie tylko do pisania kodu, ale do zagwarantowania, że stworzone przez człowieka i maszynę systemy krytyczne będą działały bezbłędnie zawsze, wszędzie i bez wyjątku.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.