
Modele świata World Models i inteligencja przestrzenna w robotyce humanoidalnej: Jak architektury VLA, symulacje fizyczne GPU i transfer Sim-to-Real redefiniują autonomię maszyn
Nowy paradygmat ucieleśnionej sztucznej inteligencji
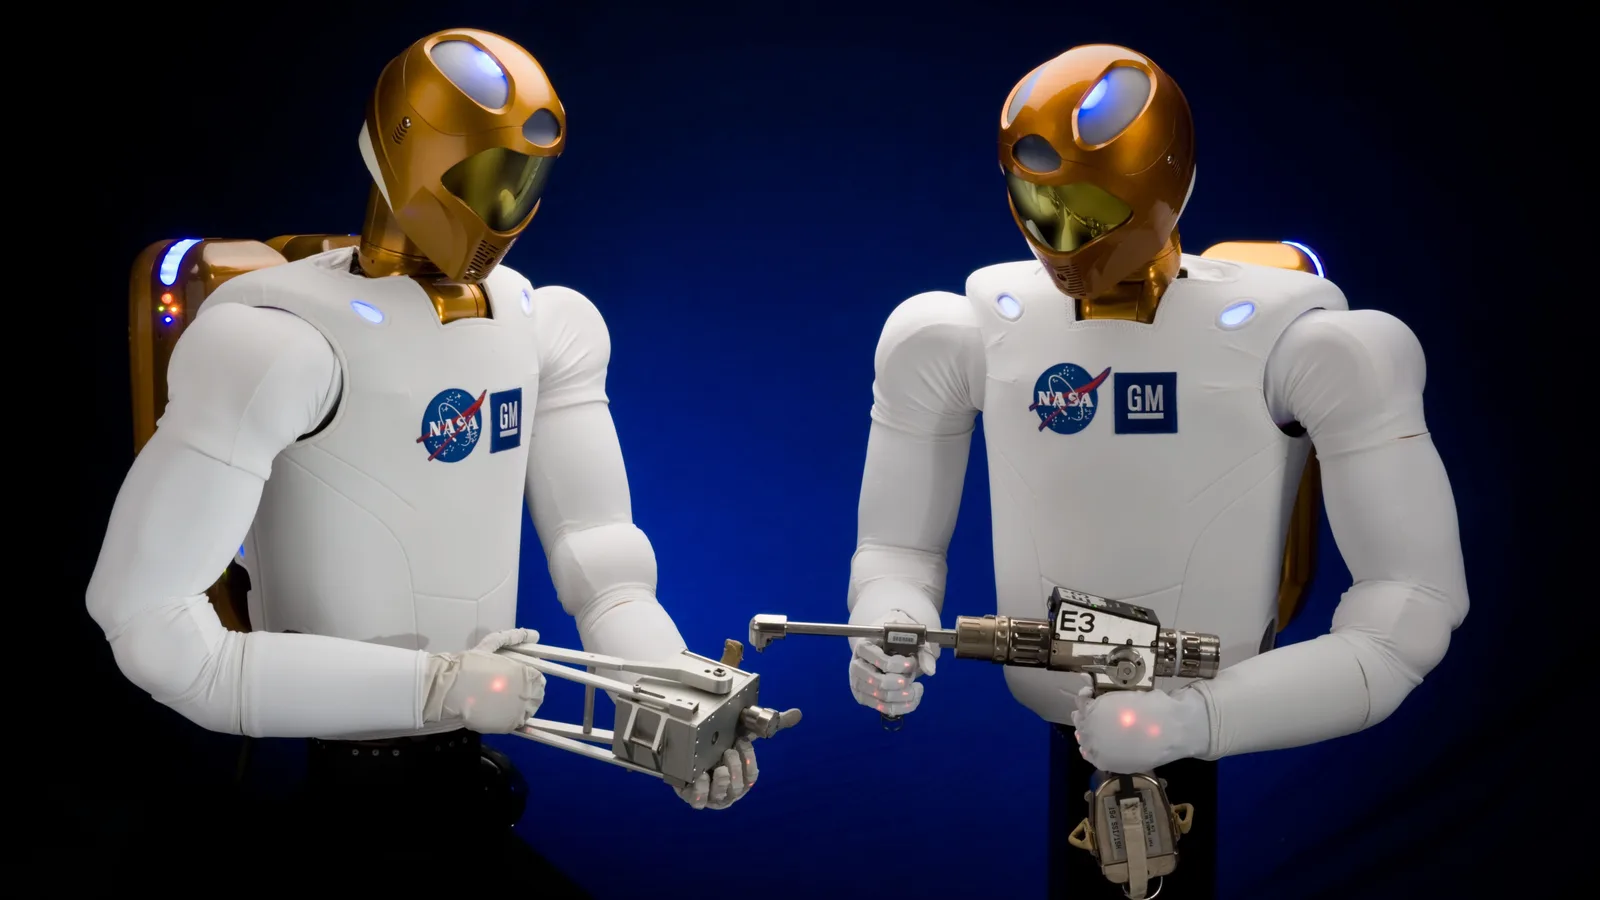
Współczesna robotyka przez całe dekady borykała się z problemem kruchości algorytmów sterowania. Klasyczne podejście opierające się na precyzyjnym modelowaniu kinematyki odwrotnej, ręcznie definiowanych trajektoriach ruchu oraz sztywnych maszynach stanów zdawało egzamin wyłącznie w sterylnych, wysoce powtarzalnych warunkach fabrycznych. Gdy tylko ramię manipulacyjne lub dwunożna platforma mobilna stykała się z nieprzewidzianą przeszkodą, zmiennym oświetleniem, nieznaną geometrią przedmiotu bądź zjawiskiem poślizgu, tradycyjne systemy deterministyczne ulegały natychmiastowej awarii. Odpowiedzią na ten fundamentalny impas jest koncepcja ucieleśnionej sztucznej inteligencji, w której kluczową rolę odgrywają generatywne modele świata oraz przestrzenna percepcja trójwymiarowa.
Modele świata stanowią konceptualną ewolucję mechanizmów predykcyjnych znanych z neuronauki. Organizm biologiczny nie przetwarza każdego bodźca zmysłowego od zera, lecz bezustannie konfrontuje napływające dane sensoryczne z wewnętrzną symulacją rzeczywistości. Zdolność do antycypowania skutków własnych działań motorycznych przed ich fizycznym zainicjowaniem stanowi fundament bezpieczeństwa i efektywności energetycznej człowieka. W przypadku robotów humanoidalnych implementacja wewnętrznego symulatora dynamiki fizycznej pozwala na prowadzenie wyobrażonych eksperymentów w ukrytej przestrzeni cech (latent space), minimalizując ryzyko uszkodzenia mechanizmów oraz drastycznie przyspieszając proces podejmowania decyzji w środowiskach nieustrukturyzowanych.
W tym ujęciu model świata nie jest zwykłym rejestratorem przeszłych stanów sensorycznych, lecz staje się dynamicznym generatorem prawdopodobnych przyszłości. Zamiast czekać na fizyczną kolizję dłoni z krawędzią stołu, sieć neuronowa w ułamku sekundy przeprowadza symulację kontaktu wewnątrz własnej architektury tensorowej. Tego rodzaju antycypacja pozwala na natychmiastową modulację siły docisku, dynamiczną zmianę sztywności wirtualnych sprężyn w algorytmach sterowania impedancyjnego oraz płynną kompensację bezwładności masy manipulowanego obiektu. Jest to zasadnicza zmiana filozofii inżynieryjnej, przechodząca od reaktywnego korygowania błędów do proaktywnego kształtowania trajektorii w oparciu o probabilistyczne prawa fizyki.
Równolegle dochodzi do przełomu w postrzeganiu samej relacji pomiędzy percepcją a działaniem. Przez lata dominował podział na niezależne moduły: system wizyjny tworzył trójwymiarową mapę otoczenia, planista geometryczny wyznaczał bezkolizyjną trajektorię, a regulator PID dążył do minimalizacji uchybu na enkoderach silników. W architekturze zintegrowanego modelu świata granice te ulegają zatarciu. Percepcja jest nierozerwalnie sprzężona z działaniem motorycznym, a każda zmiana kąta widzenia kamery czy dotknięcie powierzchni palcem jest jednocześnie aktem poznawczym służącym redukcji entropii w wewnętrznej reprezentacji otoczenia. Dzięki temu robot nie tylko działa w środowisku, ale aktywnie bada jego właściwości fizyczne poprzez celowe mikrointerakcje mechaniczne.
Architektury wizyjno-językowo-działaniowe Vision-Language-Action
Integracja multimodalnych modeli wielkoskalowych z układami wykonawczymi doprowadziła do wyłonienia się nowej klasy sieci neuronowych określanych jako modele Vision-Language-Action (VLA). Tradycyjne systemy wizyjne dokonywały jedynie semantycznej segmentacji obrazu bądź detekcji prostokątów otaczających obiekty, przekazując te abstrakcyjne dane do zewnętrznych modułów planowania ruchu. Architektury VLA, wywodzące się z pionierskich rozwiązań takich jak Google RT-2, Octo czy OpenVLA, traktują działania motoryczne robota jako kolejny modalny token w sekwencji językowo-wizualnej. Dzięki takiemu podejściu sieć neuronowa pobiera surowy strumień wideo z kamer stereoskopowych, przetwarza instrukcję głosową użytkownika i bezpośrednio w kolejnym kroku wnioskowania generuje dyskretne lub ciągłe polecenia sterujące dla przegubów serwomotorów.
Kluczową innowacją w modelach VLA jest zunifikowana reprezentacja przestrzenna. Zamiast operować na arbitralnych współrzędnych kartezjańskich w układzie bazowym, model uczy się bezpośrednich korelacji pomiędzy cechami wizualnymi obiektu a trajektoriami chwytaka w sześciu stopniach swobody. Oznacza to, że pojęcie chwytania filiżanki za ucho nie jest zakodowane za pomocą warunków brzegowych w kodzie sterownika, lecz stanowi uogólnioną właściwość geometryczną przyswojoną podczas treningu na milionach demonstracji manipulacyjnych. Co więcej, zdolność transferu wiedzy semantycznej z potężnych modeli językowych sprawia, że robot bez dodatkowego treningu rozumie metaforyczne instrukcje, potrafi zidentyfikować przedmiot na podstawie jego funkcji użytkowej oraz radzi sobie z nietypowymi relacjami przestrzennymi w otoczeniu domowym lub przemysłowym.
Współczesne modele VLA odchodzą od prymitywnego generowania pojedynczych wektorów przemieszczeń na rzecz techniki Action Chunking with Transformers (ACT) oraz sprzężonych z nimi polityk dyfuzyjnych. W praktyce oznacza to, że w jednym kroku inferencyjnym sieć nie decyduje jedynie o natychmiastowym przesunięciu dłoni o milimetr, lecz przewiduje spójną, czasowo skorelowaną sekwencję trajektorii obejmującą horyzont od kilkudziesięciu do kilkuset milisekund. Pozwala to na eliminację zjawiska szarpania ruchem, które było plagą wczesnych modeli neuronowych operujących krok po kroku. Ciągłe prognozowanie całych trajektorii gwarantuje płynność kinematyczną, zmniejsza obciążenie dynamiczne przekładni redukcyjnych i umożliwia naturalne łączenie poszczególnych faz manipulacji w jeden harmonijny gest roboczy.
Architektury JEPA i uczenie reprezentacji ukrytej dynamiki
Fundamentalnym problemem generatywnych modeli wideo stosowanych do symulowania świata jest ich tendencja do marnowania zasobów obliczeniowych na nieistotne detale tła. Jeżeli robot manipuluje śrubą na stole montażowym, ruch cieni na ścianie odległej o dziesięć metrów lub mikrofluktuacje oświetlenia jarzeniowego nie mają żadnego znaczenia dla powodzenia zadania. Klasyczne modele autoregresyjne, które rekonstruują obraz na poziomie poszczególnych pikseli, tracą większość przepustowości matematycznej na odtwarzanie szumu wizualnego. Rozwiązaniem tego dylematu stała się architektura Joint Embedding Predictive Architecture (JEPA), postulowana między innymi przez Yanna LeCuna i intensywnie rozwijana w środowiskach robotycznych.
W architekturze JEPA model nie próbuje generować fotorealistycznych klatek obrazu w przestrzeni pikselowej. Zamiast tego enkoder wizualny przekształca obraz sensoryczny w gęstą przestrzeń ukrytą (latent embedding), w której zachowane zostają wyłącznie informacje kluczowe dla geometrii, relacji przestrzennych i praw mechaniki. Predyktor modelu uczy się przewidywać kolejny wektor stanu w przestrzeni cech pod wpływem zaaplikowanego działania motorycznego. W ten sposób sieć całkowicie ignoruje niestabilne artefakty wizualne, skupiając całą uwagę na istotnych gradientach dynamicznych. Rezultatem jest drastyczne obniżenie złożoności obliczeniowej oraz wyeliminowanie powszechnego zjawiska halucynacji geometrycznych, które w tradycyjnych sieciach generatywnych prowadziło do deformowania wirtualnych obiektów.
Podejście bezpikselowe okazuje się szczególnie wydajne w zadaniach wymagających planowania długoterminowego. Model świata operujący w zwartej przestrzeni latentnej jest w stanie w ułamku sekundy przetestować setki alternatywnych sekwencji działań, wykorzystując algorytmy optymalizacji trajektorii takie jak Model Predictive Path Integral (MPPI) czy zaawansowane warianty przeszukiwania drzewa Monte Carlo. Zamiast generować kosztowne klatki wideo, algorytm wykonuje proste operacje macierzowe na zwięzłych wektorach reprezentacji, identyfikując ścieżki o najniższym koszcie energetycznym i minimalnym ryzyku kolizyjnym. Dzięki temu humanoidalny robot może planować skomplikowane operacje montażowe z horyzontem czasowym sięgającym kilkunastu sekund w przód, zachowując pełną responsywność na nieoczekiwane zmiany w bezpośrednim otoczeniu.
Symulacje fizyczne GPU i akceleracja uczenia ze wzmocnieniem
Zgromadzenie milionów godzin fizycznych doświadczeń manipulacyjnych na rzeczywistych platformach robotycznych jest fizycznie niemożliwe, ekonomicznie nieopłacalne oraz obarczone ciągłym ryzykiem mechanicznego zużycia prototypów. Pojedynczy upadek ważącego siedemdziesiąt kilogramów humanoida może zniszczyć precyzyjne serwonapędy harmoniczne, uszkodzić czujniki sił i momentów w stopach oraz wygenerować straty finansowe idące w dziesiątki tysięcy dolarów. Przełomem, który umożliwił eksplozję wydajności modeli ucieleśnionych, stało się przeniesienie całego potoku treningowego do środowisk symulacyjnych uruchamianych bezpośrednio na klastrach procesorów graficznych.
Środowiska nowej generacji, takie jak NVIDIA Isaac Gym, Isaac Sim oparte na platformie Omniverse, silnik MuJoCo sprzężony z biblioteką JAX (MJX) oraz symulatory oparte na bibliotece Genesis, całkowicie eliminują wąskie gardło komunikacji pomiędzy procesorem głównym a kartą graficzną. W tradycyjnych symulatorach stany fizyczne były obliczane na CPU, po czym przesyłano je przez magistralę PCIe do karty graficznej w celu wykonania kroków wstecznej propagacji sieci neuronowej. W nowoczesnych ekosystemach GPU zarówno równania dynamiki bryły sztywnej, detekcja kolizji siatkowych, mechanika kontaktu, jak i sama sieć neuronowa wykonują się w pamięci HBM procesora graficznego. Pozwala to na równoległe symulowanie od dziesięciu do nawet stu tysięcy instancji robotów na pojedynczym serwerze wyposażonym w nowoczesne akceleratory.
Dzięki potężnemu zrównolegleniu obliczeń na rdzeniach Tensor, symulator osiąga współczynnik przyspieszenia czasu rzędu setek tysięcy razy w stosunku do czasu rzeczywistego. Robot humanoidalny w ciągu zaledwie kilkunastu godzin treningu metodami głębokiego uczenia ze wzmocnieniem (Deep Reinforcement Learning) jest w stanie zgromadzić doświadczenie motoryczne odpowiadające dziesięcioleciom ciągłego chodu w skrajnie zróżnicowanym terenie. W symulacji maszyna uczy się odzyskiwania równowagi po potknięciu o niewidoczną krawędź, dynamicznego wbiegania po schodach, kompensacji bezwładności tułowia podczas gwałtownego zwrotu oraz skoordynowanej pracy ramion podczas przenoszenia ciężkich elementów asymetrycznych. Błędy, które w świecie realnym oznaczałyby zniszczenie mechaniki, w środowisku wirtualnym są jedynie ujemną nagrodą w funkcji celu, zmuszającą algorytm do natychmiastowej korekty wag synaptycznych.
Złamanie bariery Sim-to-Real za pomocą Domain Randomization
Mimo kolosalnej mocy obliczeniowej symulatorów fizycznych, fundamentalną barierą we wdrażaniu modeli na rzeczywistym sprzęcie pozostawała tak zwana luka rzeczywistości (Sim-to-Real gap). Nawet najbardziej zaawansowany silnik fizyczny nie odzwierciedla w sposób idealny mikrodrgań przekładni falowych, opóźnień magistrali EtherCAT, histerezy temperaturowej uzwojeń silników bezszczotkowych, a także zróżnicowanych współczynników tarcia czy nieregularności podłoża. W efekcie polityka sterowania wyuczona w nieskazitelnej matematycznie symulacji potrafiła spektakularnie zawieść w momencie wdrożenia na prawdziwym robocie, wykazując oscylacje rezonansowe lub całkowitą utratę stabilności chodu.
Kluczem do przezwyciężenia tej bariery okazała się zaawansowana technika randomizacji dziedziny (Domain Randomization) połączona z precyzyjnym modelowaniem szumów dynamicznych. Podczas treningu na klastrze GPU parametry symulowanego środowiska są poddawane nieustannej, chaotycznej perturbacji w losowo generowanych zakresach. Symulator w każdej epoce treningowej modyfikuje masy poszczególnych członów robota, lokalizację środka ciężkości, współczynniki tarcia statycznego i kinetycznego, luz międzyzębny w przekładniach, opóźnienia w pętli sprzężenia zwrotnego, a także tekstury powierzchni, kierunki padania cieni i intensywność oświetlenia sceny. Polityka neuronowa trenowana w tak ekstremalnie zróżnicowanych warunkach zmuszona jest do wypracowania niezmienników sterowania i strategii wysoce odpornych na zaburzenia.
Równie istotnym elementem zamykania luki rzeczywistości jest wstrzykiwanie sztucznego opóźnienia i zniekształceń do pętli czujnikowej. W świecie rzeczywistym dane z jednostki IMU docierają z minimalnym przesunięciem fazowym, pomiary enkoderów optycznych zawierają szum kwantyzacji, a magistrale cyfrowe doświadczają fluktuacji czasu dostarczenia pakietów danych. Trenując model w warunkach, w których opóźnienia sygnałów losowo wahają się w przedziale od kilku do kilkunastu milisekund, zmusza się sieć do wykształcenia wewnętrznych filtrów estymacyjnych zbliżonych do klasycznego filtru Kalmana. Gdy tak przygotowany model zostaje wgrany do komputera pokładowego rzeczywistego humanoida, realny świat fizyczny okazuje się po prostu kolejną, w pełni przyswajalną wariacją znanego ze środowiska wirtualnego rozkładu prawdopodobieństwa.
Inteligencja przestrzenna i multimodalna rekonstrukcja 3D
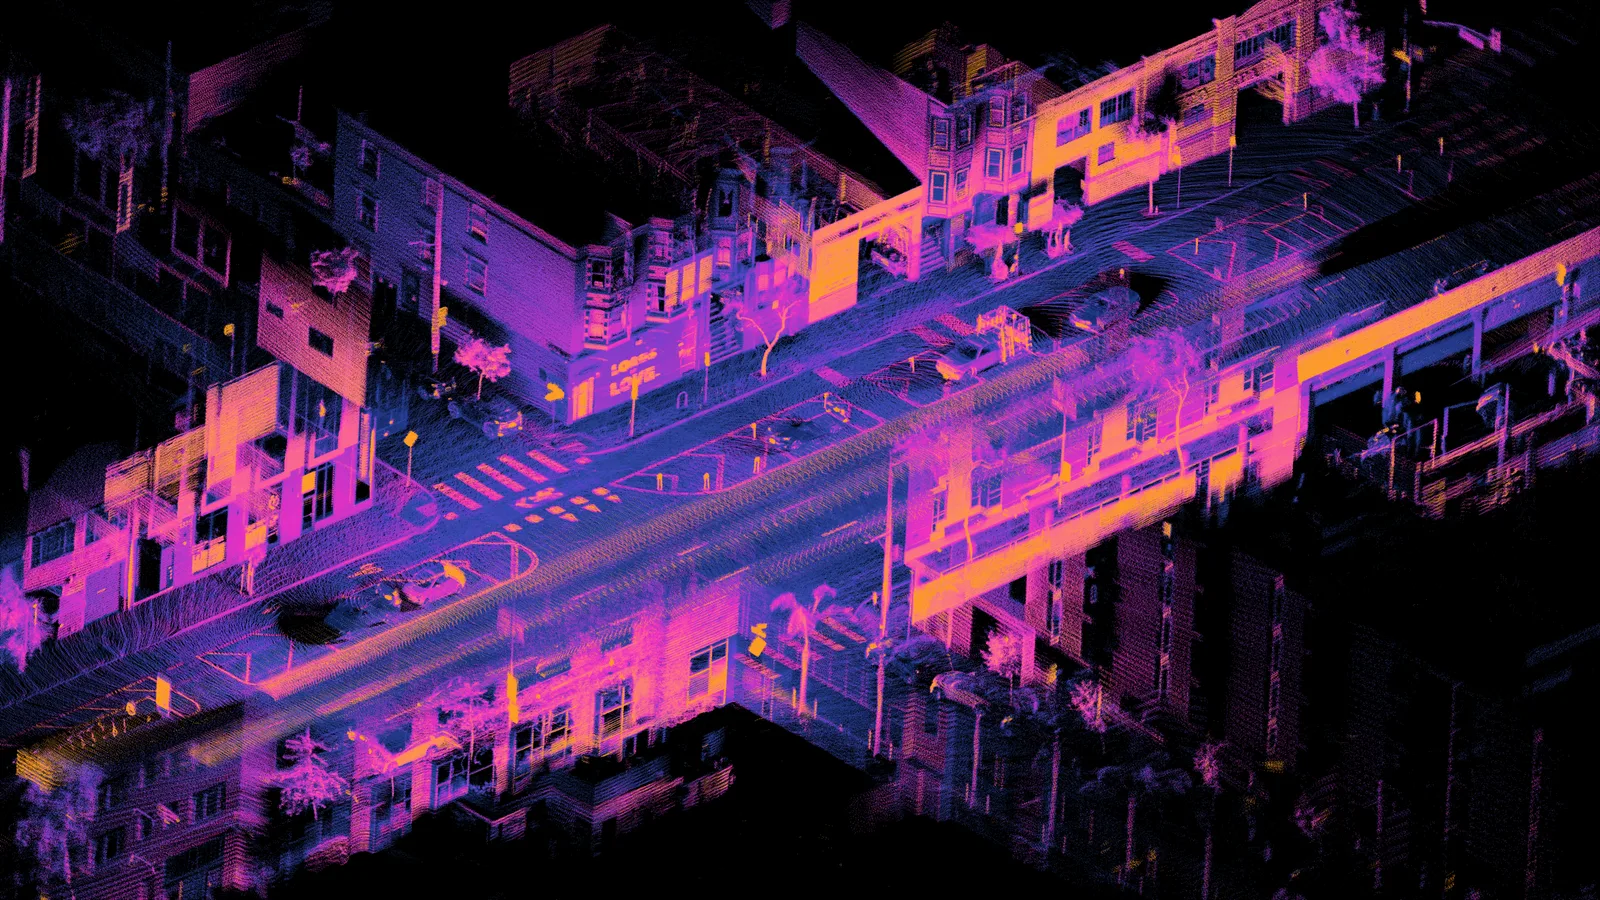
Podstawą skutecznego modelu świata jest nie tylko przewidywanie praw dynamiki, ale przede wszystkim precyzyjna, trójwymiarowa rekonstrukcja geometrii otoczenia w czasie rzeczywistym. Standardowe kamery RGB dostarczają jedynie dwuwymiarowej projekcji, która maskuje głębię, dystrybucję objętościową oraz relacje okluzji. Człowiek radzi sobie z tym problemem dzięki binokularnemu widzeniu stereoskopowemu oraz wrodzonemu aparatowi przedsionkowemu. W robotyce humanoidalnej konieczne jest zintegrowanie wielu komplementarnych modalności sensorycznych, obejmujących kamery o wysokiej dynamice tonalnej, lidary półprzewodnikowe oraz moduły czasu przelotu wiązki fotonów.
W ostatnich latach obserwujemy dynamiczny odwrót od tradycyjnych, statycznych map zajętości wokselowej (Occupancy Grids) na rzecz ciągłych pól reprezentacji geometrycznych, takich jak NeRF (Neural Radiance Fields) oraz technologii 3D Gaussian Splatting dostosowanej do przetwarzania w locie na krawędzi sieci. Robot humanoidalny poruszający się po pomieszczeniu dokonuje ciągłej aktualizacji zestawu trójwymiarowych elipsoid gaussowskich, które precyzyjnie opisują geometrię i właściwości odbicia światła każdego elementu otoczenia. W przeciwieństwie do tradycyjnych siatek trójkątów, reprezentacja gaussowska pozwala na błyskawiczne wyznaczanie gradientów odległości i powierzchni, co ma fundamentalne znaczenie dla bezkolizyjnego planowania ruchu ramion.
Zastosowanie reprezentacji 3D Gaussian Splatting pozwala maszynie na natychmiastowe antycypowanie niewidocznych fragmentów przedmiotów. Na podstawie fragmentarycznego widoku kubka stojącego na biurku, model świata rekonstruuje pełną trójwymiarową geometrię obiektu, ekstrapolując kształt ucha i tylnej ścianki w oparciu o wyuczone aprioryczne relacje przestrzenne. Umożliwia to precyzyjne zaplanowanie chwytu bez konieczności obchodzenia przedmiotu dookoła w celu inspekcji wizualnej. Co więcej, połączenie geometrii gaussowskiej z wektorami semantycznymi pozwala robotowi na natychmiastową lokalizację pojęciową, na przykład zidentyfikowanie w chmurze punktów strefy przeznaczonej do chwytania narzędzia, powierzchni wrażliwej na nacisk lub krawędzi grożącej poślizgiem.
Integracja systemów sterowania całego ciała Whole-Body Control
Nawet najbardziej wyrafinowany model świata i precyzyjna architektura VLA nie osiągną sukcesu bez doskonałej harmonizacji z niskopoziomowym sterowaniem dynamicznym. W robotach humanoidalnych standardem staje się ściśle zhierarchizowana architektura wielopoziomowa. Na najwyższym szczeblu działają modele percepcji semantycznej, interpretacji języka i modeli świata, pracujące w pętli asynchronicznej z częstotliwością od dziesięciu do trzydziestu herców. Na szczeblu pośrednim funkcjonują algorytmy sterowania predykcyjnego (Model Predictive Control, MPC), wyznaczające siły reakcji podłoża z częstotliwością rzędu stu herców. Na samym dole hierarchii operują deterministyczne sterowniki całego ciała (Whole-Body Control, WBC), zamykające pętle prądowe i momentowe serwomechanizmów w rygorystycznym reżimie twardego czasu rzeczywistego z częstotliwością od tysiąca do dwóch tysięcy herców.
Głównym zadaniem kontrolera Whole-Body Control jest rozwiązywanie w czasie rzeczywistym zadań optymalizacji kwadratowej (Quadratic Programming, QP) z uwzględnieniem ścisłych ograniczeń fizycznych. Należą do nich limity maksymalnych momentów obrotowych serwomotorów, dopuszczalne kąty wychylenia przegubów, granice tarcia w punktach podparcia stóp oraz warunek utrzymania środka nacisku (Zero Moment Point, ZMP) wewnątrz stabilnego wielokąta podparcia. Kiedy sieć neuronowa wysokiego poziomu generuje instrukcję dynamicznego podniesienia ciężkiego ładunku z ziemi, to właśnie sterownik WBC dokonuje dekompozycji tego polecenia na mikroruchy wszystkich przegubów ciała, korygując wygięcie kręgosłupa i ugięcie kolan w taki sposób, aby maszyna nie utraciła równowagi pod wpływem nagłego przesunięcia środka ciężkości.
Takie rozdzielenie kompetencji tworzy niezawodną warstwę zabezpieczającą. Jeżeli model VLA z powodu nieprzewidzianego zakłócenia wizualnego wygeneruje gwałtowne lub błędne polecenie ruchu, algorytm WBC automatycznie obetnie składowe trajektorii zagrażające stabilności fizycznej platformy. W ten sposób chroni się mechaniczną integralność robota przed skutkami halucynacji sieci neuronowych, łącząc elastyczność i inteligencję modeli generatywnych z żelaznym rygorem klasycznej teorii sterowania i fizyki newtonowskiej.
Sprzętowe fundamenty inteligencji ucieleśnionej
Skuteczna implementacja modeli świata w robotach humanoidalnych nie byłaby możliwa bez równoległej rewolucji w dziedzinie sprzętu elektromechanicznego i krzemowych akceleratorów obliczeniowych. Przez lata humanoidalne platformy badawcze cierpiały na chroniczny deficyt gęstości mocy. Tradycyjne silniki elektryczne sprzężone z przekładniami o wysokim przełożeniu charakteryzowały się gigantyczną bezwładnością wirnika, podatnością na uszkodzenia udarowe oraz brakiem podatności zwrotnej (backdrivability), co uniemożliwiało precyzyjne sterowanie siłowe bez stosowania drogich i podatnych na awarie czujników tensometrycznych.
Współczesna generacja robotów humanoidalnych bazuje na siłownikach quasi-bezpośrednich (Quasi-Direct Drive, QDD) lub kompaktowych przekładniach planetarnych i falowych o niskim przełożeniu, napędzanych przez zoptymalizowane silniki bezszczotkowe o wysokim momencie obrotowym. Kluczowym elementem tych napędów są zintegrowane inwertery oparte na tranzystorach z azotku galu (GaN) oraz węglika krzemu (SiC). Zastosowanie półprzewodników szerokopasmowych pozwala na przełączanie prądów z częstotliwościami przekraczającymi sto kiloherców przy minimalnych stratach termicznych, co umożliwia upakowanie elektroniki mocy bezpośrednio w obudowie przegubu robota, drastycznie redukując masę i złożoność wiązek kablowych.
Równie spektakularny postęp nastąpił w obszarze sensoryki dotykowej i propriocepcji. Humanoidy nowej ery wyposażane są w syntetyczne skóry dotykowe oparte na matrycach piezoresystancyjnych i optycznych czujnikach odkształceń, które pokrywają dłonie oraz palce manipulatorów. Informacje o mikropoślizgach i rozkładzie wektorów sił są przetwarzane lokalnie przez dedykowane mikrokontrolery i przekazywane do modelu świata. W połączeniu z pokładowymi modułami obliczeniowymi AI, montowanymi bezpośrednio w korpusie maszyny i zasilanymi z wysokonapięciowych baterii litowo-jonowych, robot staje się w pełni samowystarczalną jednostką kognitywno-wykonawczą zdolną do ciągłej pracy przez wiele godzin bez konieczności podłączania zewnętrznych kabli zasilających czy stacji bazowych.
Wdrożenia przemysłowe i horyzont pełnej autonomii
Transformacja z fazy laboratoryjnych eksperymentów do komercyjnych wdrożeń przemysłowych następuje w tempie przewyższającym najśmielsze prognozy analityków. Wiodące koncerny motoryzacyjne, borykające się ze strukturalnym niedoborem wykwalifikowanej siły roboczej oraz rosnącymi kosztami ergonomii pracy, już dziś wprowadzają humanoidalne platformy do pilotażowej pracy na liniach produkcyjnych. Maszyny wyposażone w modele świata i architektury VLA realizują zadania precyzyjnego pozycjonowania komponentów karoserii, układania wiązek elektrycznych w trudno dostępnych profilach podwozia oraz autonomicznego transportu ciężkich matryc tłoczących w środowiskach, w których wózki autonomiczne AGV okazały się zbyt mało elastyczne.
Najważniejszym wskaźnikiem dojrzałości technologicznej jest czas adaptacji robota do zupełnie nowego zadania. Podczas gdy w tradycyjnej automatyce przemysłowej przeprogramowanie linii montażowej pod nowy model pojazdu wymagało wielotygodniowych prac inżynieryjnych, integracji nowych chwytaków i żmudnego definiowania punktów bazowych, robot humanoidalny nowej generacji potrzebuje zaledwie kilkudziesięciu minut demonstracji przeprowadzonej w środowisku wirtualnym lub za pośrednictwem gogli rozszerzonej rzeczywistości przez pracownika fabryki. Wewnętrzny model świata przetwarza demonstrację, identyfikuje geometryczne i fizyczne niezmienniki zadania, przeprowadza serię symulowanych prób transferu Sim-to-Real i przystępuje do autonomicznego wykonywania operacji na rzeczywistej linii produkcyjnej.
Ewolucja ta otwiera drogę do ostatecznego zatarcia granicy pomiędzy światem cyfrowej inteligencji a realną gospodarką wytwórczą. W perspektywie najbliższej dekady modele świata zintegrowane z robotami o wysokiej sprawności motorycznej staną się fundamentem nowej architektury przemysłowej, w której maszyny posiądą zdolność do ciągłego samodoskonalenia, intuicyjnej naprawy uszkodzonych elementów infrastruktury oraz bezpiecznej, synergicznej współpracy z ludzkimi zespołami w najbardziej złożonych procesach technologicznych naszej cywilizacji.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.