
Modele świata World Models i fuzja sensoryczna w robotyce humanoidalnej: Jak multimodalne sieci JEPA, dyfuzyjne zasady sterowania i symulatory fizyki redefiniują manipulację zręczną
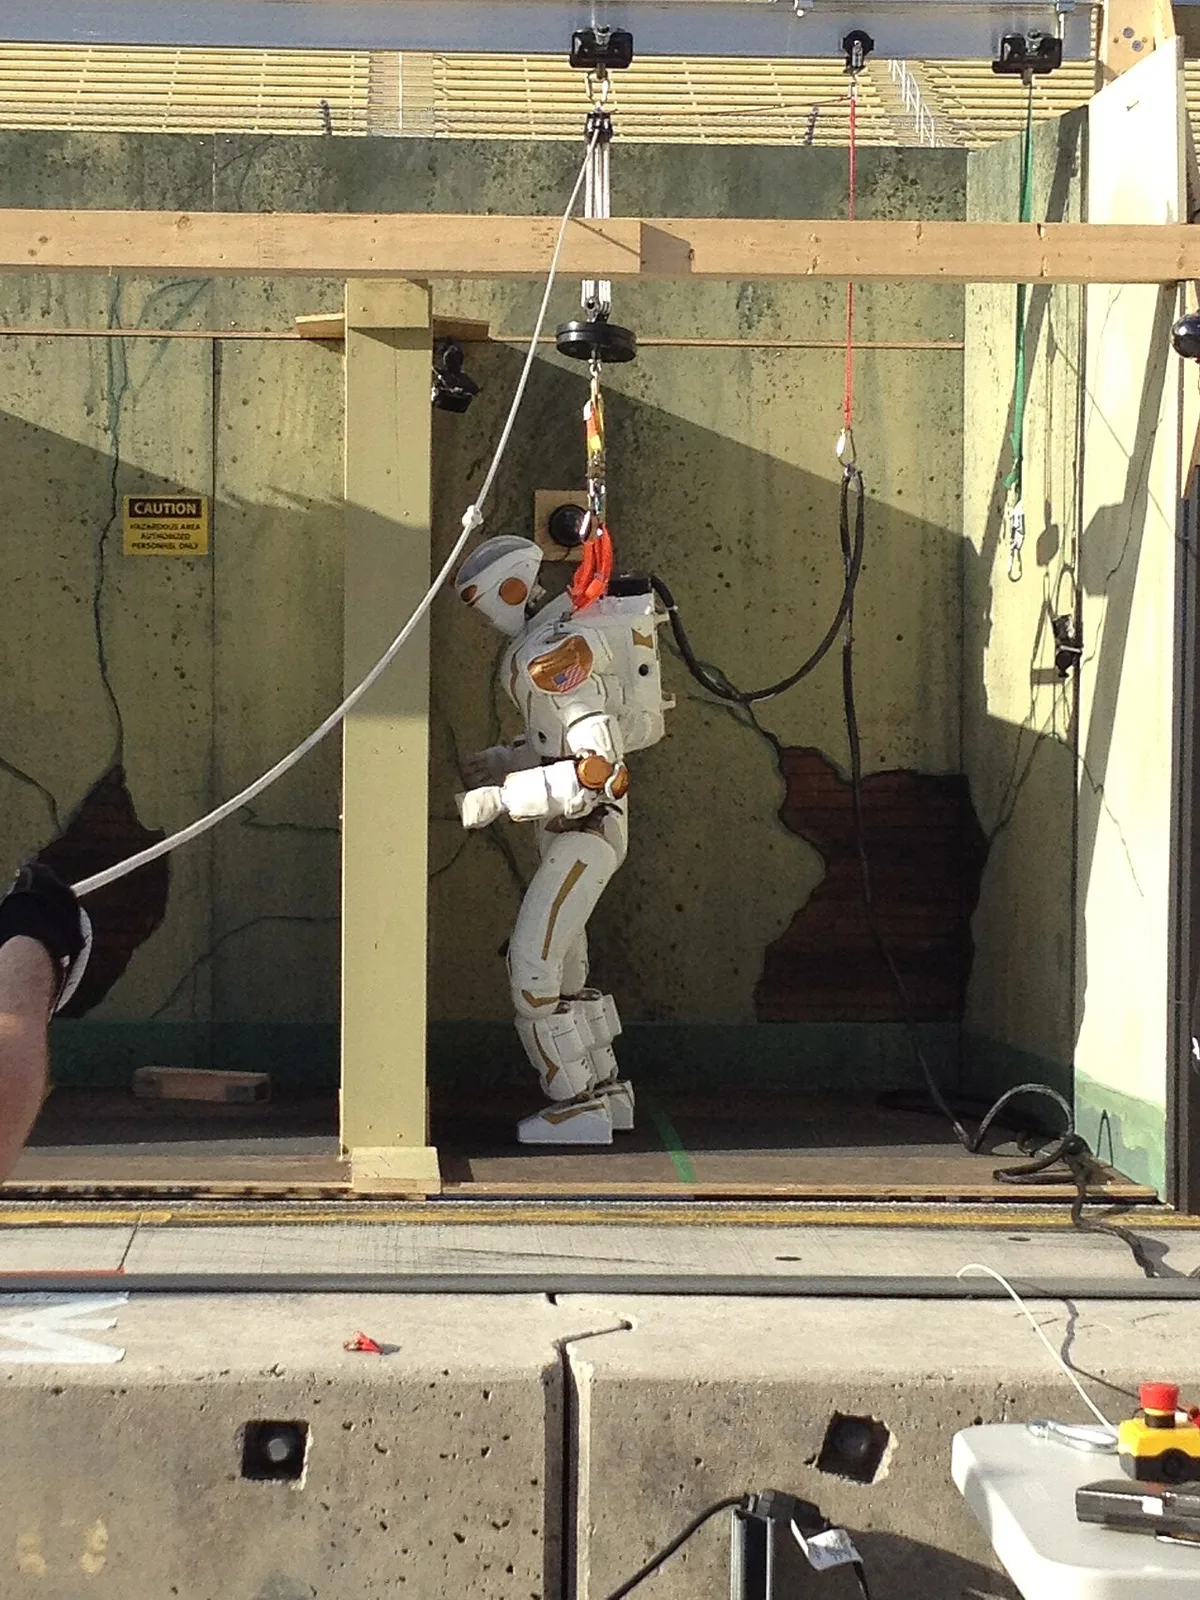
Współczesna robotyka autonomiczna wkroczyła w fazę fundamentalnego przełomu paradygmatycznego, porzucając sztywne, analityczne modele kinematyki i dynamiki odwrotnej na rzecz samoistnie uczących się reprezentacji przestrzenno-fizycznych. Przez dziesięciolecia dominującym podejściem w automatyzacji przemysłowej było programowanie robotów do wykonywania ściśle powtarzalnych trajektorii w deterministycznym, wyizolowanym środowisku klatek fabrycznych. Gdy jednak maszyna zostaje przeniesiona w nieustrukturyzowaną przestrzeń ludzkiego życia codziennego, magazynu logistycznego czy placu budowy, klasyczne algorytmy planowania ruchu oparte na metodach próbkowania przestrzeni konfiguracyjnej, takich jak RRT czy PRM, okazują się dramatycznie niewydolne. Zmienność oświetlenia, nieprzewidywalne właściwości mechaniczne deformowalnych obiektów, poślizgi oraz konieczność natychmiastowej reakcji na dynamiczne przeszkody wymagają od robota czegoś znacznie głębszego niż prosty kalkulator trajektorii – wymagają wewnętrznego, intuicyjnego rozumienia praw fizyki rządzących otaczającym światem.
Tę lukę poznawczą wypełniają tak zwane modele świata, określane w literaturze naukowej pojęciem World Models. Stanowią one generatywne i predykcyjne architektury sztucznej inteligencji, które na podstawie strumienia multimodalnych obserwacji sensorycznych budują zwartą, ukrytą przestrzeń reprezentacji stanu otoczenia. Wewnątrz tej przestrzeni robot jest w stanie przeprowadzać symulacje przyszłych zdarzeń w wyobraźni mentalnej, przewidując skutki własnych akcji motorycznych zanim zostaną one fizycznie wyegzekwowane przez serwonapędy. Połączenie modeli świata z fuzją sensoryczną nowej generacji, obejmującą kamery RGB-D, macierze dotykowe wysokiej gęstości oraz czujniki propriocepcji stawowej, przekształca humanoidy z niezdarnych automatów w zręczne podmioty autonomiczne zdolne do bezpiecznej i elastycznej manipulacji obiektami o złożonej mechanice.
Architektury JEPA i predykcja stanów w przestrzeni reprezentacji
Przez długi czas głównym nurtem w budowie modeli świata były generatywne modele autoregresyjne oraz sieci dyfuzyjne generujące bezpośrednie przewidywania na poziomie pikseli wideo. Choć podejście to tworzyło wizualnie spektakularne animacje przyszłości, cierpiało na potężną nieefektywność obliczeniową i fundamentalną wadę pojęciową. Generowanie każdego pojedynczego piksela zmusza model do marnowania zasobów obliczeniowych na modelowanie nieistotnych detali tła, takich jak szum matrycy, drgania liści na wietrze czy refleksy świetlne na ścianach, które nie mają żadnego znaczenia dla powodzenia zadania motorycznego. W rezultacie robot tracił zdolność do abstrahowania kluczowych niezmienników fizycznych.
Rewolucyjną alternatywę zaproponował Yann LeCun w postaci architektury JEPA, czyli Joint Embedding Predictive Architecture, rozwiniętej następnie do wariantu wizyjnego V-JEPA. W architekturze JEPA model całkowicie rezygnuje z dekodowania obrazu do przestrzeni pikselowej. Zamiast tego enkoder przekształca sekwencję obserwacji w gęsty wektor reprezentacji ukrytej, a moduł predyktora uczy się prognozować przyszły stan reprezentacji na podstawie zadanego wektora akcji motorycznej. Poprzez zastosowanie bezregresyjnych funkcji strat opartych na regularyzacji kowariancji, takich jak VICReg, model uczy się odrzucać nieprzewidywalny szum informacyjny, skupiając całą pojemność sieci na geometrycznych i fizycznych relacjach pomiędzy efektorem robota a manipulowanym obiektem.
Dla robota humanoidalnego oznacza to gigantyczny skok wydajnościowy. Planowanie trajektorii sięgania po szklankę z wodą w przestrzeni JEPA odbywa się w ułamku milisekundy poprzez próbkowanie trajektorii w przestrzeni ukrytej za pomocą algorytmów Model Predictive Path Integral MPPI oraz Temporal Difference Model Predictive Control TD-MPC. Robot w ułamku sekundy testuje tysiące wariantów ruchu ręki, ocenia ich stabilność pod kątem przewidywanych naprężeń i wybiera optymalną sekwencję sterującą, ignorując całkowicie zmieniające się w tle obrazy na ekranie telewizora czy cienie przechodzących ludzi.
Uczenie ze sprzężeniem w wyobraźni: Architektury DreamerV3 i sterowanie TD-MPC
Najbardziej fascynującym aspektem nowoczesnych modeli świata jest możliwość prowadzenia procesu uczenia przez wzmacnianie całkowicie wewnątrz wirtualnej wyobraźni sieci neuronowej, bez konieczności wykonywania jakichkolwiek fizycznych ruchów w świecie rzeczywistym. Pionierskim osiągnięciem w tym nurcie jest architektura DreamerV3 opracowana przez Danaijara Hafnera. Model ten uczy się zwartej reprezentacji dynamiki środowiska za pomocą rekurencyjnej przestrzeni stanów RSSM, łączącej ciągłe stany ukryte sieci rekurencyjnej z dyskretnymi zmiennymi stochastycznymi kategoryzowanymi za pomocą transformacji symlog.
Gdy model świata zostanie wytrenowany na bazie początkowych obserwacji, polityka sterująca Actor-Critic uczy się optymalnego zachowania wyłącznie poprzez generowanie milionów wyimaginowanych trajektorii w przestrzeni ukrytej RSSM. Sieć krytyka szacuje oczekiwaną nagrodę za przyszłe stany, a sieć aktora optymalizuje swoje parametry drogą analitycznego różniczkowania przepływu gradientów przez wyuczony model świata. Dzięki temu robot może w ciągu kilku godzin symulacji mentalnej opanować niezwykle złożone manewry zręcznościowe, takie jak balansowanie przedmiotami na czubku palca czy żonglowanie, nie ryzykując uszkodzenia mechanizmów ani nie zużywając energii akumulatorów.
Równolegle rozwija się paradygmat TD-MPC, czyli sterowanie predykcyjne oparte na różnicach czasowych. Zamiast trenować uniwersalną politykę dla wszystkich możliwych sytuacji, TD-MPC łączy planowanie lokalne w czasie rzeczywistym z wyuczoną funkcją wartości terminalnej. W każdym kroku sterowania algorytm generuje wiązkę kilkuset obiecujących sekwencji akcji na horyzoncie zaledwie kilku kroków w przód, ocenia je za pomocą funkcji wartości zbiegającej do nieskończoności i natychmiast wykonuje pierwszą akcję z najlepszego planu. Daje to niespotykaną odporność na nagłe zmiany otoczenia, pozwalając humanoidowi na natychmiastową korektę chwytu w momencie, gdy trzymana paczka okaże się znacznie cięższa niż wynikało z jej wstępnej oceny wzrokowej.
Dyfuzyjne zasady sterowania motorycznego: Od pikseli do mikrosekundowych momentów sił
Równolegle z rozwojem modeli świata dokonał się przełom w warstwie bezpośredniego sterowania wykonawczego. Przez lata dominujące w robotyce uczenie przez wzmacnianie ze sprzężeniem od człowieka RLHF oraz klasyczne klonowanie zachowań Behaviour Cloning zmagały się z tak zwanym problemem wielomodalności rozkładu działań. Kiedy człowiek wykonuje zadanie, na przykład omija przeszkodę, może podjąć decyzję o skierowaniu dłoni w lewo lub w prawo z równym prawdopodobieństwem sukcesu. Tradycyjne sieci neuronowe z wyjściem w postaci pojedynczego wektora średniej gausowskiej uśredniały te dwie poprawne opcje, generując komendę ruchu na wprost, co prowadziło do nieuchronnego zderzenia z przeszkodą.
Rozwiązaniem tego problemu stała się koncepcja Diffusion Policy, przenosząca zasady matematyczne modeli dyfuzyjnych znanych z generowania obrazów na grunt sterowania robotycznego. W tym ujęciu proces decyzyjny robota jest traktowany jako stopniowe usuwanie szumu z losowej trajektorii motorycznej pod warunkiem bieżących obserwacji sensorycznych. Model dyfuzyjny reprezentuje dowolnie skomplikowany, wielomodalny rozkład prawdopodobieństwa akcji, co pozwala humanoidowi na bezproblemowe podejmowanie decyzji o wyborze jednej z wielu równorzędnych strategii manipulacyjnych.
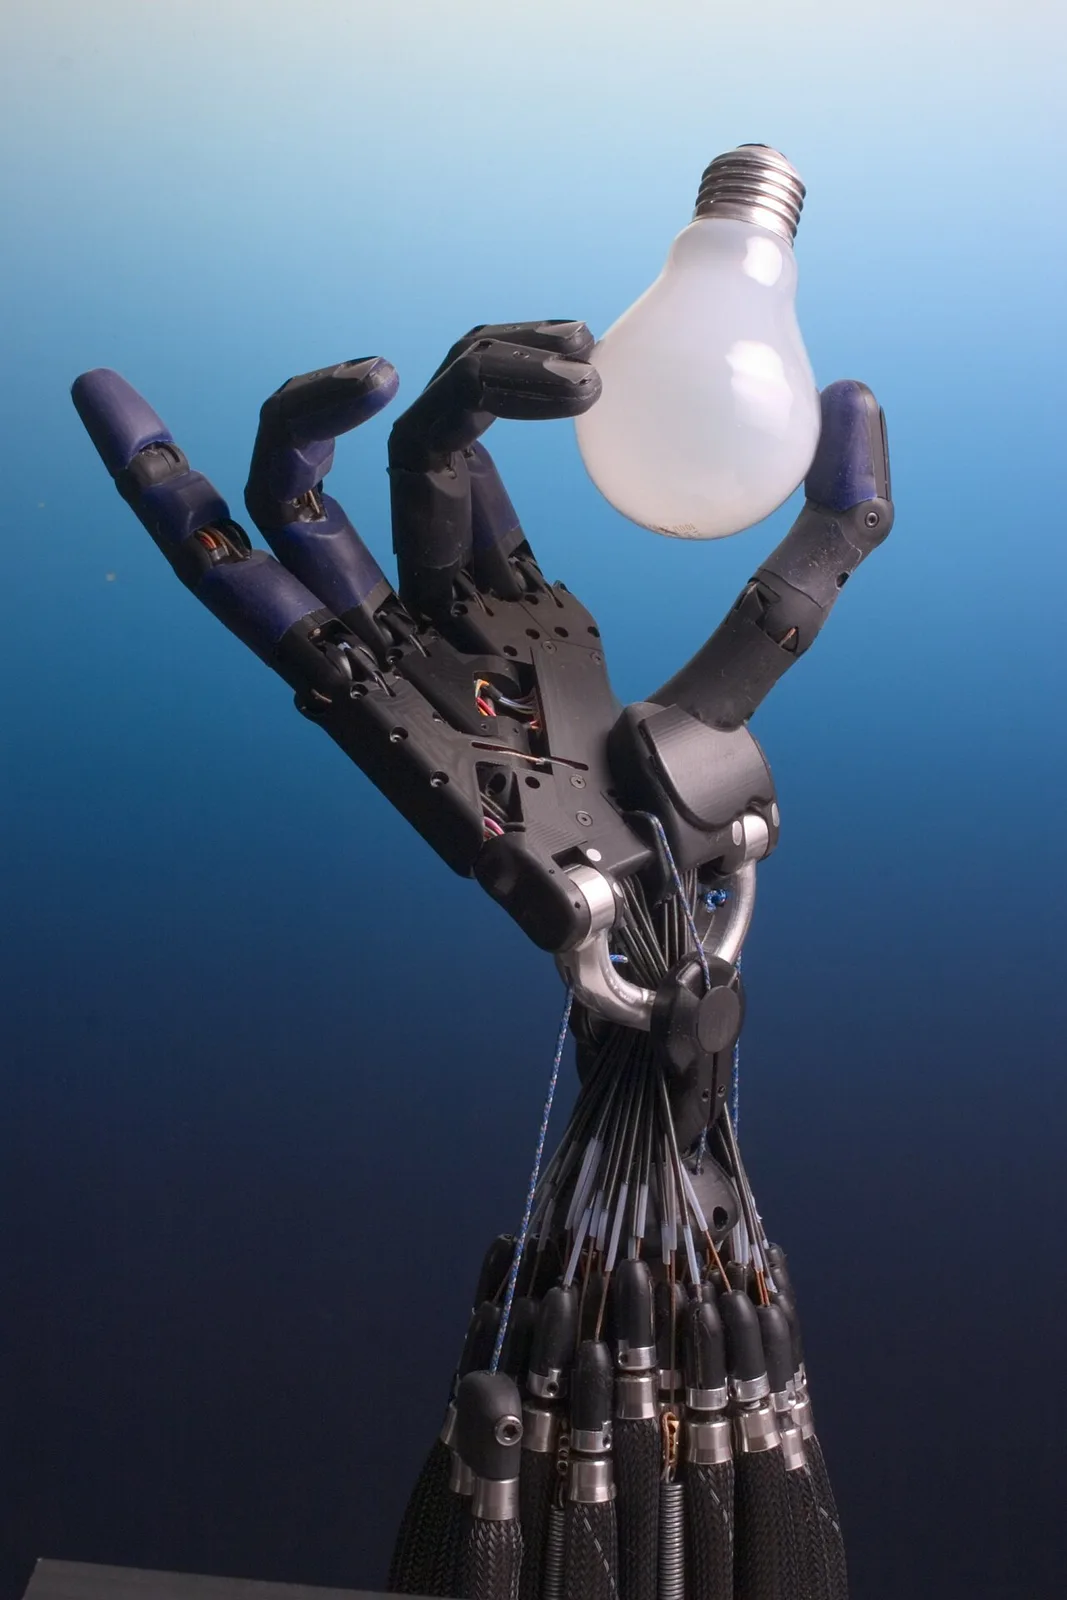
Co kluczowe, architektury dyfuzyjne w robotyce generują nie pojedyncze stany natychmiastowe, lecz horyzont czasowy kilkunastu kroków w przód, tak zwany chunking akcji. Zapewnia to niezwykłą płynność mechaniczną ruchu, eliminując drżenia i niestabilności wysokoczęstotliwościowe, które w przeszłości niszczyły przekładnie falowe i harmoniczne w stawach robotów. Dzięki zastosowaniu technik przyspieszonego próbkowania, takich jak Denoising Diffusion Implicit Models DDIM oraz destylacji modeli, współczesne algorytmy Diffusion Policy są w stanie generować zaktualizowane plany ruchu z częstotliwością przekraczającą pięćdziesiąt herców, reagując na nieoczekiwane wyrwanie przedmiotu z ręki w czasie poniżej dwudziestu milisekund.
Architektura napędowa: Siłowniki quasi-bezpośrednie QDD i sterowanie impedancyjne
Algorytmy sztucznej inteligencji, choćby najbardziej zaawansowane, pozostają bezsilne bez odpowiedniej architektury mechanicznej zdolnej do ich fizycznej realizacji. Klasyczne manipulatory przemysłowe projektowano z myślą o maksymalnej sztywności, stosując silniki elektryczne sprzężone z przekładniami o przełożeniach rzędu stu lub dwustu do jednego, takimi jak przekładnie harmoniczne Harmonic Drive lub cykloidalne. Taka konstrukcja charakteryzuje się jednak gigantyczną bezwładnością wsteczną i skrajnie wysoką sztywnością mechaniczną. Gdy końcówka takiego ramienia uderzy w przeszkodę, cała energia kinetyczna silnika zostaje przekazana w punkt kontaktu zanim jakikolwiek układ elektroniczny zdąży zareagować, co grozi zniszczeniem manipulowanego przedmiotu lub zranieniem człowieka.
Nowoczesna robotyka humanoidalna przeszła na siłowniki z napędem quasi-bezpośrednim, określane akronimem QDD od Quasi-Direct Drive. Konstrukcja siłownika QDD łączy silnik bezszczotkowy BLDC o dużej średnicy i potężnym momencie własnym z miniaturową przekładnią planetarną o bardzo niskim przełożeniu, zazwyczaj od sześciu do dziesięciu do jednego. Niskie przełożenie drastycznie zmniejsza bezwładność zredukowaną na wale wyjściowym, czyniąc napęd w pełni podatnym mechanicznie i przezroczystym dla sił zewnętrznych. Dzięki temu siłownik QDD działa jako naturalny, mechaniczny czujnik siły: pomiar prądu płynącego przez uzwojenia stojana pozwala na precyzyjne wyznaczenie momentu zewnętrznego działającego na staw z dokładnością do ułamka niutonometra.
Umożliwia to wdrożenie aktywnego sterowania impedancyjnego i admitancyjnego bezpośrednio na poziomie sprzętowym. W sterowaniu impedancyjnym robot nie dąży za wszelką cenę do osiągnięcia zaprogramowanej pozycji geometrycznej, lecz zachowuje się jak wirtualny układ sprężysto-tłumiący o dynamicznie regulowanej sztywności. Kiedy dłoń humanoida dotyka kruchego jajka lub kieliszka, model świata obniża współczynnik sztywności wirtualnej sprężyny, pozwalając na idealne dopasowanie palców do konturu obiektu bez wywierania destrukcyjnego nacisku.
Fuzja dotykowa i proprioceptywna: Dotyk optyczny i skóra neuromorficzna
Sama percepcja wzrokowa, choćby najbardziej zaawansowana, jest z definicji bezradna w momencie, gdy efektor robota wchodzi w bezpośredni kontakt fizyczny z obiektem. W fazie chwytu dłoń i palce robota całkowicie zasłaniają strefę kontaktu przed obiektywami kamer nagałownych czy torsowych. Próba manipulowania przedmiotami wyłącznie w oparciu o wzrok przypomina operowanie chirurgiczne w grubych rękawicach bokserskich przy zgaszonym świetle – brak natychmiastowej informacji o rozkładzie nacisku i lokalnym poślizgu uniemożliwia stabilne utrzymanie delikatnych lub śliskich powierzchni.
Przełomem w sensoryce dotykowej stały się sensory dotyku optycznego o wysokiej rozdzielczości, reprezentowane przez technologie GelSight, DIGIT oraz Tac3D. Konstrukcja takiego czujnika opiera się na przezroczystej płytce elastomerowej pokrytej elastyczną membraną refleksyjną, pod którą umieszczono miniaturową kamerę oraz diody doświetlające w barwach RGB pod różnymi kątami. W momencie dotknięcia przedmiotu elastomer ulega mikroskopijnej deformacji odzwierciedlającej geometrię powierzchni z mikrometryczną precyzją. Kamera rejestruje zmianę cieniowania fotometrycznego, co pozwala na natychmiastową rekonstrukcję trójwymiarowej mapy kontaktu, wektorów sił ścinających oraz wykrycie mikropoślizgu zanim przekształci się on w makroskopowe upuszczenie przedmiotu.
Równolegle rozwija się technologia neuromorficznej skóry elektronicznej opartej na czujnikach piezoelektrycznych i piezorezystywnych generujących impulsy zdarzeniowe na wzór ludzkich ciałek Meissnera i Paciniego. Zamiast próbkować tysiące punktów dotykowych ze stałą częstotliwością i marnować pasmo transmisyjne magistrali cyfrowej, piksele neuromorficzne wysyłają sygnał wyłącznie wtedy, gdy ciśnienie ulegnie dynamicznej zmianie. Pozwala to robotowi na zarejestrowanie fali uderzeniowej poślizgu w czasie krótszym niż jedna milisekunda i wyzwolenie odruchowego zaciśnięcia chwytaka na poziomie niskopoziomowego mikrokontrolera rdzenia kończyny, bez konieczności angażowania centralnego procesora wizyjnego.
Heterogeniczne klastry brzegowe i wieloczęstotliwościowa pętla sterowania
Praktyczna implementacja fuzji sensorycznej i modeli świata w autonomicznym szkielecie humanoida wymagała przełomu w architekturze komputerów pokładowych. Roboty najnowszej generacji nie polegają na pojedynczym procesorze, lecz integrują heterogeniczny klaster brzegowy łączący wielordzeniowe procesory ARM, akceleratory sieci neuronowych NPU oraz programowalne układy FPGA komunikujące się za pośrednictwem ultraszybkich magistral PCIe oraz sieci czasu rzeczywistego EtherCAT i CAN-FD.
Architektura oprogramowania zorganizowana jest w hierarchiczną strukturę wieloczęstotliwościową. Na najniższym poziomie mikrokontrolery wbudowane bezpośrednio w obudowy serwonapędów realizują pętlę regulacji prądu i momentu obrotowego z częstotliwością od jednego do dziesięciu kiloherców. Zapewnia to natychmiastowe tłumienie drgań mechanicznych i utrzymanie stabilności postawy dynamicznej. Poziom średni, wykonujący obliczenia z częstotliwością od pięćdziesięciu do stu herców na akceleratorach brzegowych takich jak platformy Nvidia Jetson Thor lub Orin, odpowiada za ewaluację modeli Diffusion Policy oraz lokalną kinematykę odwrotną. Z kolei najwyższy poziom poznawczy, obejmujący wielkie modele wizyjno-językowe VLA i globalne modele świata, przetwarza dane z częstotliwością kilku herców, planując sekwencje celów wysokiego poziomu bez obciążania krytycznych pętli stabilizacji równowagi.
Symulacja fizyki w GPU i transfer Sim-to-Real bez luki domenowej
Jednym z największych wyzwań w uczeniu modeli świata dla robotyki jest astronomiczny koszt pozyskiwania danych w świecie rzeczywistym. Trening zaawansowanego modelu wymaga milionów godzin interakcji motorycznej. Zbieranie tych doświadczeń na fizycznych robotach grozi mechanicznym zniszczeniem drogich prototypów, wymaga ciągłego nadzoru inżynierów i trwa lata. Rozwiązaniem stało się przeniesienie procesu nauki do symulatorów fizyki przyspieszanych sprzętowo na klastrach GPU, takich jak Isaac Sim oparty na silniku PhysX firmy Nvidia, Genesis czy MuJoCo Warp.
Symulatory te potrafią symulować setki tysięcy równoległych instancji robota w czasie wielokrotnie szybszym niż czas rzeczywisty, modelując dynamikę bryły sztywnej, deformacje ciał sprężystych, aerodynamikę oraz kontakt cierny. Aby pokonać tak zwaną lukę domenową Sim-to-Real, polegającą na tym, że model wyuczony w idealnym środowisku symulacji zawodzi w chaotycznym świecie rzeczywistym, inżynierowie stosują zaawansowaną randomizację domeny Domain Randomization.
W trakcie treningu symulator nieustannie i losowo modyfikuje parametry fizyczne środowiska: współczynniki tarcia, masy poszczególnych ogniw robota, opóźnienia magistrali komunikacyjnej, szum czujników, sprężystość obiektów oraz warunki oświetleniowe i tekstury. Model świata, zmuszony do funkcjonowania w tak zróżnicowanych warunkach, uczy się nie polegać na idealnych stałych fizycznych, lecz identyfikować fundamentalne niezmienniki dynamiki i adaptować swoje estymacje w czasie rzeczywistym. W rezultacie po wgraniu wag sieci do fizycznego robota humanoid natychmiast i bezbłędnie wykonuje zadania, z którymi nigdy wcześniej nie zetknął się w świecie realnym.
Teleoperacja obustronna i ekstrakcja wiedzy z demonstracji człowieka
Choć symulacja cyfrowa dostarcza gigantycznych wolumenów danych dla ogólnych zachowań lokomocyjnych i manipulacji podstawowej, skomplikowane czynności manualne, takie jak składanie ubrań, zapinanie guzików czy lutowanie układów elektronicznych, wymagają demonstracji najwyższej klasy ekspertów. Aby pozyskać te unikalne zbiory danych, laboratoria badawcze budują zaawansowane stanowiska teleoperacyjne wyposażone w kombinezony immersyjne, gogle rzeczywistości wirtualnej oraz obustronne egzoszkielety dotykowe Haptic Feedback.
W systemie teleoperacji obustronnej człowiek-operator czuje w dłoniach dokładnie te same opory, tarcie i bezwładności, jakich doświadcza robot manipulujący fizycznym obiektem. Algorytmy filtrowania kinematycznego usuwają naturalne drżenie ludzkich rąk i skalują ruchy do geometrii antropomorficznego szkieletu humanoida. Zgromadzone w ten sposób trajektorie, wzbogacone o zsynchronizowane strumienie wideo, chmury punktów LiDAR oraz zapisy sił dotykowych, stanowią paliwo dla uczenia przez naśladowanie w architekturze Diffusion Policy, pozwalając modelowi na opanowanie skomplikowanej manualnej wprawy rzemieślniczej w zaledwie kilkadziesiąt sesji treningowych.
Bezpieczeństwo kinetyczne i normy ISO/TS 15066 w bezpośredniej interakcji z człowiekiem
Wprowadzenie robotów humanoidalnych do wspólnej przestrzeni roboczej z ludźmi wymaga bezwzględnego spełnienia rygorystycznych norm bezpieczeństwa funkcjonalnego, w szczególności wytycznych specyfikacji technicznej ISO/TS 15066 dla robotów współpracujących cobotów. Klasyczne roboty przemysłowe odgradzano stalowymi barierami i kurtynami optycznymi, których naruszenie wywoływało natychmiastowe zatrzymanie awaryjne. W przypadku humanoida poruszającego się swobodnie po hali montażowej lub korytarzu szpitalnym taka izolacja jest z natury niemożliwa.
Bezpieczeństwo w nowoczesnych humanoidach opiera się na architekturze monitorowania przestrzeni i dynamicznego ograniczania mocy oraz sił nacisku Power and Force Limiting. Wykorzystując pokładowe akceleratory AI, system w czasie rzeczywistym buduje trójwymiarową siatkę zajętości przestrzennej Voxel Occupancy Grid, identyfikując położenie i wektory ruchu obecnych w pobliżu ludzi. W oparciu o odległość do człowieka algorytm wyznacza tak zwaną kopertę prędkości dopuszczalnej: im bliżej znajduje się człowiek, tym niższy limit energii kinetycznej zostaje narzucony na serwonapędy. Dodatkowo w przypadku wystąpienia nieoczekiwanego kontaktu mechanicznego, siłowniki QDD natychmiast przełączają się w tryb pełnej kompensacji grawitacyjnej i podatności zerowej, pochłaniając uderzenie i eliminując ryzyko jakichkolwiek urazów ciała.
Fundamentowe modele motoryczne: VLA i unifikacja percepcji z działaniem
Ostatecznym etapem ewolucji systemów autonomicznych jest scalenie modeli językowych, modeli percepcji wzrokowej oraz polityk sterowania w monolityczne architektury Vision-Language-Action VLA, na czele z systemami takimi jak RT-2, Octo czy OpenVLA. W tych modelach tokeny reprezentujące instrukcje słowne człowieka, tokeny wizualne z kamer robota oraz tokeny reprezentujące trajektorie motoryczne stawów są przetwarzane wewnątrz jednolitej sieci transformatorowej z mechanizmem wielogłowicowej uwagi cross-attention.
Taka unifikacja wyposaża robota w zdolność do uogólniania semantycznego na niespotykaną dotąd skalę. Robot, który otrzyma polecenie słowne posprzątania rozlanego napoju, nie wymaga żmudnego programowania procedury awaryjnej. Korzystając z wiedzy zdroworozsądkowej zakodowanej w modelu fundamentowym, robot rozumie, że rozlany płyn wymaga użycia ręcznika papierowego, lokalizuje rolkę papieru na stole, planuje chwyt za pomocą modelu dyfuzyjnego, szacuje siłę nacisku poprzez sensory dotykowe i wyciera powierzchnię z precyzyjną kontrolą siły docisku. Granica pomiędzy myśleniem abstrakcyjnym a działaniem fizycznym została ostatecznie zatarta.
Nowa era autonomii ucieleśnionej i horyzont przemysłowy
Stoimy u progu ery, w której roboty humanoidalne przestają być jedynie laboratoryjnymi demonstratorami technologicznymi, stając się autonomicznymi pracownikami fizycznymi zdolnymi do przejęcia najniebezpieczniejszych i najbardziej uciążliwych zadań w przemyśle i logistyce. Połączenie predykcyjnych modeli świata JEPA, elastycznych zasad sterowania Diffusion Policy, mikrometrycznej sensoryki dotykowej oraz ultraszybkich symulacji GPU stworzyło spójny ekosystem inteligencji ucieleśnionej Embodied AI.
Maszyny wyposażone w te technologie nie potrzebują precyzyjnie zaprojektowanych linii produkcyjnych ani idealnie ułożonych komponentów. Potrafią adaptować się do chaosu, uczyć się nowych umiejętności w ciągu kilku demonstracji i współpracować ramię w ramię z człowiekiem z zachowaniem pełnego bezpieczeństwa kinetycznego. Rewolucja ta przekształci globalną gospodarkę, redefiniując strukturę łańcuchów dostaw, automatyzując budownictwo i opiekę medyczną, a w perspektywie kolejnych dekad otwierając drogę do w pełni zautomatyzowanej eksploracji i kolonizacji ciał Układu Słonecznego.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.