
Modele świata World Models, architektura JEPA i ucieleśniona sztuczna inteligencja w robotyce: Jak uczenie reprezentacji latentnych i symulacje fizyki w czasie rzeczywistym eliminują halucynacje w autonomicznych maszynach nowej ery
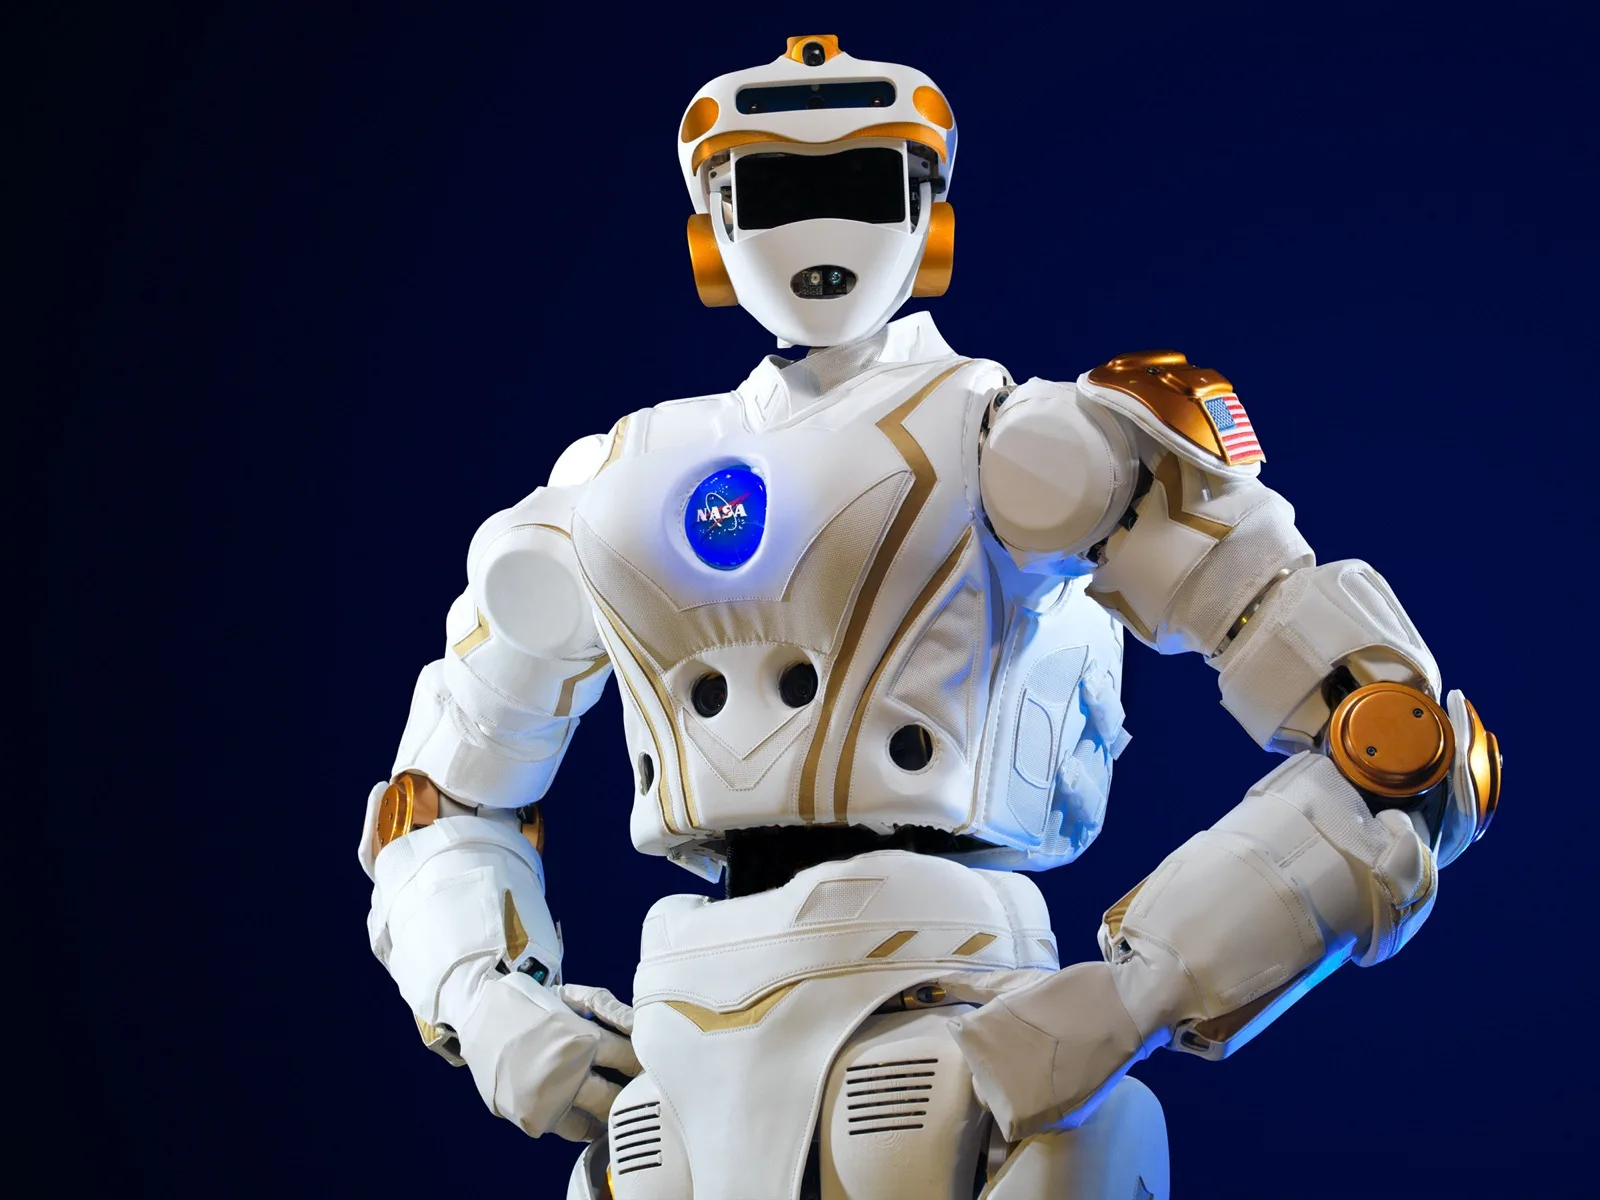
Przez lata dominujący paradygmat rozwoju sztucznej inteligencji opierał się na przewidywaniu kolejnego tokenu w sekwencji tekstowej lub generowaniu kolejnych pikseli w przestrzeni obrazu. Choć podejście to przyniosło spektakularne rezultaty w postaci wielkich modeli językowych oraz generatorów wideo, w zderzeniu z fizyczną rzeczywistością i robotyką napotkało barierę nie do pokonania. Trójwymiarowy świat materialny nie składa się ze słów, lecz z nieodwracalnych procesów termodynamicznych, sił tarcia, bezwładności masy, odkształceń sprężystych oraz skomplikowanych zależności geometrycznych. Maszyna, która próbuje planować swoje ruchy poprzez przewidywanie każdego piksela przyszłej klatki wideo, marnuje gigantyczne zasoby obliczeniowe na modelowanie szumu tła, takiego jak drżenie liści na wietrze czy refleksy świetlne na kałuży, zamiast skupić się na istocie zjawisk fizycznych.
Rozwiązaniem tego fundamentalnego problemu stała się koncepcja modeli świata World Models, a w szczególności architektura wspólnego zanurzenia predykcyjnego Joint Embedding Predictive Architecture, znana jako JEPA, zaproponowana przez Yanna LeCuna i intensywnie rozwijana przez czołowe laboratoria badawcze na świecie. Kluczową innowacją JEPA jest całkowite porzucenie generowania surowych danych w przestrzeni pikseli na rzecz przewidywania przyszłych stanów w abstrakcyjnej przestrzeni cech latentnych. Dzięki temu system uczy się rozumieć strukturę otoczenia, ignorując nieistotne fluktuacje sensoryczne, a skupiając się na prawach przyczynowo-skutkowych rządzących światem materialnym. W ucieleśnionej sztucznej inteligencji Embodied AI podejście to otwiera zupełnie nowy rozdział, umożliwiając robotom humanoidalnym antycypowanie skutków własnych działań przed ich faktycznym wykonaniem.
Iluzja generatywnej autoregresji a wyzwania fizycznej motoryki
Klasyczne modele wizyjno-językowo-ruchowe klasy VLA Vision Language Action, które zdominowały wczesne próby integracji modeli LLM z manipulatorkami przemysłowymi, cierpią na fundamentalną wadę strukturalną. Przekładanie percepcji wizualnej na ciągi tokenów dyskretnych wprowadza dyskretyzację przestrzeni i czasu, która jest z natury sprzeczna z płynną mechaniką ruchu. W robotyce humanoidalnej pętla sterowania serwonapędami wymaga częstotliwości rzędu co najmniej dwustu herców, a w przypadku kompensacji sił nacisku i dynamicznej równowagi nawet jednego kiloherca. Autoregresyjne generowanie kolejnych tokenów akcji jest zbyt wolne, a każda mikrosekundowa latencja w sprzężeniu zwrotnym prowadzi do utraty stabilności dynamicznej, upadku robota lub uszkodzenia manipulowanego przedmiotu.
Co gorsza, generatywne modele pikselowe generują halucynacje fizyczne. Model wizyjny trenowany na minimalizację błędu rekonstrukcji obrazu może wygenerować klatkę, w której szklanka przenika przez blat stołu lub unosi się w powietrzu bez podparcia, ponieważ statystycznie taka kombinacja pikseli w przestrzeni wysokowymiarowej może mieć niski błąd średniokwadratowy. Jednak dla robota wykonującego operację chwytu taka halucynacja oznacza natychmiastową kolizję mechaniczną lub zgniecenie naczynia. Architektura JEPA eliminuje ten problem poprzez nieliniowe rzutowanie obserwacji sensorycznych do przestrzeni wektorowej, w której odległości metryczne odpowiadają faktycznym stanom energetycznym i kinetycznym układu, a nie powierzchownym podobieństwom wizualnym.
Matematyczne fundamenty modeli energetycznych EBM w architekturze JEPA
Aby precyzyjnie zrozumieć matematyczną przewagę architektury JEPA nad klasycznymi sieciami generatywnymi, należy odwołać się do teorii modeli opartych na energii Energy-Based Models. W tradycyjnym podejściu probabilistycznym model uczy się znormalizowanego rozkładu prawdopodobieństwa na podstawie gęstości danych w przestrzeni wejściowej. Wymaga to obliczania całki normalizacyjnej, co w przestrzeniach o tysiącach wymiarów jest analitycznie niewykonalne i zmusza do stosowania przybliżeń w rodzaju próbkowania metodami Monte Carlo z łańcuchami Markowa MCMC. W robotyce dynamicznej, gdzie każda milisekunda decyduje o stabilności konstrukcji, tak kosztowne obliczeniowo aproksymacje prowadzą do natychmiastowego załamania sterowania.
Architektura JEPA rezygnuje ze znormalizowanego rozkładu prawdopodobieństwa na rzecz skalara energii, który mierzy stopień zgodności pomiędzy wektorem stanu początkowego, podjętą akcją a zaobserwowanym stanem kolejnym. W tym ujęciu funkcja energii przypisuje niskie wartości stanom fizycznie zgodnym z prawami dynamiki Newtona, a wysokie wartości stanom niemożliwym, takim jak nagłe przeniknięcie dwóch ciał sztywnych czy pojawienie się pędu bez działania siły zewnętrznej. Nieliniowy moduł predyktora przekształca wektor reprezentacji stanu s oraz wektor akcji a w przewidywany stan kolejny s prim, dążąc do zminimalizowania energii błędu w przestrzeni latentnej.
Niezwykle istotnym elementem stabilizacji tego procesu jest eliminacja problemu zapadania reprezentacji za pomocą regularyzacji kowariancji i wariancji, znanej z metodologii VICReg Variance-Invariance-Covariance Regularization. Funkcja straty nakłada explicite karę za zmniejszanie się wariancji wektorów cech poniżej zadanego progu jednostkowego wzdłuż każdego wymiaru ukrytego, co wymusza pełne wykorzystanie pojemności informacyjnej wektora reprezentacji. Jednocześnie człon kowariancyjny minimalizuje korelacje pomiędzy różnymi wymiarami przestrzeni ukrytej, zapobiegając redundancji cech i gwarantując, że poszczególne składowe wektora kodują ortogonalne właściwości fizyczne otoczenia, takie jak prędkość liniowa, rotacja kątowa, bezwładność czy twardość podłoża.
Fuzja neuromorficzna: Kamery zdarzeniowe DVS i skóra dotykowa GelSight
Przetwarzanie sygnałów w ucieleśnionych modelach świata nowej generacji nie ogranicza się wyłącznie do konwencjonalnych kamer rejestrujących statyczne klatki z częstotliwością trzydziestu lub sześćdziesięciu herców. W robotyce humanoidalnej ruchoma głowa robota oraz dynamicznie przemieszczające się kończyny generują efekt rozmycia ruchu motion blur, który w klasycznych matrycach CMOS prowadzi do utraty kluczowych informacji o krawędziach i wektorach prędkości optycznej. Z tego powodu najnowocześniejsze systemy integrują kamery zdarzeniowe neuromorficzne Dynamic Vision Sensors DVS.
Matryce neuromorficzne DVS nie generują tradycyjnych klatek obrazu, lecz rejestrują zmiany natężenia światła na poziomie pojedynczych pikseli asynchronicznie, z mikrosekundową rozdzielczością czasową i zakresem dynamiki przekraczającym sto dwadzieścia decybeli. Strumień zdarzeń neuromorficznych trafia bezpośrednio do impulsowych lub rzadkich enkoderów architektury JEPA, co pozwala modelowi świata na błyskawiczne wychwycenie początku poślizgu, mikrowibracji mechanicznych czy zbliżających się przeszkód bez konieczności buforowania i przetwarzania gigabajtów redundantnych danych pikselowych.
Równie fundamentalnym zmysłem ucieleśnionego humanoida jest zmysł dotyku sensorycznego o wysokiej gęstości przestrzennej. W dłoniach manipulatorów integrowane są elastyczne matryce dotykowe oparte na technologii elastomerów optycznych, takich jak GelSight czy DIGIT. Gdy syntetyczny palec robota dotyka przedmiotu, odkształcenie przezroczystej membrany pokrytej od wewnątrz warstwą refleksyjną jest rejestrowane przez mikrokamerę i podświetlane pod różnymi kątami diodami elektroluminescencyjnymi. Model świata JEPA traktuje sygnał dotykowy jako komplementarny strumień cech, łącząc geometrię wizualną z mikroskopijną topografią powierzchni, co umożliwia bezbłędne rozróżnienie śliskiego szkła od chropowatego drewna oraz regulację siły zacisku chwytaka z precyzją rzędu pojedynczych miliniutonów.
Koordynacja całego ciała Whole-Body Control i kryteria stabilności dynamicznej
Przełożenie przewidywań modelu świata na fizyczne ruchy bipedalnego robota humanoidalnego wymaga rozwiązania skomplikowanego zagadnienia sterowania całym ciałem Whole-Body Control WBC w warunkach zmiennych więzów kontaktowych. Tradycyjna robotyka przez dziesięciolecia opierała się na kryterium punktu zerowego momentu Zero Moment Point ZMP, które zakładało, że wypadkowy moment sił bezwładności i grawitacji wokół punktu podparcia musi wynosić zero, aby stopa robota nie oderwała się od podłoża. Choć ZMP gwarantowało bezpieczny marsz po idealnie płaskiej posadzce laboratoryjnej, uniemożliwiało robotom wykonywanie dynamicznych skoków, biegu, schodzenia po nierównych stopniach czy asekuracyjnego podparcia dłonią o ścianę w momencie zachwiania.
Nowoczesne sterowniki WBC sprzężone z modelem świata JEPA operują na nieliniowych trajektoriach pędu całego układu, optymalizując jednocześnie trajektorię środka masy Center of Mass CoM oraz siły reakcji podłoża Ground Reaction Forces GRF na wszystkich punktach kontaktu. Model świata przewiduje z wyprzedzeniem kilkuset milisekund, jak zmiana kąta w stawie biodrowym lub zgięcie kolana wpłynie na rozkład nacisków pod stopami. W przypadku wykrycia nieprzewidzianej przeszkody, na przykład śliskiej plamy oleju lub oblodzenia, układ sterowania nie próbuje na siłę utrzymywać sztywnego punktu ZMP, lecz natychmiast rekonfiguruje fazę transferu kończyny, przechodząc do dynamicznego kroku kompensacyjnego lub kontrolowanego ugięcia stawów, które pochłania energię kinetyczną upadku.
Certyfikacja bezpieczeństwa przemysłowego i architektury hybrydowe SIL 3
Ostatnim, lecz w zastosowaniach przemysłowych najważniejszym filarem wdrażania modeli świata w robotyce humanoidalnej jest zagadnienie determinizmu i formalnej certyfikacji bezpieczeństwa. Niezależnie od tego, jak zaawansowany i odporny na halucynacje jest model sieci neuronowej, żaden regulator przemysłowy ani inspektorat pracy nie dopuści do pracy w jednym środowisku z ludźmi maszyny o masie osiemdziesięciu kilogramów wyposażonej w silniki o potężnym momencie obrotowym, jeśli jej działanie opiera się wyłącznie na probabilistycznym wnioskowaniu czarnej skrzynki sieci głębokiej.
Rozwiązaniem tego problemu stały się hybrydowe architektury bezpieczeństwa oparte na deterministycznych obwodach nadzorczych Safety Watchdog spełniających rygorystyczne normy PN-EN ISO 13849-1 oraz ISO 10218 dla poziomu nienaruszalności bezpieczeństwa SIL 2 oraz SIL 3. W architekturze tej model świata JEPA pełni funkcję optymalizatora wyższego rzędu, generując zalecane profile momentów obrotowych i trajektorii. Jednak pomiędzy wyjściem sieci neuronowej a falownikami mostków tranzystorowych napędzających silniki BLDC znajduje się niezależny, mikroprocesorowy moduł bezpieczeństwa o udowodnionej matematycznie poprawności kodu formalnego.
Moduł ten w czasie rzeczywistym monitoruje tak zwane strefy dopuszczalnych stanów bezpiecznych Safe Operating Envelope. Jeśli proponowana przez model świata trajektoria narusza choćby jeden zdefiniowany w normach parametrów, na przykład maksymalną dopuszczalną prędkość zbliżania się do wykrytego człowieka, siłę nacisku w przypadku kolizji czy dopuszczalne przyspieszenie kątowe stawu, obwód deterministyczny natychmiast modyfikuje sygnał sterujący lub uruchamia procedurę bezpiecznego hamowania awaryjnego Safe Torque Off STO. Ta symbioza intuicyjnej, elastycznej inteligencji modelu świata z bezkompromisowym determinizmem formalnych układów zabezpieczeń stanowi fundament komercyjnej rewolucji autonomicznych humanoidów w przemyśle wytwórczym, logistyce i opiece medycznej.
Architektura V-JEPA i mechanizmy samonadzorowanego uczenia reprezentacji
Sercem współczesnych modeli świata jest samonadzorowane uczenie reprezentacji w oparciu o zamaskowane kodowanie wizualne Masked Autoencoding w przestrzeni cech. W architekturze V-JEPA sieć enkoderów przetwarza sekwencję wideo zarejestrowaną przez kamery stereowizyjne i sensory głębi robota, rzutując poszczególne klatki na gęstą siatkę wektorów reprezentacji. Kluczowym zabiegiem treningowym jest maskowanie znacznej części czasoprzestrzennego bloku danych. Zadaniem modułu predyktora nie jest jednak rekonstrukcja brakujących pikseli, co zmuszałoby sieć do zapamiętywania detali tekstur, lecz przewidzenie wektorów cech ukrytych w przestrzeni latentnej.
W celu uniknięcia zapadania się reprezentacji do trywialnego stanu stałego, co jest klasyczną pułapką w architekturach bez generatywnego dekodera, inżynierowie stosują asymetryczne wagi sieci oraz mechanizm momentum ekspotencjalnego średniej kroczącej Exponential Moving Average. Enkoder docelowy aktualizuje swoje parametry powoli na podstawie wag enkodera kontekstowego, tworząc stabilny punkt odniesienia dla funkcji straty opartej na odległości L1 lub kosinusowej w przestrzeni reprezentacji. W efekcie sieć uczy się wyodrębniać niezmienniki fizyczne, takie jak stałość obiektów w czasie, ciągłość trajektorii ruchu, grawitacja oraz nieprzenikalność ciał stałych.
Gdy tak wytrenowany model świata zostanie połączony z wejściem opisującym planned action robota, moduł predyktora potrafi symulować wewnętrznie przyszłe stany środowiska w ułamku milisekundy. Robot może przetestować dziesiątki alternatywnych trajektorii ruchu ramienia lub kroków w swoim wewnętrznym modelu mentalnym, ocenić prawdopodobieństwo sukcesu oraz koszt energetyczny każdej z nich, a następnie wybrać optymalną ścieżkę sterowania bez konieczności wykonywania ryzykownych prób w fizycznym świecie. To właśnie zdolność do wewnętrznego przewidywania bez generowania pikseli stanowi istotę wyższej inteligencji motorycznej.
Od symulacji Sim2Real do fizyki w pętli sterowania MPC
Przeniesienie modeli świata z serwerów obliczeniowych na fizyczny pokład autonomicznego humanoida wymaga rozwiązania problemu transferu wiedzy ze środowisk symulacyjnych do rzeczywistości, znanego jako Sim2Real gap. Współczesne potoki szkoleniowe wykorzystują silniki fizyki oparte na różniczkowalnej dynamice ciał sztywnych i odkształcalnych, takie jak MuJoCo, Isaac Sim czy Brax. Dzięki pełnej różniczkowalności symulatora gradienty funkcji straty mogą płynąć bezpośrednio od błędu trajektorii robota aż do parametrów modelu świata i sieci sterującej, co przyspiesza trening o wiele rzędów wielkości.
Aby jednak model nie nauczył się idealizowanych, nierealistycznych właściwości wirtualnego świata, stosuje się zaawansowaną randomizację domenową Domain Randomization. W trakcie symulacji algorytmy losowo modyfikują współczynniki tarcia powierzchni, masy poszczególnych członów robota, luzy na przekładniach harmonicznych, szum pomiarowy jednostek inercyjnych IMU oraz opóźnienia w magistralach komunikacyjnych CAN FD i EtherCAT. W rezultacie model JEPA uczy się reprezentacji odpornych na zaburzenia, które zachowują idealną zbieżność po wgraniu wag do procesorów brzegowych fizycznego robota.
Na pokładzie maszyny model świata współpracuje bezpośrednio z algorytmami predykcyjnego sterowania modelem Model Predictive Control. Tradycyjne sterowniki MPC opierały się na uproszczonych modelach analitycznych, takich jak model odwróconego wahadła liniowego, które załamywały się w przypadku dynamicznych manewrów w trudnym terenie lub nieoczekiwanych potknięć. Uczenie maszynowe zastępuje te sztywne równania elastycznym, nieliniowym modelem świata, który w czasie rzeczywistym aktualizuje estymację macierzy bezwładności i wektora grawitacji. Kiedy humanoid staje na niestabilnym podłożu, model świata w kilkadziesiąt mikrosekund przewiduje tendencję do poślizgu i wysyła sygnał korekcyjny do siłowników z napędem quasi-bezpośrednim QDD, zapobiegając utracie równowagi zanim człowiek zdążyłby w ogóle zauważyć zachwianie.
Integracja semantyki językowej z dynamiką motoryczną
Prawdziwa siła współczesnych robotów ucieleśnionych tkwi w harmonijnej integracji wysokopoziomowego rozumowania semantycznego z niskopoziomowym sterowaniem dynamicznym. Podczas gdy modele językowe odpowiadają za dekompozycję abstrakcyjnego polecenia, na przykład polecenia uporządkowania warsztatu lub przygotowania posiłku, na logiczną sekwencję subzadań, model świata JEPA przekłada te zamiary na fizycznie wykonalne trajektorie przestrzenne.
W tej wielowarstwowej architekturze model semantyczny nie ingeruje bezpośrednio w napięcia podawane na uzwojenia silników bezszczotkowych BLDC. Zamiast tego generuje wektory celów w przestrzeni afordancji affordance space, wskazując modelowi świata, które obiekty podlegają manipulacji i jakie relacje przestrzenne powinny zostać osiągnięte. Model świata przeprowadza dynamiczną walidację geometryczną, sprawdzając, czy zaplanowany chwyt nie przekroczy ograniczeń momentu obrotowego w stawach łokciowych lub nie spowoduje kolizji korpusu z otaczającą infrastrukturą.
Dzięki temu podziałowi ról robot eliminuje zjawisko znane jako halucynacja wykonawcza. Klasyczny agent językowy może wydać polecenie podniesienia przedmiotu znajdującego się poza zasięgiem ramienia robota lub polecenie postawienia ciężkiego narzędzia na kruchej powierzchni szklanej. Model świata, posiadając wbudowane w przestrzeń latentną rozumienie masy, wytrzymałości materiałowej i zasięgu kinematycznego, natychmiast odrzuca taki plan działania, wymuszając na module wysokopoziomowym korektę strategii, na przykład przysunięcie się do stołu lub użycie oburęcznego chwytu asekuracyjnego.
Wyzwania sprzętowe i zapotrzebowanie energetyczne systemów brzegowych
Wdrożenie modeli świata w autonomicznych humanoidach stawia bezprecedensowe wymagania przed inżynierią sprzętową. W przeciwieństwie do stacjonarnych centrów danych robot jest ograniczony pojemnością pakietu akumulatorów litowo-jonowych, który musi jednocześnie zasilać potężne silniki napędowe o mocy szczytowej sięgającej kilku kilowatów oraz komputery pokładowe. Każdy wat energii zużyty na obliczenia skraca czas operacyjny robota, który w warunkach przemysłowych powinien wynosić co najmniej cztery do sześciu godzin ciągłej pracy.
Odpowiedzią na te ograniczenia jest projektowanie wyspecjalizowanych akceleratorów neuronowych NPU zoptymalizowanych pod kątem operacji na rzadkich macierzach i niskiej precyzji obliczeniowej FP8 oraz INT4. Nowoczesne platformy obliczeniowe dla robotyki integrują wielordzeniowe klastry procesorów z rdzeniami tensorowymi połączonymi szybkimi magistralami o przepustowości setek gigabajtów na sekundę. Pozwala to na wykonywanie inferencji modeli JEPA o rozmiarach rzędu kilkunastu miliardów parametrów bezpośrednio w głowie lub korpusie robota, całkowicie uniezależniając maszynę od łączności bezprzewodowej z chmurą obliczeniową.
Brak konieczności korzystania z sieci zewnętrznej ma kluczowe znaczenie z punktu widzenia bezpieczeństwa i odporności na zakłócenia. W środowiskach przemysłowych, magazynach logistycznych czy strefach katastrof naturalnych zasięg sieci Wi-Fi lub 5G może być niestabilny lub celowo zagłuszany. Humanoid sterowany przez pokładowy model świata zachowuje pełną autonomię decyzyjną i zdolność do precyzyjnej nawigacji nawet w warunkach całkowitej izolacji elektromagnetycznej, polegając wyłącznie na własnych zmysłach i wewnętrznej symulacji fizyki.
Perspektywy ewolucji w stronę ogólnej inteligencji fizycznej
Rozwój modeli świata wykracza daleko poza pojedyncze roboty humanoidalne. W laboratoriach badawczych trwają prace nad zunifikowanymi modelami fundamentów fizycznych Physical Foundation Models, które są trenowane na setkach tysięcy godzin zróżnicowanych danych telemetrycznych pochodzących z dronów, pojazdów autonomicznych, ramion przemysłowych oraz wielonożnych platform kroczących. Taki uniwersalny model uczy się wspólnego mianownika fizyki wszechświata, rozumiejąc zachowanie cieczy, gazów, materiałów sypkich i konstrukcji mechanicznych.
Gdy robot napotyka zupełnie nowy obiekt, z którym nigdy wcześniej nie miał do czynienia, nie musi uczyć się jego obsługi od zera metodą prób i błędów. Uniwersalny model świata na podstawie kilku klatek obserwacji sensorycznej dokonuje błyskawicznej estymacji gęstości, środka ciężkości oraz współczynnika tarcia nowego przedmiotu, przypisując go do odpowiedniego klastra w przestrzeni latentnej. W efekcie robot potrafi natychmiast bezpiecznie manipulować miękkim owocem, szklaną butelką czy ciężkim metalowym elementem konstrukcyjnym z taką samą intuicyjną pewnością, jaką dysponuje dorosły człowiek.
Wkroczenie modeli świata do robotyki oznacza ostateczne pożegnanie z epoką sztywno zaprogramowanych automatów przemysłowych, które wymagały idealnie skalibrowanego otoczenia i zatrzymywały się przy najmniejszym nieprzewidzianym zakłóceniu. Ucieleśniona sztuczna inteligencja oparta na architekturze JEPA reprezentuje nadejście maszyn o prawdziwej intuicji fizycznej, zdolnych do adaptacji w czasie rzeczywistym i bezpiecznego współistnienia z ludźmi w dynamicznym, nieprzewidywalnym świecie.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
0Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.