
Modele rozumujące Test-Time Compute i skalowanie wnioskowania: Jak drzewa myśli Tree of Thoughts, weryfikatory PRM i wyszukiwanie w czasie inferencji redefiniują prawo Chinchilla
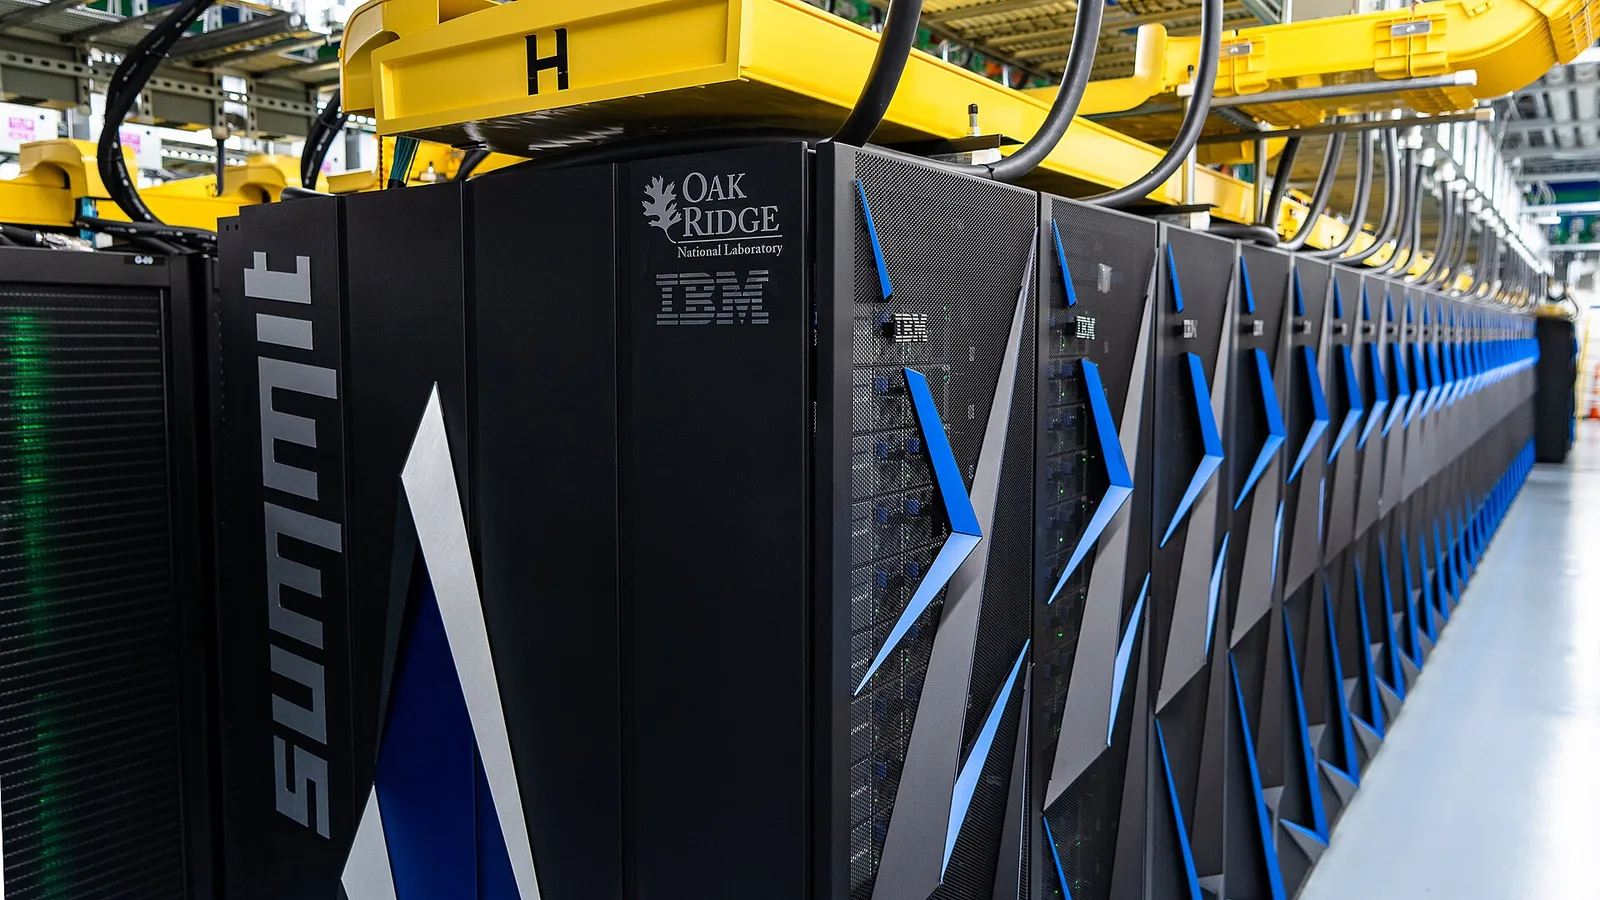
Przez ostatnie pięć lat rozwój sztucznej inteligencji opartej na architekturze transformatora był bezdyskusyjnie zdominowany przez tak zwane prawa skalowania Scaling Laws, sformułowane początkowo przez badaczy z OpenAI, a następnie doprecyzowane w fundamentalnej pracy zespołu DeepMind dotyczącej modelu Chinchilla. Zgodnie z tym paradygmatem, wzrost zdolności kognitywnych i spadek straty entropijnej modeli językowych był bezpośrednią funkcją dwóch powiązanych ze sobą zmiennych: całkowitej liczby parametrów sieci neuronowej oraz objętości wysokojakościowych tokenów treningowych wprowadzanych do optymalizatora w fazie Pre-training. Jednakże w połowie bieżącej dekady przemysł technologiczny zderzył się z potężną ścianą podwójnego ograniczenia. Z jednej strony wyczerpaniu uległy globalne zasoby unikalnego tekstu wytworzonego przez ludzkość, z drugiej zaś gigantyczne zapotrzebowanie energetyczne klastrów trenujących modele o bilionach parametrów osiągnęło pułap setek megawatów, stawiając pod znakiem zapytania ekonomiczny sens dalszego powiększania monolitycznych wag.
Granice klasycznego skalowania i geneza Test-Time Compute
W obliczu wyczerpania się tradycyjnej ścieżki ekstensywnego wzrostu nastąpił fundamentalny przełom pojęciowy, który zredefiniował rozumienie wydajności sztucznej inteligencji. Zamiast pompować setki milionów dolarów w jednorazowy trening modelu bazowego, który podczas wnioskowania generuje odpowiedź w ułamku sekundy metodą zachłannego próbkowania kolejnych tokenów, inżynierowie zwrócili uwagę na asymetrię pomiędzy czasem poświęconym na naukę a czasem poświęconym na myślenie w momencie generowania rozwiązania. Koncepcja obliczeń w czasie wnioskowania, w literaturze naukowej określana powszechnie jako Test-Time Compute w skrócie TTC lub Inference-Time Compute, zakłada, że model może dynamicznie alokować dodatkowe cykle procesorów graficznych podczas formułowania odpowiedzi, eksplorując alternatywne ścieżki rozumowania, korygując własne błędy i weryfikując pośrednie hipotezy logiczne.
Z perspektywy psychologii poznawczej i teorii decyzji przejście to jest bezpośrednim odpowiednikiem przejścia od Systemu Pierwszego do Systemu Drugiego w modelu Daniela Kahnemana. Standardowe transformatory autoregresyjne operują w reżimie intuicyjnym i natychmiastowym: każdy kolejny token jest generowany ze stałą złożonością obliczeniową O(1) na poziomie pojedynczego przejścia w przód Feed-Forward, co uniemożliwia modelowi zatrzymanie się i głębsze przemyślenie trudnego problemu matematycznego czy dowodu formalnego. Wdrożenie Test-Time Compute wyposaża model w zdolność do deliberacji, pozwalając na zamianę mocy obliczeniowej zużywanej podczas inferencji na wykładniczy wzrost trafności odpowiedzi w zadaniach wymagających rygorystycznego rozumowania wielokrokowego.
Kluczowym matematycznym fundamentem tego zjawiska jest nowe prawo skalowania wnioskowania Inference Scaling Law. Badania empiryczne nad rodzinami modeli rozumujących, takimi jak o1 oraz o3, wykazały, że zależność pomiędzy liczbą operacji zmiennoprzecinkowych FLOPs zużytych w fazie testowej a wskaźnikiem poprawności odpowiedzi w testach olimpijskich z matematyki czy programowania podlega prawu potęgowemu o nachyleniu znacznie korzystniejszym niż prawo skalowania przedtreningowego. Model o umiarkowanej liczbie miliardów parametrów, wyposażony w odpowiedni budżet obliczeniowy w czasie inferencji, jest w stanie zdeklasować gigantyczny model bazowy działający w trybie zero-shot, co całkowicie zmienia kalkulację kosztów wdrażania sztucznej inteligencji w środowiskach produkcyjnych.
Łańcuchy myśli Chain-of-Thought i ukryte tokeny deliberacyjne
Technologicznym punktem wyjścia dla skalowania wnioskowania była technika łańcucha myśli Chain-of-Thought CoT, wprowadzona początkowo jako metoda inżynierii podpowiedzi Few-Shot Prompting. W klasycznym podejściu model był zmuszany do wygenerowania ciągu pośrednich kroków tekstowych przed podaniem ostatecznego wyniku. W najnowszych modelach rozumujących paradygmat ten uległ jednak radykalnej ewolucji: łańcuch myśli przestał być jedynie zewnętrzną instrukcją, stając się natywnym, wewnętrznym stanem ukrytym modelu. Sieć neuronowa w trakcie generowania tworzy tysiące tak zwanych tokenów myślenia Thinking Tokens, które nie są prezentowane użytkownikowi końcowemu, lecz służą jako dynamiczny bufor roboczy pamięci roboczej Transformer Scratchpad.
W obrębie tych ukrytych sekwencji model realizuje procesy autokorekty, symuluje różne warianty dowodów, wykrywa wewnętrzne sprzeczności logiczne i cofa się do wcześniejszych węzłów decyzyjnych w przypadku napotkania ślepego zaułka Backtracking. Obecność tokenów myślenia pozwala mechanizmowi wielogłowicowej uwagi Multi-Head Attention na alokowanie wag do krytycznych założeń początkowych przez setki kroków generacji, eliminując zjawisko zanikania kontekstu i degradacji pamięci roboczej, które dotychczas paraliżowało długie procesy wnioskowania w architekturach czysto autoregresyjnych.
Co niezwykle istotne, długość łańcucha deliberacji może być dynamicznie adaptowana do stopnia trudności zadania. Podczas gdy dla prostych zapytań faktycznych model zużywa zaledwie kilkadziesiąt tokenów myślenia, w przypadku skomplikowanych zagadnień z zakresu topologii algebraicznej, syntezy chemicznej czy audytu kodu podatnościowego zero-day sekwencja deliberacyjna może osiągać dziesiątki tysięcy tokenów. W ten sposób koszt obliczeniowy inferencji staje się zmienną elastyczną, optymalizowaną pod kątem wartości biznesowej uzyskiwanego rozwiązania.
Procesowe modele nagrody PRM i weryfikacja krok po kroku
Kluczowym elementem warunkującym sukces skalowania wnioskowania jest odejście od tradycyjnych modeli nagrody za wynik Outcome-supervised Reward Models ORM na rzecz procesowych modeli nagrody Process-supervised Reward Models PRM. Klasyczne uczenie ze wzmocnieniem z ludzką informacją zwrotną RLHF oceniało wyłącznie ostateczną odpowiedź wygenerowaną przez model na zasadzie binarnej nagrody sukces-porażka. W przypadku wieloetapowego rozumowania podejście to było głęboko wadliwe, faworyzując tak zwane zjawisko fałszywego sukcesu False Positive, w którym model dochodził do poprawnego wyniku numerycznego na drodze całkowicie błędnych, kompensujących się przesłanek logicznych.
Procesowy model nagrody PRM dokonuje drobnoziarnistej ewaluacji każdego pojedynczego kroku myślowego z osobna. Wytrenowany na gęsto adnotowanych zbiorach kroków logicznych, PRM przypisuje prawdopodobieństwo poprawności każdemu zdaniu lub operacji matematycznej w wygenerowanym ciągu. Pozwala to na natychmiastowe wykrycie halucynacji w momencie jej powstania, zanim błędne założenie skazi kolejne etapy rozumowania. Zastosowanie PRM umożliwia implementację zaawansowanych algorytmów przeszukiwania przestrzeni stanów, w których model nagrody pełni rolę funkcji heurystycznej oceniającej jakość poszczególnych gałęzi drzewa obliczeniowego.
Ponadto procesowa informacja zwrotna drastycznie zwiększa efektywność próbkowania modeli w fazie Reinforcement Learning. Zamiast czekać na wygenerowanie całej wielotysięcznej sekwencji, gradient optymalizacyjny PPO lub DPO może być aplikowany bezpośrednio do tokenów decyzyjnych w miejscu wystąpienia błędu, co przyspiesza zbieżność treningu i zapobiega utrwalaniu się patologicznych wzorców generacji w wagach sieci.
Algorytmy przeszukiwania: Drzewa myśli Tree of Thoughts i MCTS
Wyposażenie modelu w procesowy ewaluator PRM otwiera drogę do integracji transformatorów z klasycznymi algorytmami teorii grafów i przeszukiwania drzew decyzyjnych, znanymi z systemów AlphaGo czy Deep Blue. W architekturze drzew myśli Tree of Thoughts ToT oraz wariantach opartych na przeszukiwaniu drzew Monte Carlo Monte Carlo Tree Search MCTS proces generowania odpowiedzi przestaje być liniowym ciągiem tokenów, przekształcając się w wielowymiarową eksplorację przestrzeni rozwiązań.
W każdym węźle decyzyjnym model generuje kilka alternatywnych propozycji kolejnego kroku logicznego. Procesowy model nagrody ocenia każdą z nich, po czym algorytm przeszukiwania, sterowany kryteriami takimi jak Upper Confidence Bound applied to Trees UCT, decyduje o pogłębieniu najbardziej obiecującej gałęzi lub wycofaniu się do węzła nadrzędnego. W przypadku problemów kombinatorycznych, takich jak synteza obwodów logicznych czy dowodzenie twierdzeń w językach formalnych Lean i Coq, technika ta pozwala na przeszukanie tysięcy trajektorii w czasie rzeczywistym i wybór ścieżki o najwyższej spójności matematycznej.
Równie popularną i wysoce efektywną techniką jest próbkowanie z najlepszym wyborem Best-of-N z wykorzystaniem większościowego głosowania Self-Consistency. W tym schemacie model generuje N niezależnych łańcuchów rozumowania przy niezerowej temperaturze próbkowania, a ostateczna odpowiedź jest wybierana na drodze konsensusu lub na podstawie najwyższej skumulowanej oceny z modelu PRM. Zwiększanie parametru N pozwala na płynne skalowanie zużycia energii obliczeniowej i podnoszenie pewności statystycznej generowanego wyniku w zadaniach o krytycznym znaczeniu dla bezpieczeństwa.
Architektura sprzętowa i wyzwania infrastrukturalne inferencji TTC
Masowe wdrożenie paradygmatu Test-Time Compute wywołuje gigantyczny wstrząs w architekturze centrów danych wysokiej wydajności. Dotychczasowa infrastruktura chmurowa była projektowana z myślą o dominacji obciążeń treningowych, wymagających potężnych klastrów akceleratorów spiętych ultraszybkimi magistralami NVLink i InfiniBand o niskiej latencji, podczas gdy inferencja była traktowana jako zadanie drugorzędne, realizowane na tańszych, pojedynczych instancjach obliczeniowych. Przejście na modele deliberacyjne sprawia, że pojedyncze zapytanie użytkownika może wymagać zaangażowania całego węzła serwerowego wyposażonego w osiem akceleratorów przez kilkadziesiąt sekund lub nawet minut.
Krytycznym wąskim gardłem staje się przepustowość i pojemność pamięci o wysokiej gęstości High Bandwidth Memory HBM na akceleratorach graficznych. Utrzymywanie w pamięci podręcznej gigantycznych struktur kluczy i wartości KV Cache dla setek równolegle eksplorowanych gałęzi drzewa MCTS prowadzi do zjawiska fragmentacji pamięci i grozi przerwaniem obliczeń z powodu braku miejsca w VRAM. Aby temu zaradzić, twórcy silników inferencyjnych, takich jak vLLM czy TensorRT-LLM, wdrażają zaawansowane mechanizmy stronicowania pamięci PagedAttention oraz techniki kwantyzacji KV Cache do formatów FP8 i INT4, które redukują zapotrzebowanie na pamięć o ponad siedemdziesiąt procent bez degradacji precyzji obliczeń.
Równolegle rozwija się technologia spekulatywnego dekodowania Speculative Decoding w środowiskach wielomodelowych. Mały, zwinny model pomocniczy o wielkości kilku miliardów parametrów generuje robocze propozycje kroków myślowych z ogromną szybkością, po czym potężny model główny weryfikuje cały blok tokenów w pojedynczym przejściu w przód. Taka hybrydowa architektura pozwala na trzykrotne skrócenie czasu odpowiedzi i drastyczne obniżenie kosztu energetycznego alokowanego na pojedyncze zapytanie deliberacyjne.
Ewolucja syntetycznych danych i samodoskonalenie modeli
Jedną z najbardziej fascynujących konsekwencji wdrożenia Test-Time Compute jest przełamanie bariery braku danych treningowych poprzez zjawisko autonomicznego generowania danych syntetycznych wysokiej jakości. Kiedy model wyposażony w weryfikator formalny lub silnik wykonawczy kodu rozwiązuje skomplikowany problem matematyczny, wygenerowany przez niego łańcuch myśli, który doprowadził do zweryfikowanego, bezbłędnego wyniku, stanowi idealny materiał treningowy dla kolejnej generacji sieci.
Proces ten, znany jako destylacja rozumowania Reasoning Distillation lub samouczenie STaR Self-Taught Reasoner, pozwala na zasilenie fazy przedtreningowej milionami syntetycznych trajektorii logicznych pozbawionych błędów ludzkich. Model uczy się internalizować najbardziej efektywne strategie przeszukiwania, co sprawia, że w kolejnych iteracjach potrzebuje coraz mniejszej liczby tokenów myślenia do rozwiązania zadań o tym samym stopniu skomplikowania. Prowadzi to do powstania samonapędzającej się pętli doskonalenia kognitywnego, w której jakość danych treningowych rośnie wraz ze wzrostem mocy obliczeniowej alokowanej w fazie wnioskowania.
Zjawisko to ma fundamentalne znaczenie dla automatyzacji badań naukowych, syntezy nowych leków oraz weryfikacji oprogramowania krytycznego. Zamiast ograniczać się do naśladowania ludzkiego stylu pisania zawartego w publicznym internecie, modele rozumujące zaczynają odkrywać niekonwencjonalne metody dowodowe i algorytmiczne, przekraczające dotychczasowe ramy ludzkiej heurystyki poznawczej.
Matematyczna teoria optymalnego podziału budżetu obliczeniowego
Fundamentalnym zagadnieniem teoretycznym stojącym przed twórcami systemów nowej generacji jest optymalny podział dostępnego budżetu obliczeniowego pomiędzy fazę przedtreningową, dostrajanie ze wzmocnieniem RL oraz alokację zasobów w czasie wnioskowania. Tradycyjna teoria Chinchilla zakładała stały współczynnik alokacji, optymalizując jedynie zależność pomiędzy liczbą parametrów a liczbą tokenów treningowych przy stałym koszcie pojedynczego przejścia w przód. W erze Test-Time Compute funkcja kosztu staje się trójwymiarowa, uwzględniając dodatkowy wymiar głębokości i szerokości przeszukiwania w przestrzeni rozwiązań.
Z analizy Pareto wynika, że dla szerokiej klasy problemów algorytmicznych znacznie bardziej opłacalne pod względem energetycznym jest wytrenowanie mniejszego modelu, na przykład o wielkości kilkunastu miliardów parametrów, i pozwolenie mu na wykonanie wielokrotnych iteracji w pętli MCTS, niż trenowanie gigantycznego modelu o setkach miliardów wag działającego w trybie natychmiastowej odpowiedzi. Matematyczny model kompromisu obliczeniowego Compute Trade-off dowodzi, że krzywe zbieżności błędu w funkcji całkowitej liczby operacji zmiennoprzecinkowych FLOPs osiągają znacznie głębsze minima, gdy model ma możliwość dynamicznej alokacji zasobów w zależności od złożoności wejściowego promptu.
Architektury hybrydowe: Weryfikatory formalne i egzekucja kodu
Najwyższy poziom niezawodności w modelach rozumujących osiąga się poprzez integrację sieci neuronowych z deterministycznymi silnikami weryfikacji formalnej. W klasycznym podejściu model językowy generował tekst w języku naturalnym, którego poprawność mogła być oceniana jedynie probabilistycznie. W nowej architekturze proces generowania tokenów deliberacyjnych jest ściśle zintegrowany z zewnętrznymi interpreterami kodu programistycznego, takimi jak Python Sandbox, oraz asystentami dowodzenia twierdzeń matematycznych, takimi jak Lean 4 czy Isabelle.
Gdy model formułuje hipotezę pośrednią, automatycznie kompiluje ją do postaci kodu formalnego i przesyła do zewnętrznego środowiska wykonawczego. Jeśli kompilator zgłosi błąd składniowy, naruszenie typów lub niezgodność logiczną, komunikat o błędzie jest natychmiast przekształcany w token zwrotny i wprowadzany do bufora myślenia jako negatywny bodziec. Model wykorzystuje tę twardą, deterministyczną informację do natychmiastowego skorygowania toku rozumowania. Taka symbioza elastyczności heurystycznej sieci neuronowych z matematyczną bezwzględnością formalnych kompilatorów całkowicie eliminuje problem halucynacji w zadaniach dowodowych i inżynieryjnych.
Wpływ na automatyzację programowania i audyt cyberbezpieczeństwa
Praktyczne wdrożenie modeli deliberacyjnych wywołuje tektoniczne zmiany w sektorze inżynierii oprogramowania oraz bezpieczeństwa teleinformatycznego. Tradycyjne asystenty kodowania oparte na modelach pierwszej generacji sprawdzały się jedynie w prostych zadaniach autouzupełniania składni lub generowania nieskomplikowanych funkcji pomocniczych, często wprowadzając subtelne luki bezpieczeństwa i błędy architektury logicznej. Modele wyposażone w Test-Time Compute są w stanie przeprowadzać wielogodzinne symulacje wykonania kodu, analizować przepływ danych w architekturach rozproszonych oraz automatycznie generować kompleksowe pakiety testów jednostkowych i integracyjnych.
W dziedzinie cyberbezpieczeństwa modele te rewolucjonizują procedury audytu binarnego i wyszukiwania podatności typu zero-day. Działając w pętli deliberacyjnej, model analizuje zdeasemblowany kod maszynowy, formułuje hipotezy dotyczące przepełnienia bufora lub błędów typu Use-After-Free, a następnie w czasie rzeczywistym syntetyzuje i testuje wektory ataku w izolowanym środowisku wirtualnym. Ta bezprecedensowa zdolność do autonomicznej analizy przyczynowo-skutkowej przesuwa granice inżynierii odwrotnej, stawiając przed zespołami odpowiedzialnymi za bezpieczeństwo narodowe wymóg wdrożenia zautomatyzowanych systemów obrony operujących z prędkościami maszynowymi.
Ekonomia wnioskowania i dynamiczne zarządzanie zasilaniem klastrów
Przejście na masowe wykorzystanie technik Test-Time Compute wymusza również gruntowną rekonfigurację systemów zarządzania zasilaniem oraz bilansu cieplnego w wielkoskalowych centrach danych. W tradycyjnym modelu wnioskowania obciążenie układów GPU charakteryzowało się przewidywalnym profilem zużycia energii ze stosunkowo stałym poborem mocy na poziomie od czterystu do siedmiuset watów na akcelerator. W przypadku wnioskowania deliberacyjnego, w którym zapotrzebowanie obliczeniowe potrafi w ułamku sekundy wzrosnąć z poziomu spoczynkowego do maksymalnego limitu mocy TDP podczas równoległego rozwijania tysięcy gałęzi drzewa MCTS, zasilacze serwerowe i systemy dystrybucji zasilania PDU są narażone na gwałtowne skoki napięcia i zjawiska przejściowe dI/dt.
Aby zapobiec przeciążeniom lokalnych sieci energetycznych oraz degradacji komponentów krzemowych wywoływanej zmęczeniem termomechanicznym, w nowoczesnych klastrach AI wdraża się zaawansowane systemy dynamicznego skalowania częstotliwości i napięcia DVFS sterowane bezpośrednio przez orkiestrator inferencyjny. Algorytmy te analizują strukturę drzewa myśli i selektywnie obniżają taktowanie rdzeni wykonawczych dla gałęzi o niskiej przewidywanej wadze heurystycznej, rezerwując maksymalną moc obliczeniową wyłącznie dla weryfikacji krytycznych węzłów decyzyjnych przez model PRM.
Równolegle kluczowym parametrem staje się wskaźnik efektywności energetycznej wyrażany w liczbie poprawnie rozwiązanych problemów logicznych na kilowatogodzinę zużytej energii. Operatorzy chmur obliczeniowych wprowadzają wielopoziomowe taryfy energetyczne, w których zadania wymagające głębokiego namysłu są buforowane i kolejkowane w okresach nadpodaży zielonej energii ze źródeł fotowoltaicznych i wiatrowych. W ten sposób paradygmat Test-Time Compute łączy optymalizację algorytmiczną z globalną gospodarką elektroenergetyczną, udowadniając, że przyszłość sztucznej inteligencji zależy w równym stopniu od wyrafinowania matematycznego weryfikatorów, co od termodynamicznej sprawności infrastruktury sprzętowej.
Nie można również pominąć aspektu psychologicznego i interfejsowego dla użytkowników końcowych. Wprowadzenie widocznych wskaźników postępu myślenia oraz możliwości wglądu w podsumowane etapy deliberacji buduje zaufanie do decyzji podejmowanych przez modele w medycynie, prawie czy bankowości. Użytkownik widzi nie tylko końcowy werdykt, lecz także logiczne uzasadnienie odrzucenia konkurencyjnych hipotez, co stanowi fundament odpowiedzialnej i wyjaśnialnej sztucznej inteligencji Explainable AI w systemach o krytycznym znaczeniu.
Implikacje rynkowe i przyszłość paradygmatu obliczeniowego
Przejście od skalowania przedtreningowego do skalowania wnioskowania całkowicie przemodelowuje ekonomikę rynku sztucznej inteligencji. Przewaga konkurencyjna dostawców technologii przesuwa się z posiadania największego klastra treningowego na zdolność do efektywnej orkiestracji procesów wyszukiwania i weryfikacji w czasie rzeczywistym. Monetyzacja usług AI zaczyna opierać się na modelach wyceny zależnych od stopnia trudności zadania i ilości zużytych tokenów myślenia, co pozwala na oferowanie elastycznych poziomów usług Service Level Agreements SLA dla klientów korporacyjnych.
W perspektywie nadchodzących lat możemy spodziewać się pełnej fuzji modeli generatywnych z wyspecjalizowanymi solwerami matematycznymi, środowiskami symulacji fizycznych oraz autonomicznymi agentami programistycznymi. Test-Time Compute przestaje być jedynie techniczną optymalizacją czasu inferencji, stając się nowym paradygmatem uniwersalnego rozwiązywania problemów, w którym moc obliczeniowa jest bezpośrednio konwertowana w niezawodną wiedzę logiczną, przybliżając nas do realizacji prawdziwej sztucznej inteligencji ogólnej AGI.
W ostatecznym rozrachunku rewolucja Test-Time Compute redefiniuje relację pomiędzy człowiekiem a maszyną. Zamiast pasywnego generatora tekstu przypominającego zaawansowaną wyszukiwarkę semantyczną, otrzymujemy cyfrowego partnera intelektualnego zdolnego do rygorystycznej samokontroli i dialektycznego dyskursu z samym sobą. Zdolność do wydatkowania zasobów obliczeniowych wprost proporcjonalnie do wagi rozstrzyganego problemu sprawia, że sztuczna inteligencja przekracza próg czystej statystyki lingwistycznej, stając się uniwersalnym silnikiem dedukcyjnym zdolnym do rozwiązywania najbardziej złożonych wyzwań naukowych, inżynieryjnych i cywilizacyjnych współczesnego świata. Każda sekunda obliczeniowa spędzona na weryfikacji przybliża nas do ery w pełni autonomicznych systemów poznawczych nowej generacji.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.