
Kwantyzacja 1.58-bitowa BitNet b1.58 i architektury MatMul-Free: Jak ternarne wagi {-1, 0, 1} i eliminacja mnożenia macierzy redukują zapotrzebowanie energetyczne inferencji LLM o rząd wielkości
Kryzys energetyczny inferencji i kres skalowania architektury von Neumanna
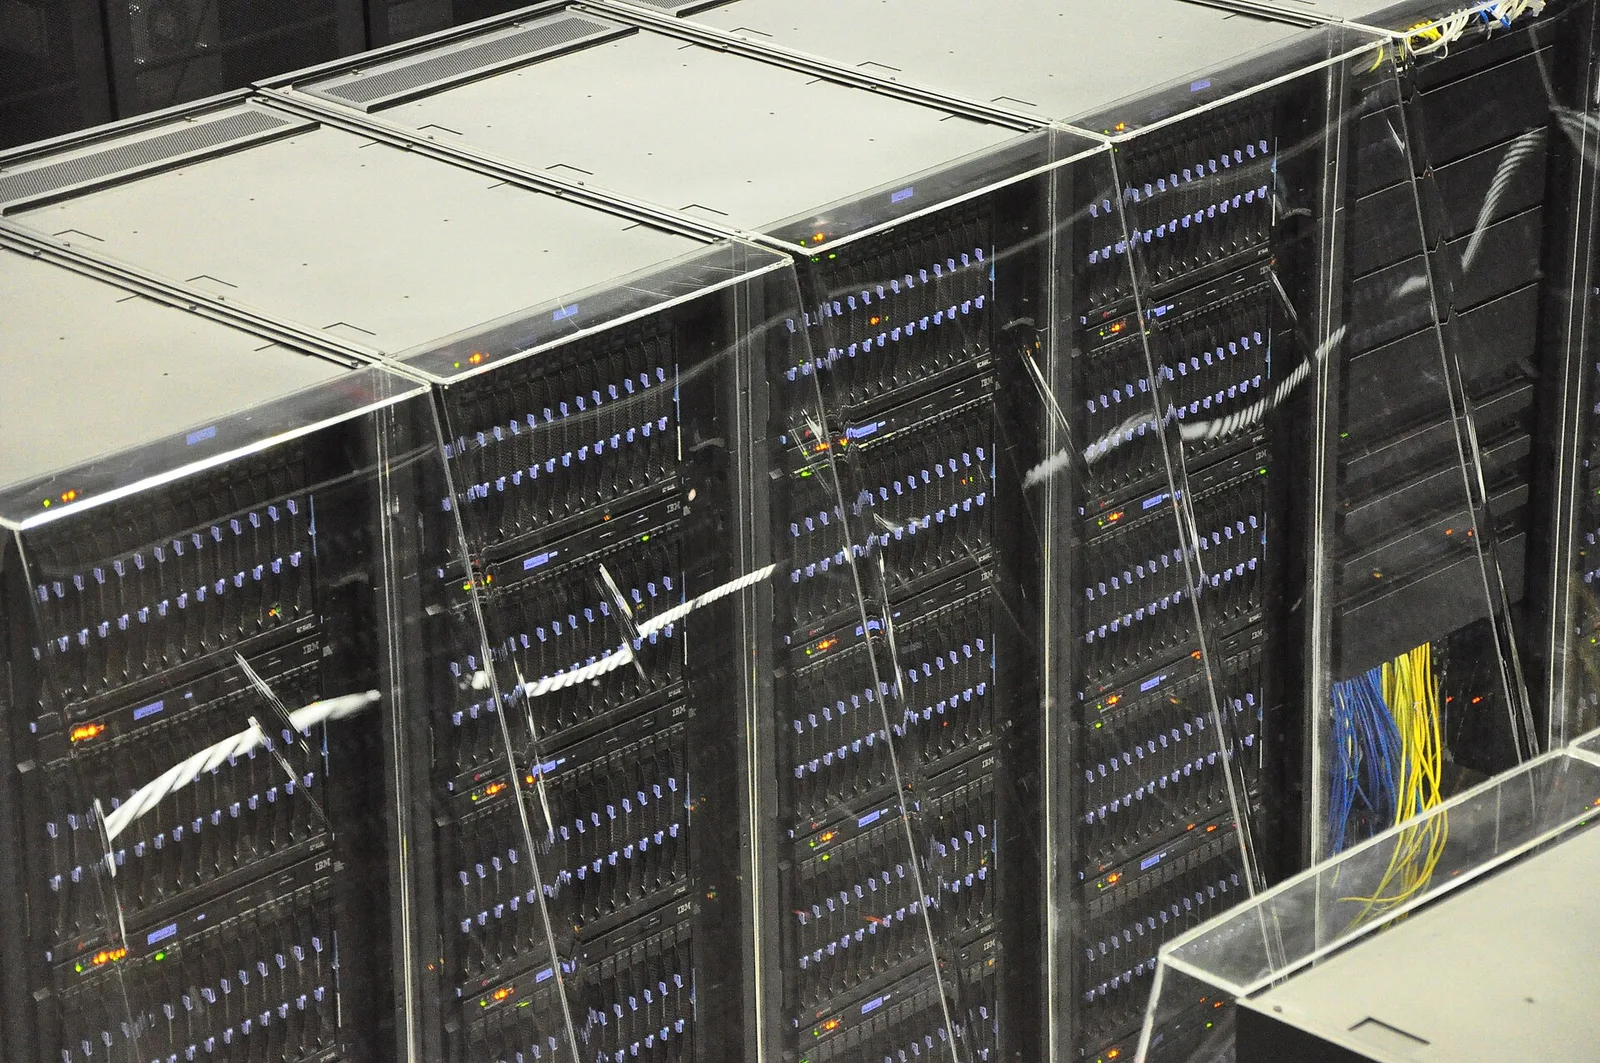
Współczesna eksplozja generatywnej sztucznej inteligencji, napędzana gigantycznymi modelami wielojęzycznymi i multimodalnymi, doprowadziła globalny ekosystem technologiczny do punktu krytycznego, w którym dalszy rozwój nie jest już hamowany brakiem danych treningowych, lecz fundamentalnymi ograniczeniami termodynamicznymi i energetycznymi krzemu. Tradycyjne akceleratory graficzne GPU oraz dedykowane procesory TPU opierają swoje działanie na wykonywaniu bilionów operacji mnożenia macierzy ze skumulowanym dodawaniem GEMM w formatach zmiennoprzecinkowych szesnasto- lub ośmiobitowych FP16, BF16 i FP8. Choć techniki te zapewniają niezrównaną precyzję w modelowaniu nieliniowych relacji językowych, koszt energetyczny i przepustowościowy nieustannego przesyłania setek gigabajtów wag modelowych z zewnętrznych pamięci HBM3e do rdzeni obliczeniowych stał się wąskim gardłem całej branży. W odpowiedzi na to wyzwanie badacze z Microsoft Research oraz niezależnych ośrodków akademickich zainicjowali najbardziej radykalną rewolucję w architekturze sieci neuronowych od czasu publikacji mechanizmu atencji: wprowadzenie kwantyzacji ternarnej BitNet b1.58 oraz modeli całkowicie pozbawionych operacji mnożenia macierzowego MatMul-Free.
Istota innowacji BitNet b1.58 leży w przedefiniowaniu fundamentalnej jednostki informacji reprezentującej stan parametrów modelu. W klasycznych sieciach wagi przyjmują ciągłe wartości rzeczywiste, co wymaga stosowania skomplikowanych jednostek zmiennoprzecinkowych FPU oraz zaawansowanych matryc tensorowych wyposażonych w precyzyjne mnożniki logiczne. W architekturze BitNet b1.58 każda waga zostaje sprowadzona do zaledwie trzech możliwych stanów dyskretnych: minus jeden, zero oraz plus jeden. Ponieważ do zakodowania trzech stanów logicznych z punktu widzenia teorii informacji Claude'a Shannona potrzeba logarytmu przy podstawie dwa z trzech bitów, czyli w przybliżeniu jeden i pięćdziesiąt osiem setnych bita, model ten zyskał nazwę BitNet b1.58. Skok jakościowy w porównaniu z wcześniejszymi podejściami 1-bitowymi 1-bit LLM polega na wprowadzeniu stanu zerowego, który odpowiada za selektywną rzadkość wag i pozwala modelowi na całkowite ignorowanie nieistotnych powiązań semantycznych bez utraty zdolności reprezentacyjnych.
Geneza 1-bitowych modeli językowych: Od BitNetu do standardu b1.58
Z matematycznego punktu widzenia proces kwantyzacji wag w warstwach BitLinear opiera się na zastosowaniu symetrycznej funkcji skalowania AbsMax. W odróżnieniu od klasycznej kwantyzacji post-treningowej PTQ, w której wagi są obcinane po zakończeniu fazy uczenia ze znaczną degradacją perplexity, BitNet jest trenowany od zera z wykorzystaniem dyskretyzacji wag w fazie propagacji w przód forward pass. Wektor wag jest najpierw normalizowany przez podzielenie przez średnią wartość bezwzględną elementów w tensorze, a następnie zaokrąglany do najbliższej liczby całkowitej ze zbioru minus jeden, zero, jeden. Z kolei aktywacje wejściowe zostają skwantowane do formatu całkowitoliczbowego INT8 przy użyciu asymetrycznego skalowania min-max. W ten sposób złożony iloczyn macierzy wag i wektora aktywacji ulega spektakularnej transformacji obliczeniowej: zamiast kosztownego mnożenia zmiennoprzecinkowego układ scalony wykonuje wyłącznie operacje dodawania i odejmowania liczb całkowitych zależnie od znaku wagi lub pomija operację, gdy waga wynosi zero.
Matematyka kwantyzacji ternarnej i funkcja skalowania AbsMax
Wpływ eliminacji operacji mnożenia macierzy na fizykę układów krzemowych jest trudny do przecenienia. W mikroelektronice cyfrowej wykonanie pojedynczej operacji mnożenia zmiennoprzecinkowego w formacie FP16 wymaga kilkudziesięciokrotnie większej liczby bramek logicznych i powierzchni krzemu oraz zużywa od dziesięciu do dwudziestu razy więcej energii mierzonej w pikodżulach niż proste dodanie dwóch liczb całkowitych w formacie INT8. Co więcej, w klasycznym modelu GEMM największym konsumentem energii nie są same jednostki arytmetyczno-logiczne ALU, lecz transfery danych pomiędzy pamięcią podręczną SRAM a rejestrami procesora. W architekturze BitNet b1.58 wagi modelu o rozmiarze siedemdziesięciu miliardów parametrów, które w formacie FP16 zajmują sto czterdzieści gigabajtów pamięci, ulegają kompresji do zaledwie czternastu gigabajtów. Taka redukcja objętości pozwala na całkowite wyeliminowanie konieczności stosowania wielowarstwowych stosów pamięci HBM3e o astronomicznych kosztach produkcji i zasilania.
Równolegle z rozwojem BitNetu inżynierowie z Uniwersytetu Kalifornijskiego w Santa Cruz zaprezentowali architekturę MatMul-Free LM, która idzie o krok dalej i usuwa operacje mnożenia macierzowego nie tylko z projekcji wag liniowych, lecz z absolutnie wszystkich komponentów modelu językowego, włączając w to mechanizm samouagi self-attention. W tradycyjnym Transformerze obliczanie macierzy uwagi wymaga wykonania dwóch kolejnych operacji GEMM: iloczynu macierzy zapytań Q i kluczy K transponowanych w celu wyznaczenia mapy atencji, a następnie wymnożenia znormalizowanej rozkładem softmax atencji przez macierz wartości V. W architekturze MatMul-Free klasyczna atencja zostaje zastąpiona przez zmodyfikowane rekurencyjne komórki liniowe typu BitLinear RNN oraz mechanizmy selektywnego bramkowania wzorowane na modelach stanów przestrzennych State Space Models, w których aktualizacja stanu ukrytego odbywa się wyłącznie na drodze dodawania wektorowego i elementarnych operacji bitowych shift i mask.
Eliminacja mnożenia macierzowego: Rewolucja czysto addytywnego przetwarzania
Analiza termodynamiczna transferu danych w centrach przetwarzania danych ujawnia, dlaczego architektury MatMul-Free i BitNet są postrzegane jako jedyna realna droga do przełamania bariery skalowania sztucznej inteligencji. Pobranie pojedynczego słowa maszynowego z zewnętrznej pamięci DRAM lub HBM zużywa od stu do dwustu pikodżuli energii, podczas gdy wykonanie lokalnej operacji dodawania w rejestrze układu pochłania zaledwie ułamek pikodżula. Zjawisko to, w literaturze inżynieryjnej określane jako wąskie gardło von Neumanna lub Memory Wall, sprawia, że współczesne karty graficzne spędzają większość cykli zegarowych na bezczynnym oczekiwaniu na nadejście danych z pamięci, wydzielając przy tym kolosalne ilości ciepła Joule'a. Spakowanie wag w format ternarny umożliwia umieszczenie całego modelu w lokalnych pamięciach podręcznych SRAM zintegrowanych bezpośrednio na płytce krzemowej, co winduje efektywność energetyczną inferencji o ponad dziewięćdziesiąt procent.
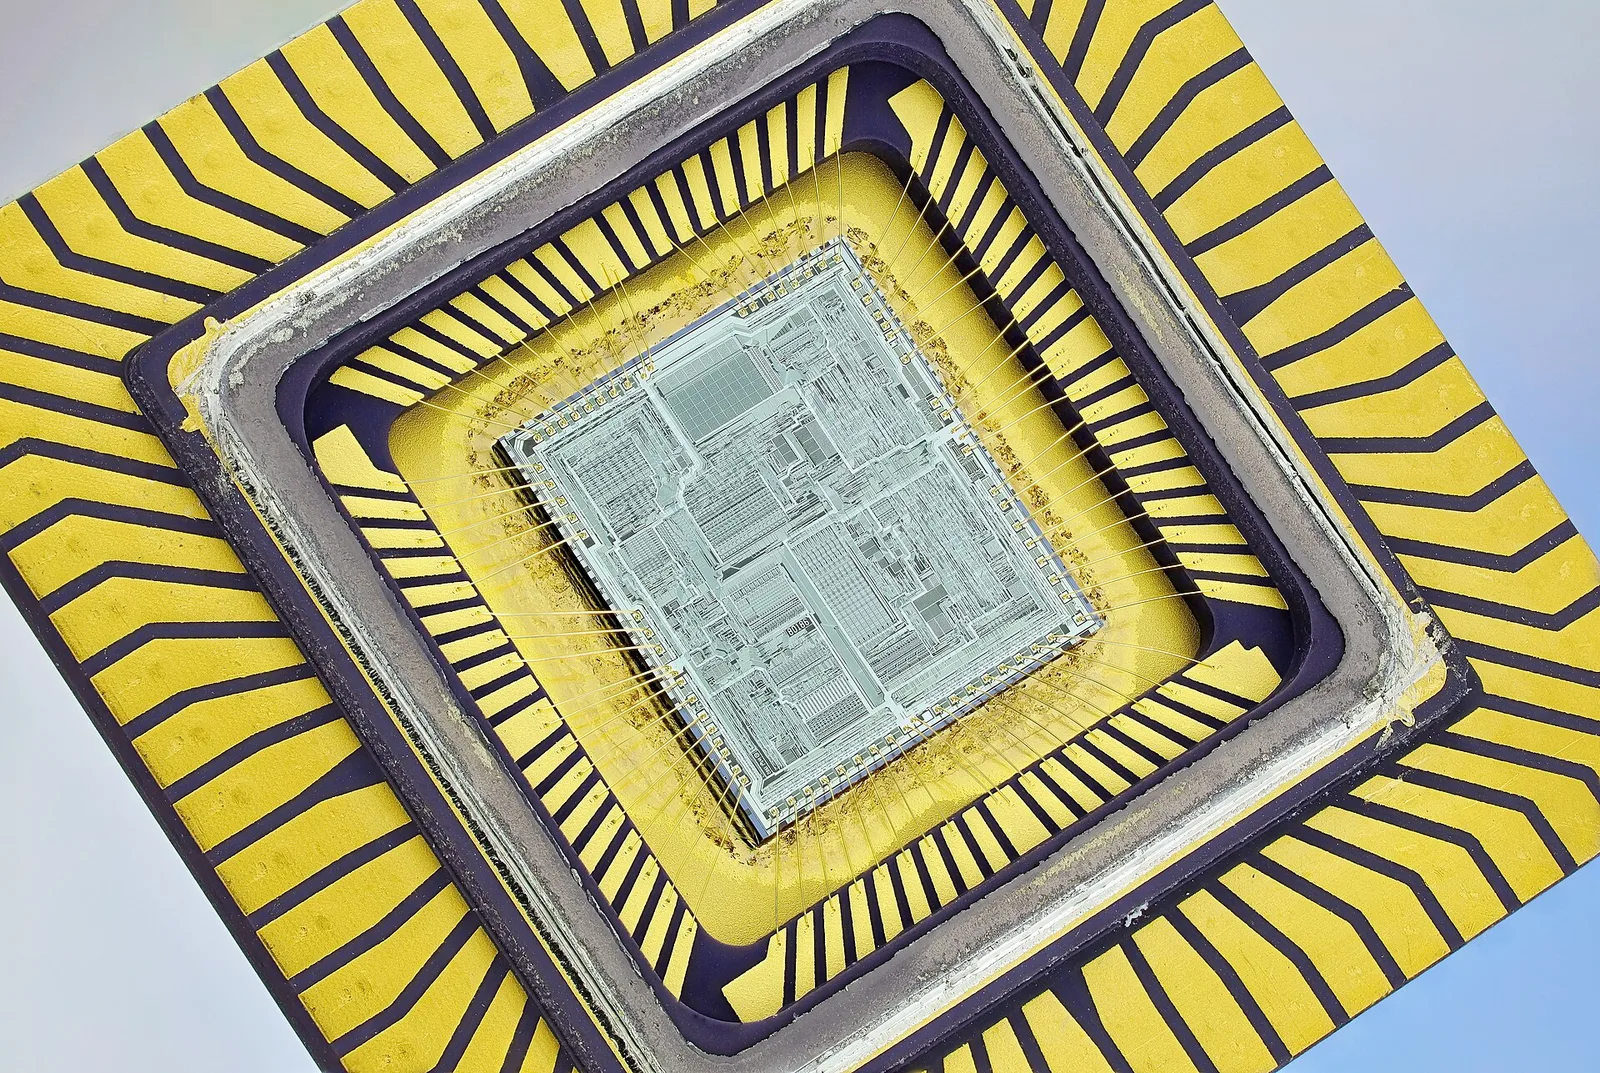
Z perspektywy projektowania wyspecjalizowanych procesorów ASIC i akceleratorów brzegowych technologia BitNet b1.58 całkowicie redefiniuje architekturę krzemu. Zamiast potężnych bloków tensorowych Tensor Cores o powierzchni dziesiątek milimetrów kwadratowych, matryca nowego procesora inferencyjnego składa się z gęstej siatki prostych sumatorów kaskadowych Carry-Save Adders oraz sieci multiplekserów sterowanych bezpośrednio bitami wag. Brak konieczności instalowania precyzyjnych mnożników sprawia, że na tej samej powierzchni płytki krzemowej można zmieścić od dziesięciu do dwudziestu razy więcej równoległych jednostek wykonawczych. Prototypy implementowane na układach FPGA przez zespoły badawcze wykazały ponad ośmiokrotny wzrost przepustowości tokenów na sekundę przy jednoczesnym pięciokrotnym spadku poboru mocy w porównaniu z najbardziej zoptymalizowanymi bibliotekami vLLM i TensorRT-LLM działającymi na układach NVIDIA A100.
Architektury MatMul-Free i alternatywy dla klasycznej atencji softmax
Najbardziej rewolucyjną konsekwencją praktyczną przejścia na kwantyzację ternarną jest demokratyzacja uruchamiania potężnych modeli językowych na urządzeniach końcowych Edge AI bez konieczności nawiązywania połączenia z chmurą obliczeniową. Dotychczas lokalna inferencja modeli o skali siedemdziesięciu miliardów parametrów wymagała stacji roboczych wyposażonych w co najmniej dwie profesjonalne karty graficzne o łącznym poborze mocy przekraczającym sześćset watów. Model BitNet b1.58 o tej samej liczbie parametrów mieści się w standardowej pamięci RAM laptopa lub smartfona nowej generacji i może być wykonywany z pełną prędkością generacji mowy w budżecie energetycznym poniżej dziesięciu watów na zintegrowanym procesorze neuronowym NPU. Otwiera to drogę do wdrożenia autonomicznych asystentów AI w robotyce humanoidalnej, bezzałogowych platformach bojowych oraz systemach medycznych chroniących prywatność danych pacjentów.
Wokół stabilności procesu treningowego modeli 1.58-bitowych przez długi czas narastały kontrowersje, wynikające z faktu, że funkcja zaokrąglenia do wartości całkowitych posiada zerową pochodną niemal w każdym punkcie, co uniemożliwia bezpośrednie stosowanie algorytmu wstecznej propagacji błędu SGD. Problem ten rozwiązano poprzez zastosowanie estymatora Straight-Through Estimator STE, w którym podczas propagacji w przód wykorzystuje się wagi zdyskretyzowane do postaci ternarnej, natomiast w propagacji wstecznej gradienty są przekazywane bezpośrednio do ukrytych wag zmiennoprzecinkowych o pełnej precyzji FP32. Utrzymywanie w pamięci optymalizatora wag o wysokiej precyzji pozwala na akumulację mikroskopijnych poprawek gradientowych i zapewnia stabilną konwergencję funkcji straty. Badania empiryczne na modelach o skali od stu milionów do siedemdziesięciu miliardów parametrów wytrenowanych na korpusach przekraczających cztery biliony tokenów dowiodły, że BitNet b1.58 osiąga identyczną biegłość językową i zdolności wnioskowania logicznego co pełnoprecyzyjne modele bazowe Llama czy Mistral.
Termodynamika krzemu: Przepustowość pamięci SRAM kontra gigadżule w HBM
Aby dokładnie zrozumieć mechanizm działania warstwy BitLinear, należy przeanalizować formalny zapis matematyczny procesu kwantyzacji. Przed przystąpieniem do transformacji liniowej wektor wejściowy jest normalizowany za pomocą warstwy RMSNorm, co stabilizuje wariancję aktywacji na przestrzeni kolejnych bloków sieci. Następnie współczynnik skalujący gamma dla aktywacji obliczany jest jako maksymalna wartość bezwzględna elementów wektora podzielona przez sto dwadzieścia siedem, co pozwala na przeskalowanie sygnału do pełnego zakresu dynamicznego ośmiobitowych liczb całkowitych ze znakiem przy użyciu operacji zaokrąglenia i obcięcia w przedziale od minus stu dwudziestu ośmiu do plus stu dwudziestu siedmiu. Z kolei w przypadku tensora wag macierzy współczynnik beta definiowany jest jako średnia arytmetyczna wartości bezwzględnych wszystkich wag w warstwie. Każda waga zostaje podzielona przez ten współczynnik, zaokrąglona do najbliższej wartości całkowitej i przycięta do zbioru minus jeden, zero oraz jeden. W efekcie w czasie inferencji operacja iloczynu skalarnego sprowadza się do sumowania elementów aktywacji odpowiadających wagom równym jeden, odejmowania elementów dla wag minus jeden oraz pomijania indeksów, gdzie wagi są zerowe, po czym końcowy wynik jest jednorazowo przemnażany przez iloczyn współczynników gamma i beta.
Porównanie podejścia BitNet z klasycznymi metodami kwantyzacji post-treningowej PTQ, takimi jak GPTQ, AWQ czy SmoothQuant, uwidacznia fundamentalną różnicę w zachowaniu reprezentacji geometrycznej przestrzeni ukrytych modelu. Tradycyjne techniki PTQ próbują skompresować wagi wytrenowane w formacie szesnastobitowym do czterech lub trzech bitów poprzez rozwiązywanie lokalnych problemów optymalizacji kwadratowej błędu rekonstrukcji. O ile przy czterech bitach degradacja perplexity pozostaje na poziomie akceptowalnym, o tyle zejście poniżej trzech bitów w metodach post-treningowych prowadzi do katastrofalnego załamania spójności semantycznej modelu, objawiającego się halucynacjami i zapętleniami tekstu. Dzieje się tak, ponieważ ciągła rozmaitość wag w FP16 zostaje brutalnie poszatkowana. BitNet natomiast wykorzystuje paradygmat uczenia ze świadomością kwantyzacji Quantization-Aware Training QAT, w którym sieć od pierwszej epoki uczy się znajdować optymalne atraktory i wagi odporne na dyskretyzację, kształtując geometrię wag w sposób naturalnie dopasowany do kraty ternarnej.
Dedykowane asiki i akceleratory sprzętowe nowej generacji
Innowacja w zakresie reprezentacji wag wymusiła również optymalizację formatów upakowania danych na poziomie magistrali pamięci podręcznych L1, L2 i L3. Ponieważ waga ternarna przyjmuje jeden z trzech stanów, przechowywanie jej w osobnym bajcie lub nawet w dwóch bitach prowadziłoby do marnotrawstwa pojemności pamięci, gdyż dwa bity mogą pomieścić cztery stany logiczne. Inżynierowie oprogramowania niskopoziomowego opracowali techniki upakowywania wag, w których pięć kolejnych wartości ternarnych zostaje zmapowanych na pojedynczy ośmiobitowy bajt. Matematyczna elegancja tego rozwiązania wynika z faktu, że trzy do potęgi piątej wynosi dokładnie dwieście czterdzieści trzy, co jest mniejsze od maksymalnej wartości bajtu równej dwieście pięćdziesiąt sześć. Dzięki temu współczynnik upakowania wynosi zaledwie jeden i sześć dziesiątych bita na wagę, co pozwala na zredukowanie objętości transferów danych z kontrolera pamięci do absolutnego minimum fizycznego.
W architekturze MatMul-Free LM zastąpienie mechanizmu atencji softmax przez nieliniowe bramkowanie i komórki rekurencyjne eliminuje drugi wielki filar kosztów obliczeniowych, jakim jest kwadratowa złożoność pamięciowa względem długości sekwencji kontekstu. W klasycznym Transformerze koszt pamięciowy przechowywania bufora kluczy i wartości KV Cache rośnie liniowo wraz z każdym kolejnym generowanym tokenem, osiągając przy kontekstach rzędu stu tysięcy tokenów rozmiary przekraczające pojemność pamięci operacyjnej samej karty graficznej. Modele MatMul-Free wykorzystują konstrukcję opartą na komórkach Gated Linear Unit GLU oraz zmodyfikowanych mechanizmach retencji RetNet, w których stan ukryty o stałym rozmiarze jest aktualizowany w czasie stałym O(1) na drodze dodawania wektorowego z elementarnym zanikiem wykładniczym. Sprawia to, że model może przetwarzać nieograniczenie długie dokumenty bez obawy o przepełnienie pamięci podręcznej i bez spadku prędkości generacji tekstu.
Wdrażanie modeli 70B na urządzeniach brzegowych w budżecie dziesięciu watów
Wymierną korzyścią przejścia na wagi ternarne jest ich idealne dopasowanie do technologii obliczeń w pamięci In-Memory Computing IMC oraz analogowych matryc memrystorowych Neuromorphic Crossbars. W klasycznych układach analogowych realizacja wielopoziomowych wag synaptycznych o wysokiej precyzji nastręczała gigantycznych trudności związanych z fluktuacjami termicznymi i szumem telegraficznym złączy półprzewodnikowych. W przypadku wag ternarnych stan wagi mapuje się w sposób binarny: wysoka przewodność w polaryzacji przewodzenia odpowiada wadze plus jeden, wysoka przewodność w polaryzacji zaporowej odpowiada wadze minus jeden, natomiast stan wysokiej rezystancji oznacza wagę zero. Zgodnie z prawami Kirchhoffa i Ohma całkowanie prądów w węzłach matrycy realizuje równoległe dodawanie w czasie rzeczywistym z zerowym opóźnieniem i zużyciem energii ograniczonym do energii przełączania ładunku pojemnościowego, co otwiera drogę do budowy procesorów neuromorficznych o sprawności energetycznej dorównującej ludzkiemu mózgowi.
Rozwój ekosystemu otwartego oprogramowania wokół BitNetu zaowocował powstaniem wysoce zoptymalizowanych silników inferencyjnych, takich jak BitNet.cpp oraz specjalistycznych kerneli napisanych w językach Triton i CUDA. Tradycyjne biblioteki matematyczne BLAS, optymalizowane przez dekady pod kątem mnożenia zmiennoprzecinkowego, okazują się bezużyteczne w świecie operacji czysto addytywnych. Nowe kernele wykorzystują zaawansowane instrukcje wektorowe procesorów ogólnego przeznaczenia, takie jak AVX-512 VNNI w architekturze x86 oraz instrukcje Neon i SVE w procesorach ARM, do jednoczesnego rozpakowywania spakowanych wag ternarnych i wykonywania równoległych sumowań na rejestrach wektorowych. Na procesorach Apple Silicon zintegrowany koprocesor akceleracji macierzowej AMX i silnik neuronowy Neural Engine wykazują ponad dziesięciokrotny spadek latencji pierwszego tokenu przy minimalnym zużyciu baterii.
Dynamika uczenia, stabilność gradientów i estymator Straight-Through Estimator
W kontekście infrastruktury fizycznej centrów danych wdrożenie modeli 1.58-bitowych przynosi rewolucyjne oszczędności w zakresie wskaźnika efektywności wykorzystania energii PUE Power Usage Effectiveness. Współczesne szafy serwerowe wypełnione akceleratorami chłodzonymi cieczą generują gęstości mocy cieplnej przekraczające czterdzieści do stu kilowatów na szafę, wymuszając projektowanie kosztownych instalacji chłodzenia immersyjnego lub bezpośredniego chłodzenia cieczą do płytki Direct-to-Chip. Serwery oparte na procesorach ternarnych generują zaledwie ułamek tego ciepła, co pozwala na powrót do prostego chłodzenia powietrznego oraz obniżenie kosztów kapitałowych CAPEX budowy nowych obiektów serwerowych o dziesiątki procent. Mniejsza emisja ciepła przekłada się również bezpośrednio na wyższą niezawodność komponentów elektronicznych i wydłużenie czasu bezawaryjnej pracy klastrów obliczeniowych.
Perspektywy rozwojowe technologii BitNet obejmują jej fuzję z architekturami rzadkich mieszanin ekspertów Mixture of Experts MoE oraz modelami multimodalnymi nowej generacji. W modelach MoE, takich jak Mixtral czy DBRX, zastosowanie wag ternarnych w połączeniu z dyskretnymi bramkami routingu pozwala na budowę gigantycznych sieci o bilionach parametrów, w których do każdego tokenu aktywowany jest tylko ułamek addytywnych wag, umożliwiając osiągnięcie niespotykanej dotąd pojemności wiedzy faktograficznej przy minimalnym narzucie obliczeniowym. Równolegle prowadzone są eksperymenty z kwantyzacją ternarną enkoderów wizyjnych Vision Transformers oraz modeli generacji mowy i wideo, co wskazuje, że zasada 1.58 bita nie jest jedynie wąską sztuczką dla modeli językowych, lecz uniwersalnym prawem optymalizacji reprezentacji wiedzy w głębokich sieciach neuronowych.
Rygor matematyczny warstwy BitLinear i skalowanie aktywacji
W obszarze architektury otwartego sprzętu Open-Source Hardware kwantyzacja ternarna BitNet wywołała bezprecedensowy renesans rozwoju otwartego standardu instrukcji RISC-V. Ponieważ komercyjni giganci półprzewodnikowi ściśle strzegą własności intelektualnej wokół swoich jednostek tensorowych, niezależne konsorcja inżynieryjne przystąpiły do standaryzacji rozszerzeń wektorowych dedykowanych wagom 1.58-bitowym w ramach specyfikacji RISC-V Vector RVV. Nowo projektowane mikrokontrolery i akceleratory brzegowe implementują wyspecjalizowane rozkazy maszynowe, które w jednym cyklu zegarowym pobierają wektor spakowanych wag ternarnych i wykonują równoległą akumulację na strumieniu danych wejściowych bez konieczności dekodowania do formatów pośrednich. Umożliwia to start-upom technologicznym oraz ośrodkom akademickim tworzenie wysoce konkurencyjnych układów scalonych AI bez ponoszenia wielomilionowych opłat licencyjnych na rzecz właścicieli architektur x86 czy ARM.
Z perspektywy epistemologicznej i neurobiologicznej sukces wag ternarnych rzuca nowe światło na fundamentalną naturę sztucznych i biologicznych sieci neuronowych. Przez dekady w społeczności uczenia maszynowego dominowało przekonanie, że do modelowania subtelnych niuansów języka ludzkiego i abstrakcyjnego rozumowania niezbędne są ciągłe, precyzyjne wartości wag zmiennoprzecinkowych. Doświadczenia z BitNet b1.58 dowodzą jednak, że kluczowa informacja w sieci neuronowej jest zakodowana w samej topologii połączeń i strukturze znaków wag, a nie w ich precyzyjnej amplitudzie. Trzy stany wag ternarnych stanowią bezpośredni odpowiednik biologicznych mechanizmów synaptycznych w ludzkiej korze mózgowej: waga plus jeden odpowiada synapsie pobudzającej, waga minus jeden działa jak synapsa hamująca, natomiast waga zero odzwierciedla brak połączenia funkcjonalnego. Ta zbieżność sugeruje, że kwantyzacja 1.58-bitowa nie jest jedynie kompromisem inżynieryjnym, lecz zbliżeniem architektury cyfrowej do optymalnych praw rządzących przetwarzaniem informacji w układach ożywionych.
Uczenie ze świadomością kwantyzacji QAT kontra techniki post-treningowe
Podsumowując, pojawienie się BitNet b1.58 i architektur MatMul-Free zamyka pierwszy, ekstensywny etap rewolucji głębokiego uczenia, w którym wzrost możliwości modeli osiągano wyłącznie poprzez bezwzględne skalowanie nakładów energetycznych i sprzętowych. Przejście od kosztownego mnożenia zmiennoprzecinkowego do czysto addytywnej arytmetyki ternarnej dowodzi, że największe przełomy w informatyce rodzą się na styku rygorystycznej teorii matematycznej i głębokiego zrozumienia fizyki półprzewodników. W erze, w której efektywność energetyczna staje się główną walutą postępu technologicznego, 1.58-bitowe modele językowe wyznaczają standard, na którym opierać się będzie kolejna dekada autonomicznych systemów sztucznej inteligencji.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.