
Jak dwa parametry potroiły wynik na ARC-AGI-3: OpenAI obnaża pułapki benchmarków AI
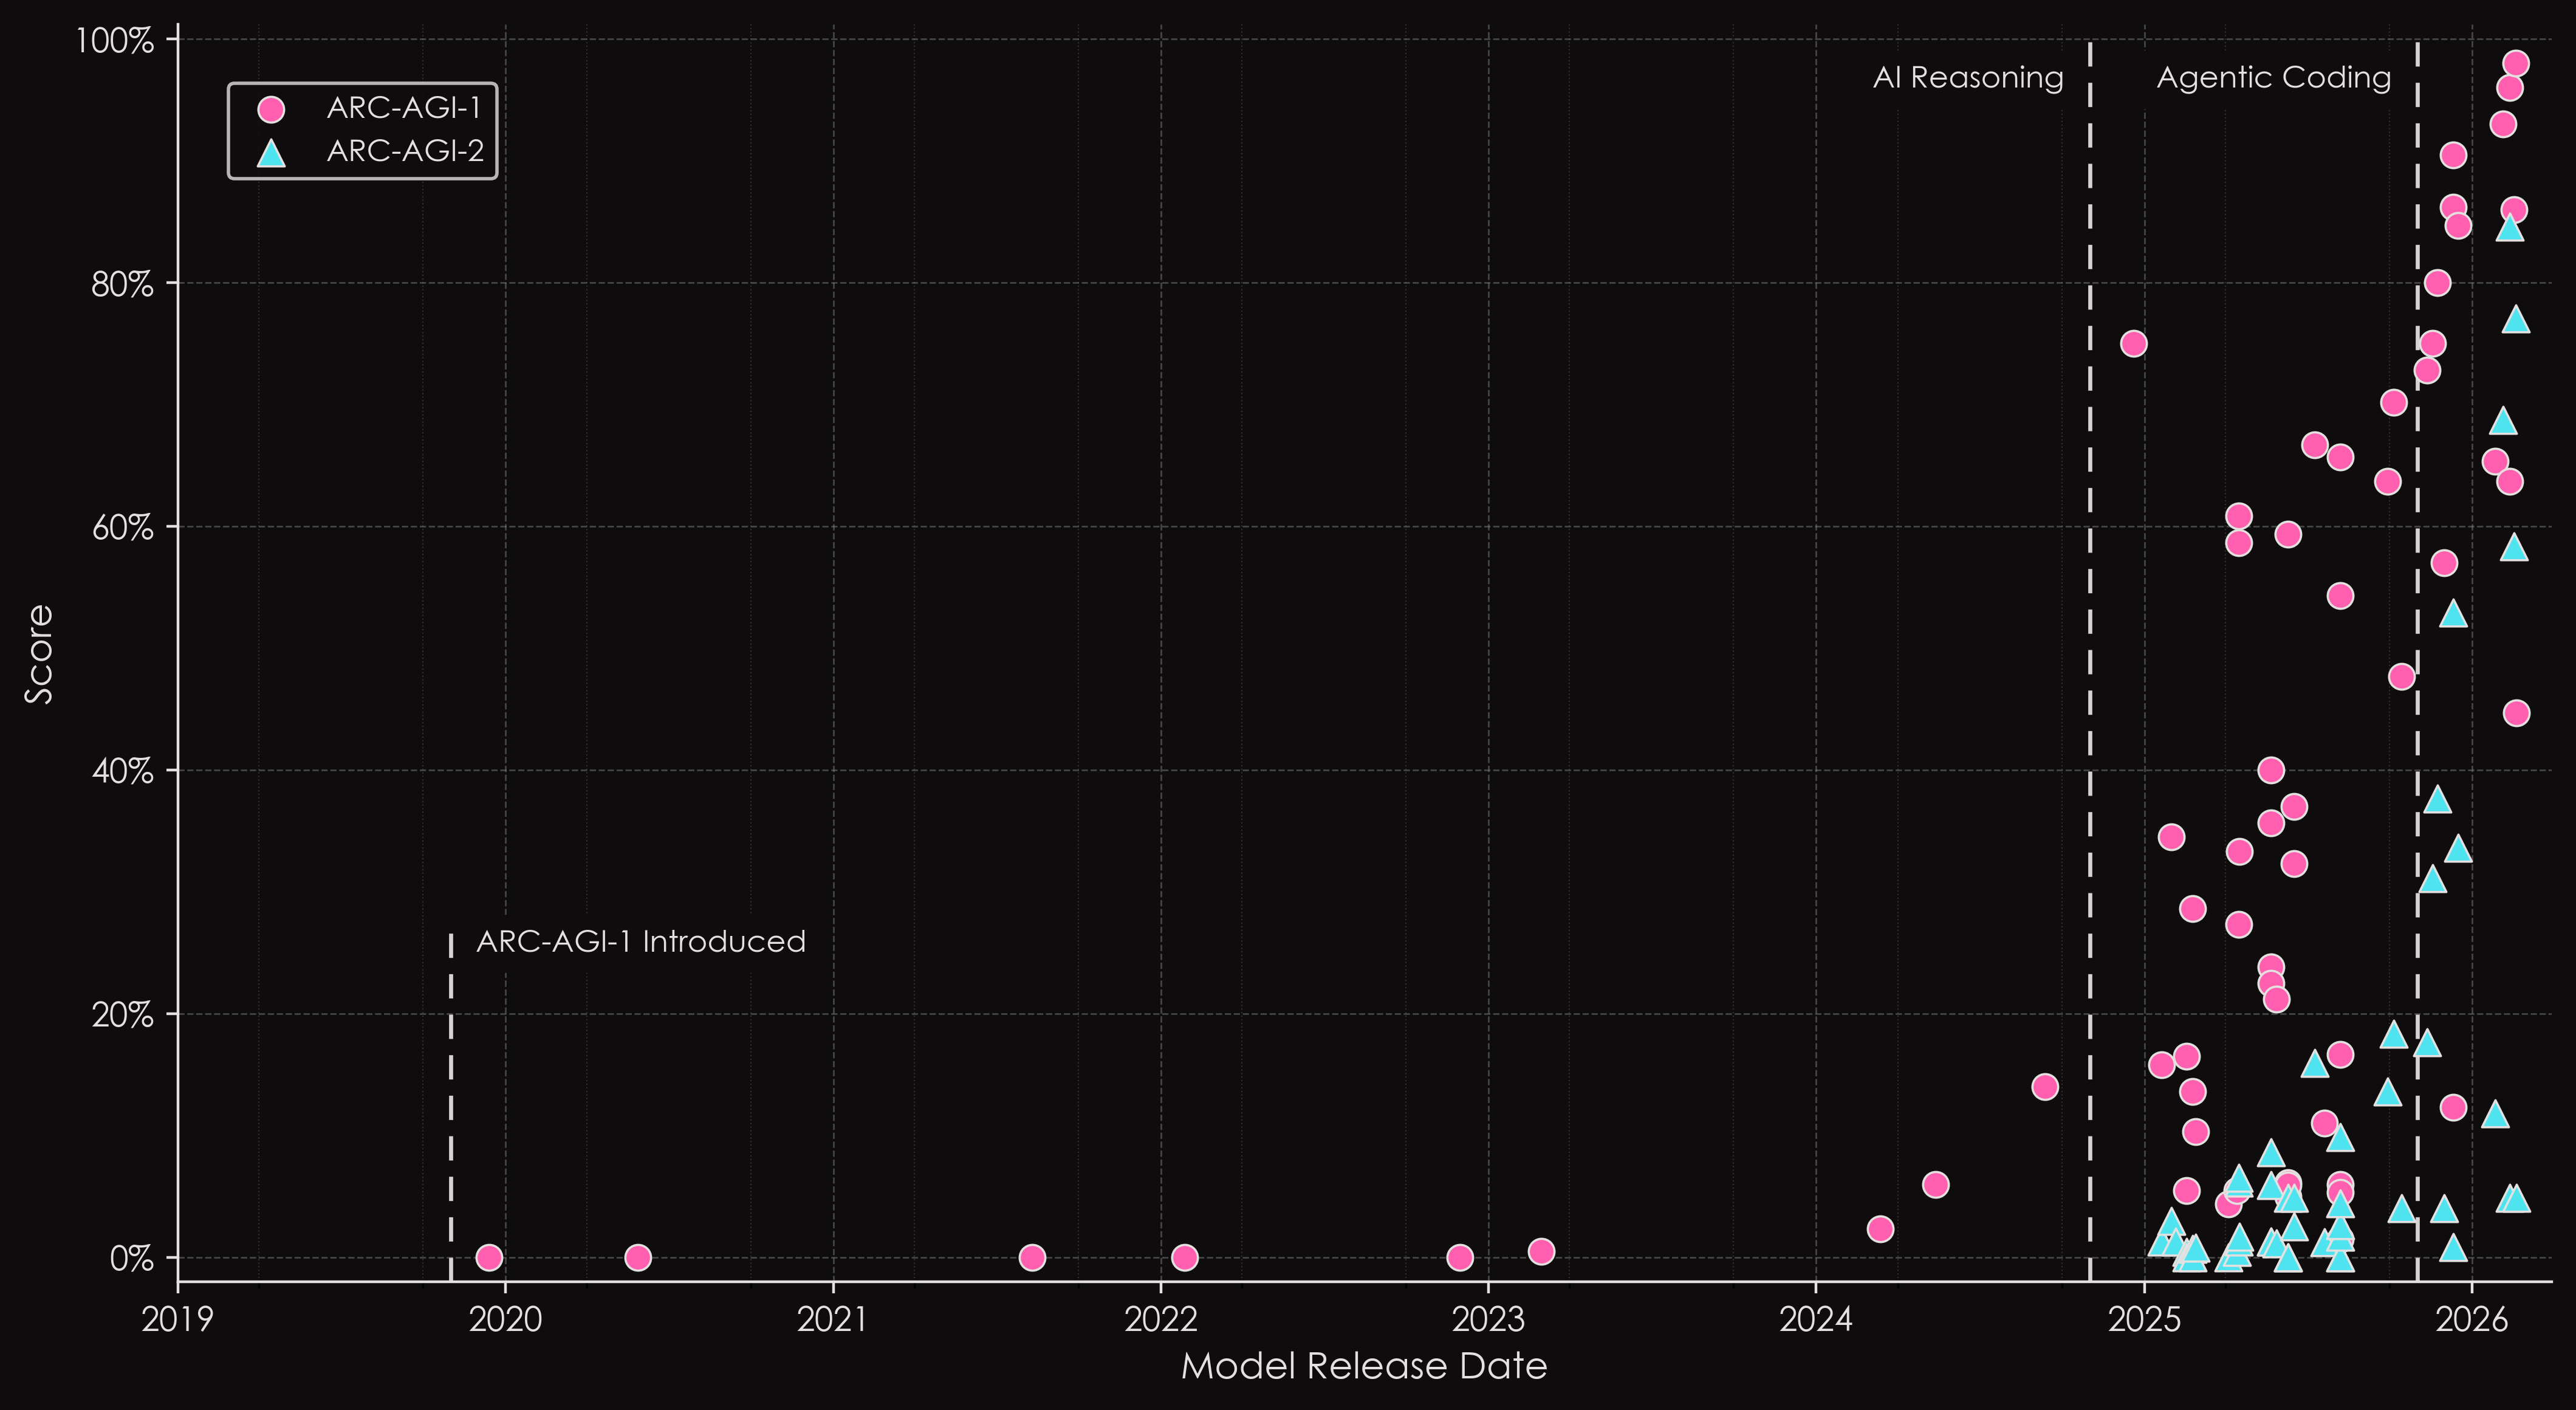
Paradoks benchmarku: Kiedy ten sam model okazuje się trzykrotnie mądrzejszy
29 lipca 2026 roku zespół badawczy OpenAI opublikował raport techniczny zatytułowany „How enabling two settings tripled our scores on the ARC-AGI-3 benchmark”. Publikacja ta wstrząsnęła rynkiem ewaluacji sztucznej inteligencji, dotykając jednego z najbardziej drażliwych tematów we współczesnym AI: wiarygodności publicznych tabel wyników (leaderboards) oraz dramatycznego wpływu tzw. środowiska uruchomieniowego (evaluation harness) na mierzone zdolności modeli.
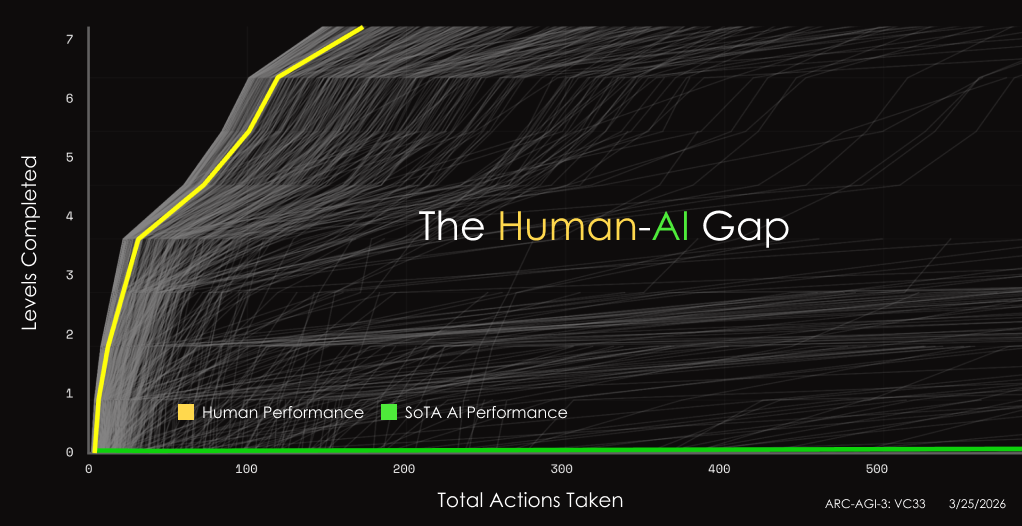
Benchmark ARC-AGI (Abstraction and Reasoning Corpus), stworzony przez François Cholleta i rozwijany przez ARC Prize Foundation, uchodzi za złoty standard pomiaru ogólnej inteligencji maszynowej (AGI). W przeciwieństwie do tradycyjnych testów leksykalnych czy pamięciowych (gdzie modele mogą po prostu cytować dane ze zbioru treningowego), ARC-AGI-3 wymaga interaktywnego eksplorowania środowisk logicznych i rozwiązywania zupełnie unikalnych, abstrakcyjnych łamigłówek, których sieć nigdy wcześniej nie widziała na oczy.
Gdy inżynierowie OpenAI przetestowali swój flagowy model wnioskujący GPT-5.6 Sol na oficjalnym, standardowym skrypcie ewaluacyjnym ARC-AGI-3, model uzyskał skromny wynik 13,3% poprawnie rozwiązanych zadań. Jednak wystarczyło zmienić konfigurację środowiska i włączyć dwa natywne parametry w OpenAI Responses API, by ten sam model na tych samych wagach osiągnął wynik 38,3% – niemal trzykrotnie wyższy – zużywając przy tym 6-krotnie mniej tokenów wyjściowych.
Dwa kluczowe parametry pod lupą: Na czym polega różnica?
Dlaczego oficjalny harness tak drastycznie zaniżał możliwości modelu? Badacze OpenAI zidentyfikowali fundamentalną wadę w sposobie, w jaki większość standardowych benchmarków komunikuje się z agentami przez API:
1. Retained Reasoning (Zachowywanie Ukrytego Ciągu Myślowego)
Standardowy harness ewaluacyjny po każdym wykonanym przez model kroku (np. próbie przekształcenia siatki kolorów) usuwał wygenerowany wcześniej ciąg myślowy (hidden reasoning tokens / chain-of-thought), przesyłając w kolejnym requeście wyłącznie surowy stan planszy i historię tekstową. W rezultacie model cierpiał na cykliczną amnezję: przy każdym kolejnym ruchu musiał od zera dedukować reguły gry, analizować błędy poprzednich prób i rekonstruować swoje robocze hipotezy.
Włączenie parametru Retained Reasoning w nowym Responses API pozwala serwerom OpenAI zachować stan wewnętrzny modelu pomiędzy kolejnymi wywołaniami. Agent „pamięta”, dlaczego podjął daną decyzję w kroku 2, co poszło nie tak w kroku 3 i jaką strategię naprawczą założył w kroku 4. Zamiast kręcić się w kółko, model prowadzi ciągły, kumulatywny proces badawczy.
2. Automatic Context Compaction (Inteligentna Kompresja Zamiast Obcinania)
W długich, wieloetapowych łamigłówkach okno kontekstu szybko się zapełnia. Standardowy skrypt ARC-AGI stosował prostą metodę rolling truncation – gdy brakowało miejsca, bezwzględnie odrzucał najstarsze wiadomości. W ten sposób model tracił kluczowe informacje z fazy początkowej (np. przykłady demonstracyjne definiujące podstawowe transformacje geometryczne).
Ustawienie Compaction zastępuje tę prymitywną metodę semantyczną kompresją. Zamiast wycinać historię, model w locie syntetyzuje dotychczasowe wnioski, redukując setki linijek nieudanych prób do zwięzłego podsumowania reguł. To właśnie ta optymalizacja pozwoliła zredukować liczbę generowanych tokenów aż o rząd wielkości, eliminując powtarzanie tych samych błędów.
Zestawienie wyników: Oficjalny Harness vs OpenAI Adapter
Poniższa tabela przedstawia oficjalne dane opublikowane przez OpenAI w lipcu 2026 roku dla modelu GPT-5.6 Sol:
| Konfiguracja testowa | Retained Reasoning | Zarządzanie kontekstem | Wynik ARC-AGI-3 (Public) | Średnie zużycie tokenów |
|---|---|---|---|---|
| Standardowy Harness (Baseline) | Wyłączone (reset co krok) | Rolling Truncation (obcinanie początku) | 13,3% | ~142 000 tokenów / zadanie |
| Tylko Retained Reasoning | Włączone (ciągłość myśli) | Rolling Truncation | 24,1% | ~98 000 tokenów / zadanie |
| Pełna optymalizacja (OpenAI Settings) | Włączone (ciągłość myśli) | Context Compaction | 38,3% (+25,0 pp) | ~23 500 tokenów / zadanie (6x mniej) |
Wnioski dla branży: Kryzys „Benchmark Hygiene”
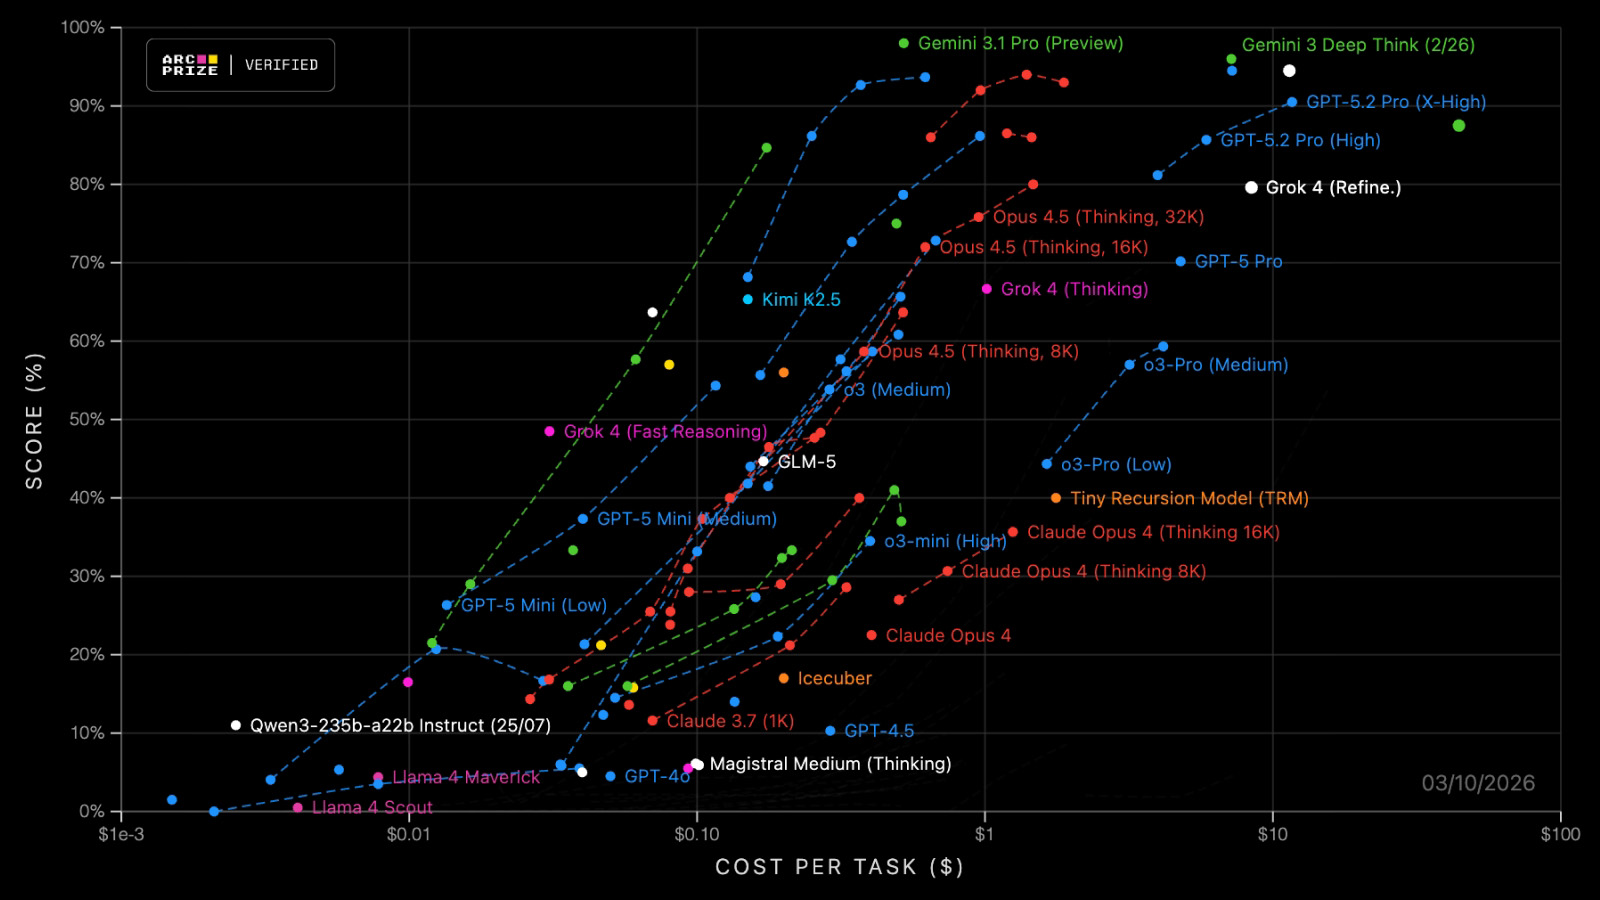
Publikacja OpenAI wywołała gorącą dyskusję na temat tzw. Benchmark Hygiene. Okazuje się bowiem, że porównywanie modeli wyłącznie na podstawie nazwy i surowego wyniku procentowego jest pozbawione sensu naukowego, jeśli nie podaje się dokładnej specyfikacji środowiska uruchomieniowego.
Różnica między 13,3% a 38,3% nie wynika ze zmiany wag sieci ani kosztownego dotrenowania modelu. Wynika wyłącznie z faktu, czy pozwoliliśmy modelowi pamiętać własne myśli z poprzedniej minuty. Dla inżynierów wdrażających rozwiązania agentowe w biznesie płynie stąd kluczowa lekcja: często zamiast wydawać miliony na większe modele, wystarczy poprawnie zaprojektować architekturę pamięci roboczej i kompresji kontekstu w potoku API.
Źródło i oryginalna publikacja naukowa:
Dokument: How enabling two settings tripled our scores on the ARC-AGI-3 benchmark
Instytucja badawcza: OpenAI Technical Research Team
Data publikacji: 29 lipca 2026
Opis: Oficjalny raport inżynieryjny OpenAI analizujący wpływ parametrów Retained Reasoning oraz Context Compaction na wyniki modelu GPT-5.6 Sol w benchmarku ARC-AGI-3.
Bezpośredni odnośnik do publikacji: https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/ →
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.