
Hierarchiczne modele świata World Models i przestrzeń ukryta JEPA: Jak sensoryczna predykcja fizyki i symulacje wideo redefiniują autonomię robotów humanoidalnych i pojazdów nowej ery
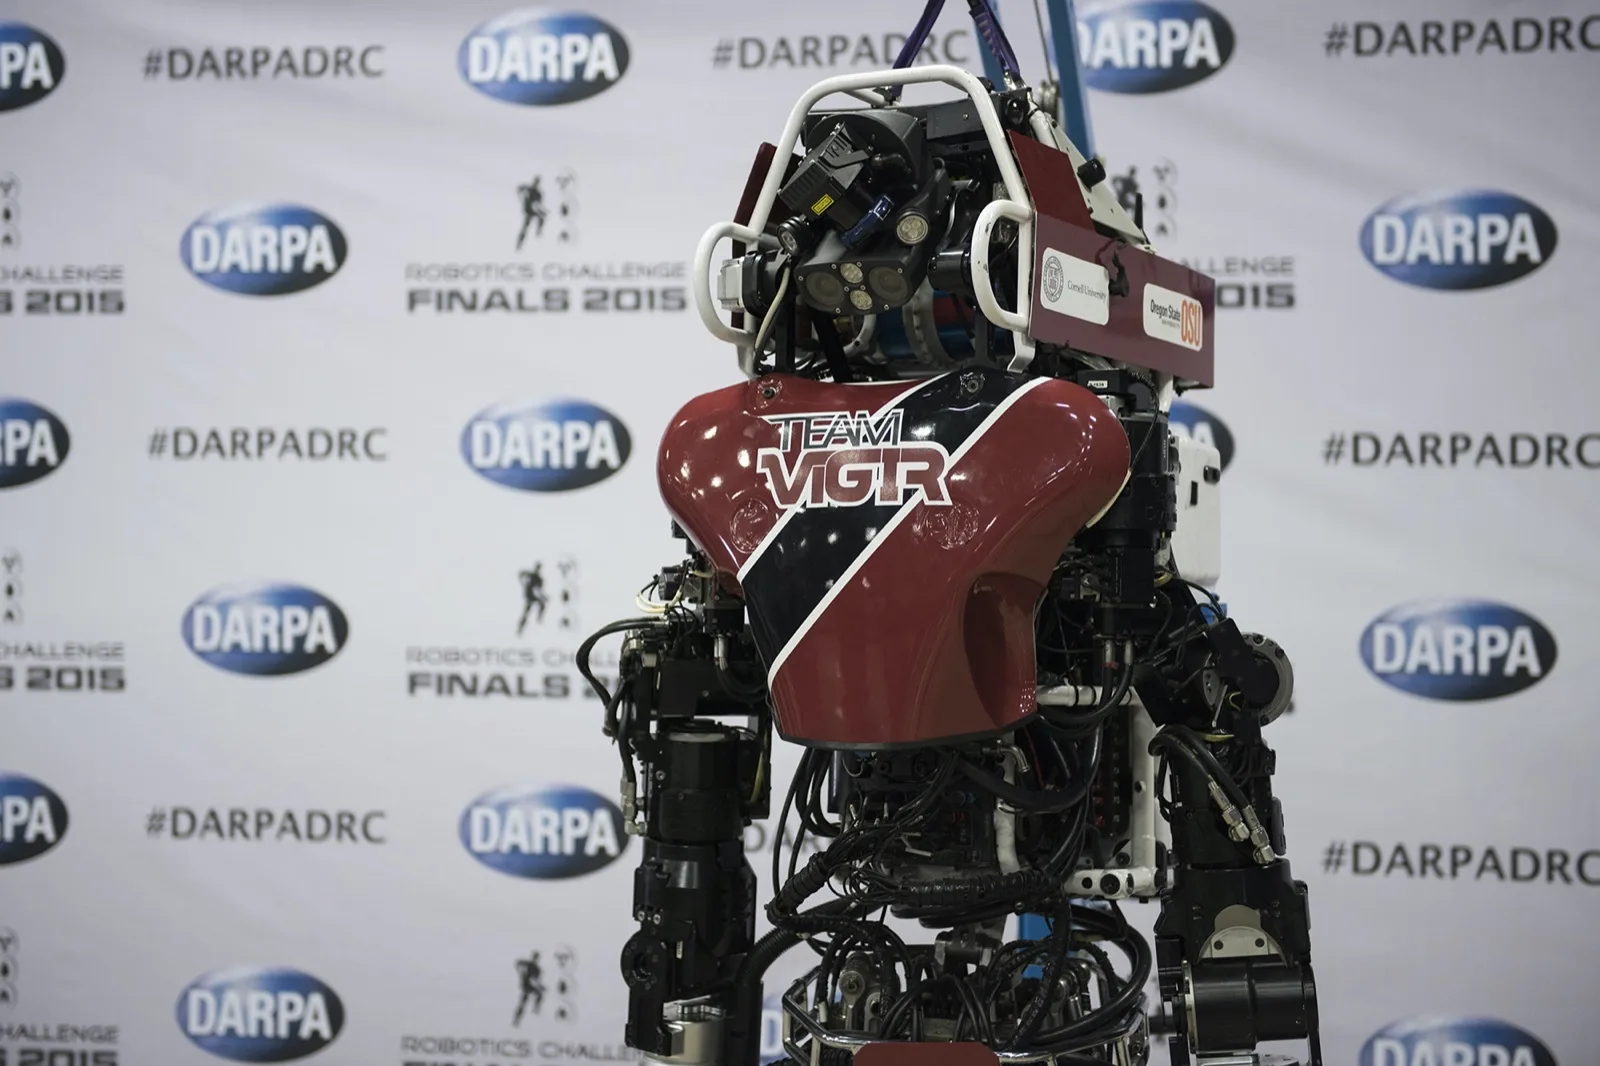
Współczesna sztuczna inteligencja stanęła przed fundamentalną barierą poznawczą, której nie da się sforsować poprzez proste skalowanie parametrów klasycznych wielkich modeli językowych. O ile generowanie tekstu, synteza kodu źródłowego czy manipulacja reprezentacjami symbolicznymi osiągnęły poziom przewyższający ludzkie zdolności w wielu wyspecjalizowanych domenach, o tyle osadzenie inteligencji w fizycznej rzeczywistości ujawniło drastyczny deficyt zdroworozsądkowego rozumienia świata materialnego. Autonomiczne roboty humanoidalne oraz zaawansowane systemy kierowania pojazdami, zmuszone do podejmowania decyzji w ułamkach milisekund pod presją nieodwracalnych praw mechaniki klasycznej, nie mogą polegać na naiwnej autoregresji w przestrzeni dyskretnych tokenów językowych. W odpowiedzi na te strukturalne ograniczenia, wiodące ośrodki badawcze skoncentrowały swoje wysiłki na rozwoju modeli świata, określanych w literaturze anglosaskiej mianem World Models. Koncepcja ta zakłada, że inteligentny agent musi posiadać wewnętrzny, dynamiczny symulator rzeczywistości, zdolny do antycypowania skutków podejmowanych akcji motorowych oraz prognozowania ewolucji otoczenia z wyprzedzeniem wielu kroków czasowych.
Przez lata dominującym podejściem w próbach budowy takich symulatorów było generowanie przewidywanej przyszłości bezpośrednio w przestrzeni pikselowej. Metody oparte na dyfuzji wideo, generatywnych sieciach przeciwstawnych czy autoregresyjnych transformatorach wizyjnych generowały wprawdzie fotorealistyczne sekwencje kadrów, jednakże okazywały się skrajnie nieefektywne obliczeniowo i podatne na fundamentalne błędy fizyczne. Próba zmuszenia sieci neuronowej do przewidywania każdego pojedynczego piksela matrycy aparatu o rozdzielczości czterech milionów punktów prowadzi do zjawiska, w którym model marnuje gigantyczną część swojej pojemności reprezentacyjnej na rekonstrukcję szumu tła, fluktuacji oświetlenia czy przypadkowego ruchu liści na wietrze, zamiast skupić się na niezmiennikach fizycznych, trajektoriach kolizyjnych oraz rozkładzie masy manipulowanych obiektów. To właśnie w tym punkcie nastąpił przełom koncepcyjny pod postacią architektury Joint Embedding Predictive Architecture, znanej powszechnie pod akronimem JEPA. Zaproponowana przez teoretyków uczenia maszynowego architektura porzuca dogmat rekonstrukcji sygnału wejściowego na rzecz przewidywania w abstrakcyjnej przestrzeni cech ukrytych, otwierając zupełnie nowy rozdział w inżynierii systemów autonomicznych.
Rozumienie fizyki świata przez maszynę nie wymaga odtwarzania każdego fotonu odbitego od powierzchni stołu laboratoryjnego czy jezdni autostrady. Kiedy człowiek planuje sięgnięcie po ceramiczny kubek z gorącą kawą, jego kora ruchowa nie renderuje w wyobraźni tekstury porcelany ani mikroskopijnych refleksów światła słonecznego na lakierze naczynia. Zamiast tego ludzki układ nerwowy operuje na zwięzłych, geometryczno-dynamicznych wektorach stanu, kodujących pozycję środka ciężkości, szacowaną masę cieczy, współczynnik tarcia powierzchniowego oraz wymaganą siłę docisku palców niezbędną do zrównoważenia momentu obrotowego. Architektury typu JEPA przenoszą ten biologiczny mechanizm na grunt matematyki uczenia głębokiego. Zamiast mierzyć błąd predykcji jako odchylenie średniokwadratowe w przestrzeni barw RGB, system ten optymalizuje odległość euklidesową lub podobieństwo cosinusowe pomiędzy wektorem reprezentacji stanu przyszłego zakodowanego przez enkoder celu a wektorem wygenerowanym przez moduł predyktora na podstawie stanu obecnego i wektora akcji.
Takie sformułowanie problemu eliminuje konieczność generowania iluzorycznych detali, zmuszając sieć do wyabstrahowania rzeczywistych reguł rządzących otoczeniem. Jeśli robot manipulacyjny uderzy metalowym chwytakiem w drewniany klocek, model JEPA nie musi wiedzieć, jak dokładnie zmieni się układ cieni na podłożu, ale musi bezbłędnie przewidzieć, że wektor położenia klocka w przestrzeni cech przesunie się zgodnie z zasadą zachowania pędu, a klocek nie zapadnie się pod powierzchnię stołu ani nie zdematerializuje. To przejście od generacji pikselowej do geometrycznej predykcji w przestrzeni ukrytej stanowi fundament, na którym wznoszona jest współczesna autonomia fizyczna, od wielozadaniowych robotów pracujących w fabrykach motoryzacyjnych po pojazdy autonomiczne poruszające się w gęstym ruchu miejskim w warunkach ograniczonej widoczności.
Od przestrzeni pikseli do przestrzeni cech: Matematyczne fundamenty architektury JEPA
Aby zrozumieć skalę przewagi architektury JEPA nad tradycyjnymi modelami generatywnymi, należy poddać szczegółowej analizie aparat matematyczny rządzący jej procesem optymalizacyjnym. W klasycznym podejściu generatywnym, opartym na autoenkoderach maskowanych lub modelach dyfuzyjnych, zadanie polega na minimalizacji funkcji straty będącej miarą błędu rekonstrukcji surowego sygnału sensorycznego. Oznacza to, że funkcja kosztu karze model w równym stopniu za błędne przewidzenie przesunięcia pieszych wkraczających na pasy, jak i za nieprawidłowe odtworzenie struktury kropel deszczu na przedniej szybie kamery samochodowej. W warunkach rzeczywistych zjawiska deterministyczne mieszają się z procesami stochastycznymi o wysokiej entropii, których z natury nie da się przewidzieć w sposób deterministyczny. Wymuszanie predykcji każdego piksela w środowisku o wysokiej niepewności prowadzi do zjawiska uśredniania rozkładu prawdopodobieństwa, co w praktyce objawia się generowaniem rozmytych, niefizycznych obrazów lub halucynacjami, które w sterowaniu robotem prowadzą do katastrofalnych w skutkach decyzji.
Architektura JEPA rozwiązuje ten problem poprzez zastosowanie dwóch sprzężonych enkoderów, z których jeden przetwarza bieżący stan sensoryczny, a drugi, często aktualizowany za pomocą mechanizmu wykładniczej średniej kroczącej wag, generuje reprezentację docelową stanu przyszłego. Pomiędzy nimi znajduje się właściwy predyktor, którego zadaniem jest przekształcenie wektora reprezentacji obecnej, zasilonego wektorem planowanej akcji lub wektorem zmiennych ukrytych, w wektor przewidywanej reprezentacji przyszłej. Ponieważ enkoder celu nie jest optymalizowany bezpośrednio przez spadek wzdłuż gradientu funkcji straty, lecz czerpie wagi z enkodera kontekstu za pośrednictwem powolnej aktualizacji parametrów, zapobiega to zjawisku zapadania się reprezentacji, określanemu w teorii uczenia samonadzorowanego jako representation collapse, w którym sieć mapuje wszystkie stany wejściowe do jednego, trywialnego punktu w przestrzeni latentnej.
Kluczowym elementem tej architektury jest również to, że funkcja straty mierzona jest wyłącznie w przestrzeni ukrytej za pomocą zrównoważonych metryk odległości. Dzięki temu enkoder ma pełną swobodę odrzucania informacji o wysokiej entropii i niskiej wartości semantycznej. Szum matrycy, drgania zawieszenia robota czy turbulencje powietrza są naturalnie odfiltrowywane, ponieważ nie posiadają korelacji ze stanami długoterminowymi ani z wpływem akcji podejmowanych przez efektory robota. W rezultacie w przestrzeni ukrytej powstaje gładka rozmaitość topologiczna, na której operacje planowania trajektorii i unikania przeszkód stają się problemami optymalizacyjnymi o relatywnie niskiej złożoności obliczeniowej. Zamiast przeszukiwać nieskończenie wymiarową przestrzeń konfiguracji pikseli, algorytmy planowania mogą wykonywać symulacje kinetyczne bezpośrednio w przestrzeni cech o wymiarze kilkuset lub kilku tysięcy wymiarów, co redukuje narzut obliczeniowy o wiele rzędów wielkości.
Rozwinięciem tej koncepcji na poziom zaawansowanych systemów kognitywnych jest hierarchiczna architektura H-JEPA. W świecie fizycznym procesy decyzyjne zachodzą bowiem na skrajnie zróżnicowanych poziomach abstrakcji czasowej i przestrzennej. Manipulacja precyzyjnym narzędziem wymaga mikrosekundowej kontroli siły nacisku i kompensacji drgań na poziomie stawów palców, podczas gdy zadanie polegające na zmontowaniu silnika spalinowego wymaga planowania strategicznego w horyzoncie dziesiątek minut. H-JEPA realizuje tę hierarchię poprzez kaskadowe połączenie kilku modułów predykcyjnych o rosnącej skali czasowej. Dolne poziomy hierarchii przetwarzają sygnały sensoryczne o wysokiej częstotliwości próbkowania, przewidując natychmiastowe reakcje biomechaniczne i zmiany wektorów sił, podczas gdy wyższe poziomy operują na mocno skompresowanych reprezentacjach semantycznych, prognozując globalny postęp zadania i planując sekwencje makro-akcji bez konieczności zagłębiania się w techniczne detale ich natychmiastowej realizacji.
Hierarchiczne planowanie i symulacja mentalna: Architektura H-JEPA w działaniu
Praktyczna implementacja hierarchicznych modeli świata w robotach autonomicznych wymusiła całkowitą rekonfigurację tradycyjnych pętli sterowania. Dotychczasowy paradygmat opierał się na rozbiciu problemu na sztywne, odizolowane bloki: percepcję realizowaną przez algorytmy detekcji obiektów i estymacji ich położenia, lokalizację i jednoczesne mapowanie otoczenia, dedykowany moduł planowania trajektorii operujący na siatkach zajętości oraz niskopoziomowy kontroler regulatora proporcjonalno-całkująco-różniczkującego. Taka modularna struktura generowała gigantyczne opóźnienia komunikacyjne, a błędy estymacji na etapie percepcji kumulowały się kaskadowo, doprowadzając do zjawiska paraliżu decyzyjnego w sytuacjach nietypowych, które wykraczały poza reguły zdefiniowane przez programistów.
W architekturze zintegrowanej z modelem H-JEPA percepcja i planowanie stają się dwiema stronami tego samego procesu wnioskowania. Robot wyposażony w taki model nie traktuje napływającego strumienia danych z kamer wizyjnych, sensorów dotykowych i jednostek inercyjnych jako statycznych obrazów do sklasyfikowania, lecz jako ciągłą falę informacji korygującą jego wewnętrzną symulację stanu świata. Mechanizm ten jest bezpośrednim odpowiednikiem koncepcji kodowania predykcyjnego z zakresu neurobiologii obliczeniowej. Mózg syntetyczny robota bezustannie generuje hipotezy dotyczące przyszłego stanu swoich sensorów. Dopóki napływające bodźce zgadzają się z prognozą wygenerowaną przez model świata, sygnał błędu pozostaje bliski zeru, a obliczenia przebiegają bez angażowania zasobów najwyższych poziomów kognitywnych. Dopiero pojawienie się anomalii, na przykład nagłe poślizgnięcie stopy robota na mokrej nawierzchni lub niespodziewane wtargnięcie przeszkody na tor ruchu, wywołuje gwałtowny wzrost błędu predykcji w przestrzeni ukrytej, co wymusza natychmiastową rekonfigurację planu działania.
Symulacja mentalna w przestrzeni ukrytej umożliwia realizację mechanizmu Model Predictive Control na niespotykaną dotąd skalę. Robot, stojąc przed koniecznością wykonania skomplikowanego manewru dynamicznego, takiego jak pokonanie rumowiska skalnego czy dynamiczne przeskoczenie nad szczeliną, nie musi testować potencjalnie niszczycielskich wariantów ruchowych w fizycznej rzeczywistości. Zamiast tego moduł optymalizacji trajektorii generuje setki wirtualnych sekwencji sterowań silnikami bezszczotkowymi i przepuszcza je przez predyktor przestrzeni ukrytej. Każda sekwencja akcji powoduje przesunięcie wektora stanu w przestrzeni cech wzdłuż przewidywanej trajektorii czasowej. Algorytm ocenia końcowy wektor stanu za pomocą funkcji wartości, weryfikując, czy dany stan gwarantuje zachowanie równowagi statycznej i dynamicznej, uniknięcie przekroczenia dopuszczalnych momentów sił w przekładniach harmonicznych oraz bezpieczne osiągnięcie celu geometrycznego. Ponieważ operacje te odbywają się w przestrzeni wektorowej o niskim wymiarze przy użyciu zrównoleglonych rdzeni tensorowych nowoczesnych akceleratorów obliczeniowych, ocena tysiąca alternatywnych ścieżek motorycznych zajmuje zaledwie kilkanaście milisekund.
Niezwykle istotnym aspektem tej architektury jest jej zdolność do generalizacji na sytuacje out-of-distribution, z którymi tradycyjne sieci neuronowe radzą sobie fatalnie. Uczenie przez naśladownictwo oparte na klonowaniu zachowań człowieka zawodzi w momencie, gdy robot znajdzie się w konfiguracji przestrzennej nieobecnej w zbiorze treningowym. Model świata oparty na JEPA, posiadając wyuczone niezmienniki fizyczne, potrafi ekstrapolować skutki akcji nawet w zupełnie nowym otoczeniu. Jeśli robot humanoidalny nauczył się mechaniki podnoszenia paczek w magazynie logistycznym, a następnie zostanie przetransportowany na teren budowy, jego wewnętrzny model fizyki natychmiast zidentyfikuje worki z zaprawą murarską jako obiekty odkształcalne o wysokiej gęstości, dostosowując dynamikę chwytu i pozycję środka ciężkości całego korpusu bez konieczności ponownego zbierania milionów demonstracji.
Integracja multimodalna: Fuzja kamer, lidarów i propriocepcji w jednolitą reprezentację latentną
Kluczowym wyzwaniem inżynieryjnym w budowie współczesnych robotów humanoidalnych i pojazdów autonomicznych jest bezszwowa integracja skrajnie heterogenicznych źródeł sensorycznych. Platforma autonomiczna operująca w rzeczywistym świecie dysponuje zazwyczaj zestawem kamer stereowizyjnych o wysokim zakresie dynamicznym, wielowiązkowymi sensorami lidarowymi generującymi gęste chmury punktów w układzie współrzędnych sferycznych, radarami mikrofalowymi zdolnymi do penetracji mgły i opadów deszczu, a także gęstą siecią czujników wewnętrznych. Te ostatnie obejmują precyzyjne enkodery magnetyczne w każdym stawie robota, tensometryczne czujniki sił i momentów w stopach i dłoniach, sensory dotykowe oparte na elastycznych matrycach piezorezystancyjnych oraz jednostki inercyjne rejestrujące przyspieszenia kątowe i liniowe korpusu z częstotliwością przekraczającą tysiąc herców.
Tradycyjne podejścia inżynieryjne próbowały dokonywać wczesnej lub późnej fuzji danych na poziomie surowych pomiarów. Wczesna fuzja wymagała rzutowania punktów lidaru na płaszczyznę obrazu kamery, co generowało potężne artefakty w przypadku niedoskonałej kalibracji geometrycznej lub różnic w opóźnieniach czasowych migawek elektronicznych. Z kolei późna fuzja, operująca na niezależnie wyekstrahowanych obiektach 3D, prowadziła do bezpowrotnej utraty subtelnych korelacji krzyżowych, takich jak wyczuwanie mikrodrgań podłoża za pomocą czujników stóp w momencie, gdy kamera rejestruje wjechanie na nawierzchnię szutrową. W modelach świata nowej generacji integracja multimodalna realizowana jest wprost w przestrzeni cech ukrytych za pośrednictwem wyspecjalizowanych transformatorów fuzji percepcyjnej.
W tej architekturze każdy strumień sensoryczny posiada swój dedykowany enkoder wstępny, dostosowany do specyfiki czasowo-przestrzennej danego sygnału. Obrazy wizyjne przetwarzane są przez transformatory wizyjne z mechanizmem uwagi o zmiennym oknie czasowym, chmury punktów lidaru trafiają do struktur opartych na sieciach grafowych lub reprezentacjach wokselowych, natomiast jednowymiarowe szeregi czasowe z propriocepcji i sensorów inercyjnych kodowane są przez warstwy splotowe o rozszerzonym polu recepcyjnym. Wyjściowe wektory z poszczególnych modalności rzutowane są do wspólnej, bezwymiarowej przestrzeni latentnej za pomocą zbalansowanych projektorów liniowych. Następnie głębokie warstwy mechanizmu cross-attention dokonują dynamicznego przeważania wag poszczególnych sensorów w zależności od ich bieżącej wiarygodności i poziomu zakłóceń.
W praktyce oznacza to, że gdy robot wchodzi do zaciemnionego pomieszczenia, w którym kamery wizyjne generują wyłącznie czarny obraz zdominowany przez szum termiczny matrycy krzemowej, model nie doznaje załamania percepcyjnego. Mechanizm uwagi automatycznie wygasza wagi wektorów pochodzących z enkodera optycznego, a przestrzeń ukryta jest niemal w całości podtrzymywana przez dane z lidaru, sonary zbliżeniowe oraz informację dotykową z chwytaków badających otoczenie. Co więcej, model świata potrafi wykorzystać propriocepcję do kalibracji własnych zmysłów wzrokowych. Ruch własnej ręki robota w polu widzenia kamery staje się darmowym, w pełni nadzorowanym sygnałem treningowym, pozwalającym na ciągłą estymację geometrii układu optycznego i eliminację dryfu kalibracyjnego wywołanego zmianami temperatury konstrukcji mechanicznej.
Ta multimodalna spójność jest również fundamentem bezpiecznej jazdy autonomicznej w ekstremalnych scenariuszach drogowych. Pojazd autonomiczny zbliżający się do zakrętu zasłoniętego przez gęstą ścianę lasu nie może polegać na naiwnej interpolacji linii pasów ruchu. Model świata zasilany danymi radarowymi, mapami topograficznymi wysokiej rozdzielczości oraz akustycznymi sygnałami odbitymi od barier energochłonnych potrafi wygenerować w przestrzeni ukrytej predykcję trajektorii niewidocznego jeszcze pojazdu nadjeżdżającego z naprzeciwka, przygotowując układ hamulcowy i optymalizując profil prędkości jeszcze przed wejściem w strefę bezpośredniego kontaktu wzrokowego.
Uczenie fizyki i wnioskowanie przyczynowo-skutkowe bez nadzoru człowieka
Prawdziwa rewolucja, jaką niosą ze sobą modele świata, tkwi w ich zdolności do przyswajania intuicyjnej fizyki na drodze całkowicie autonomicznej eksploracji środowiska. Przez dekady inżynierowie robotyki zmuszeni byli do ręcznego modelowania praw dynamiki bryły sztywnej za pomocą równań Newtona-Eulera lub formalizmu Lagrange'a. Choć równania te są matematycznie ścisłe, ich aplikacja w dynamicznie zmieniającym się świecie rzeczywistym napotyka nieprzekraczalne bariery. Niemożliwe jest precyzyjne zamodelowanie analityczne zachowania cieczy wylewającej się z naczynia, plastycznego odkształcania ubrań składanych przez robota domowego, czy skomplikowanych sił tarcia kontaktowego na granicy zużytej opony i zanieczyszczonej nawierzchni asfaltowej.
Hierarchiczne modele świata uczą się tych zjawisk dokładnie tak, jak robi to ludzkie dziecko w pierwszych miesiącach życia: poprzez fizyczną zabawę i interakcję z otoczeniem. Robot humanoidalny wyposażony w moduł uczenia napędzanego ciekawością, w którym wewnętrzną funkcją nagrody jest maksymalizacja błędu predykcji modelu świata, podejmuje spontaniczne próby manipulacji przedmiotami. Robot popycha kubek, upuszcza gumową piłkę, zgniata kartonowe pudełko czy przesuwa ciężki metalowy element po chropowatym stole. Każda taka akcja generuje parę złożoną z początkowego stanu sensorycznego, wektora siły przyłożonej przez siłowniki oraz wynikowego stanu końcowego. Model JEPA optymalizuje swoje parametry tak, aby minimalizować rozbieżność między swoim wyobrażeniem w przestrzeni cech a fizycznym rezultatem zdarzenia.
W toku setek tysięcy takich interakcji, prowadzonych równolegle na dziesiątkach fizycznych robotów połączonych chmurą obliczeniową oraz w wysoce realistycznych symulatorach fizycznych wspieranych akceleracją GPU, w wagach sieci neuronowej krystalizują się elementarne zasady mechaniki. Model bez żadnego nadzoru człowieka odkrywa zasadę grawitacji, zjawisko nieprzenikalności ciał stałych, prawa tarcia statycznego i kinetycznego oraz właściwości materiałów sprężystych i plastycznych. Co najbardziej fascynujące, reprezentacja ta ma charakter przyczynowo-skutkowy, a nie korelacyjny. Model nie tylko wie, że po naciśnięciu włącznika światła w pokoju zrobi się jasno, ale rozumie łańcuch przyczynowy łączący ruch jego własnego palca, opór sprężyny przełącznika, zamknięcie obwodu elektrycznego i emisję fotonów przez źródło światła.
Taka struktura wiedzy eliminuje zjawisko podatności na ataki adwersarialne i fałszywe korelacje, które paraliżują tradycyjne sieci konwolucyjne. Jeśli klasyfikator obrazów widzi zdjęcie psa z domalowanym w rogu żółtym trójkątem i przez to myli go z autobusem szkolnym, dzieje się tak dlatego, że model nie rozumie struktury obiektu 3D. Model świata, widząc ten sam zmanipulowany bodziec, rzutuje go na trójwymiarową reprezentację bryły zwierzęcia posiadającej określoną masę, mięśnie i szkielet. Drobna anomalia na poziomie tekstury zostaje odrzucona w przestrzeni ukrytej jako nieistotna dla dynamiki obiektu, co gwarantuje niespotykaną dotąd odporność i niezawodność systemów autonomicznych w warunkach polowych.
Architektury sprzętowe nowej generacji: Krzem dedykowany do inferencji modeli świata
Przejście na paradygmat modeli świata pociąga za sobą radykalne zmiany w architekturze mikroprocesorów montowanych na pokładach robotów i pojazdów. Dotychczasowy sprzęt obliczeniowy, optymalizowany pod kątem klasycznych sieci splotowych lub jednokierunkowych transformatorów językowych, okazuje się wysoce suboptymalny w obsłudze dynamicznych, hierarchicznych pętli predykcyjnych. Inferencja modelu świata wymaga jednoczesnego wykonywania trzech skrajnie różnych typów obliczeń: asynchronicznego kodowania sygnałów sensorycznych o wysokiej przepustowości, wysoce zrównoleglonej symulacji setek alternatywnych trajektorii w przestrzeni ukrytej oraz ultraniskolatencyjnego sterowania siłownikami w pętli twardego czasu rzeczywistego o częstotliwości jednego kiloherca.
Wiodący producenci półprzewodników projektują obecnie wyspecjalizowane układy scalone System-on-Chip, w których tradycyjne rdzenie CPU i GPU zostały zintegrowane z wyspecjalizowanymi matrycami obliczeń macierzowych nowej generacji. Kluczową innowacją jest implementacja pamięci o skrajnie wysokiej przepustowości bezpośrednio na strukturze krzemowej w technologii trójwymiarowego łączenia warstw krzemu. Tradycyjne przesyłanie wielowymiarowych wektorów stanu między zewnętrzną pamięcią RAM a procesorem generowało wąskie gardło energetyczne i opóźnienia rzędu mikrosekund, uniemożliwiając symulację mentalną w czasie rzeczywistym. Nowe procesory utrzymują całą przestrzeń ukrytą modelu świata w ultraszybkiej pamięci podręcznej SRAM o pojemności setek megabajtów, co pozwala na generowanie kolejnych kroków predykcji bez opuszczania rdzenia obliczeniowego.
Co więcej, coraz powszechniejsze staje się wykorzystanie arytmetyki niskiej precyzji, w tym formatów zmiennoprzecinkowych FP8 oraz wyspecjalizowanych mikroskopijnych formatów MXFP6 i MXFP4. Ponieważ predykcja w przestrzeni ukrytej JEPA nie wymaga odtwarzania precyzyjnych wartości pikseli, lecz zależy od zachowania relacji topologicznych i geometrycznych między wektorami, badania empiryczne wykazały, że obniżenie precyzji do formatu ośmiobitowego nie powoduje żadnej degradacji zdolności planistycznych robota. Pozwala to na czterokrotne zwiększenie gęstości operacji na jednostkę powierzchni krzemu oraz radykalne obniżenie poboru mocy całego komputera pokładowego, co w przypadku robotów humanoidalnych zasilanych z pakietów bateryjnych ma kluczowe znaczenie dla wydłużenia czasu pracy operacyjnej na jednym ładowaniu z dwóch do ponad ośmiu godzin.
Równolegle rozwija się architektura akceleratorów neuromorficznych i asynchronicznych matryc obliczeniowych, które doskonale współpracują z sensorami wizyjnymi rejestrującymi zmiany zdarzeniowe. Sensory te, zamiast rejestrować pełne klatki obrazu w stałych odstępach czasu, wysyłają sygnały wyłącznie wtedy, gdy jasność w danym pikselu ulegnie zmianie o określony próg. Połączenie sensorów zdarzeniowych z asynchronicznym procesorem neuronowym pozwala na aktualizację przestrzeni ukrytej modelu świata w czasie poniżej stu mikrosekund od momentu wystąpienia ruchu w polu widzenia, co zapewnia robotom humanoidalnym refleks przewyższający biologiczne możliwości układu nerwowego człowieka.
Wpływ na autonomię przemysłową, logistykę i pojazdy autonomiczne
Praktyczne wdrożenie hierarchicznych modeli świata w skali przemysłowej redefiniuje globalne łańcuchy dostaw, automatyzację magazynową oraz sektor transportowy. Pierwszym obszarem, w którym technologia ta przynosi spektakularne rezultaty, są roboty humanoidalne wdrażane w zakładach produkcyjnych przemysłu motoryzacyjnego i elektronicznego. Dotychczasowe roboty przemysłowe wymagały instalacji w odgrodzonych klatkach bezpieczeństwa, a każda zmiana geometrii montowanego komponentu wymuszała wielotygodniowe przeprogramowywanie trajektorii przez wykwalifikowanych inżynierów automatyków. Roboty wyposażone w modele świata operują bezpośrednio u boku ludzi, płynnie adaptując się do zmian oświetlenia, przesunięć palet z częściami czy niespodziewanych zachowań pracowników montażowych.
Robot manipulujący elastyczną wiązką przewodów elektrycznych wewnątrz karoserii samochodu wykorzystuje swój model świata do ciągłego przewidywania odkształceń kabli pod wpływem naprężeń sprężystych. Zamiast sztywnego podążania za zadaną trajektorią, robot na bieżąco koryguje tor ruchu dłoni tak, aby naprowadzić wtyczkę na gniazdo montażowe z uwzględnieniem elastyczności materiału i oporu styków. Jeśli wtyczka napotka nieprzewidzianą przeszkodę, model świata natychmiast analizuje przyczynę w przestrzeni ukrytej, wykonuje minimalne cofnięcie efektora, obraca element o kilka stopni i dokonuje udanego zatrzaśnięcia złącza, eliminując potrzebę interwencji człowieka i drastycznie redukując przestoje na liniach montażowych.
W sektorze pojazdów autonomicznych modele świata eliminują najpoważniejszy mankament dotychczasowych systemów autonomii poziomu czwartego, jakim była niezdolność do radzenia sobie z tak zwanymi zdarzeniami rzadkimi i nieprzewidywalnymi, określanymi w inżynierii jako edge cases. Klasyczne algorytmy, uczone na miliardach kilometrów standardowej jazdy autostradowej, wpadały w panikę w obliczu nietypowych sytuacji, takich jak pęknięcie opony w ciężarówce jadącej sąsiednim pasem, przewrócenie się ładunku z deskami na jezdnię czy nagłe załamanie pogody połączone z gołoledzią. Pojazd wyposażony w model świata JEPA nie musi widzieć wcześniej identycznego zdarzenia w zbiorze treningowym. Jego wewnętrzny symulator natychmiast przewiduje kaskadowy rozwój sytuacji: fizykę rozpadu ładunku, trajektorię koziołkujących desek oraz drastyczny spadek współczynnika przyczepności podłoża, generując bezpieczny manewr ominięcia z optymalnym wykorzystaniem pobocza i stabilizacji toru jazdy.
Docelowo modele świata staną się fundamentem ogólnej inteligencji fizycznej, określanej mianem Artificial Physical Intelligence. Urządzenia te nie będą już zamkniętymi automatami wykonującymi ściśle zdefiniowane procedury, lecz autonomicznymi podmiotami kognitywnymi, zdolnymi do twórczego rozwiązywania problemów technicznych, naprawy uszkodzonej infrastruktury, prowadzenia prac poszukiwawczo-ratowniczych w strefach katastrof naturalnych oraz budowy baz na powierzchni Księżyca i Marsa. Przejście od pasywnej percepcji do aktywnej, hierarchicznej predykcji w przestrzeni cech ukrytych okazuje się nie tylko najefektywniejszą drogą do zbudowania bezpiecznych maszyn, ale również kluczem do zrozumienia samej natury inteligencji osadzonej w fizycznym wszechświecie.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.