
Generowanie wideo w czasie rzeczywistym i interaktywny neural rendering: Jak architektury Diffusion Transformers, autoregresyjne tokeny czasoprzestrzenne i Diffusion Forcing zastępują klasyczne silniki graficzne
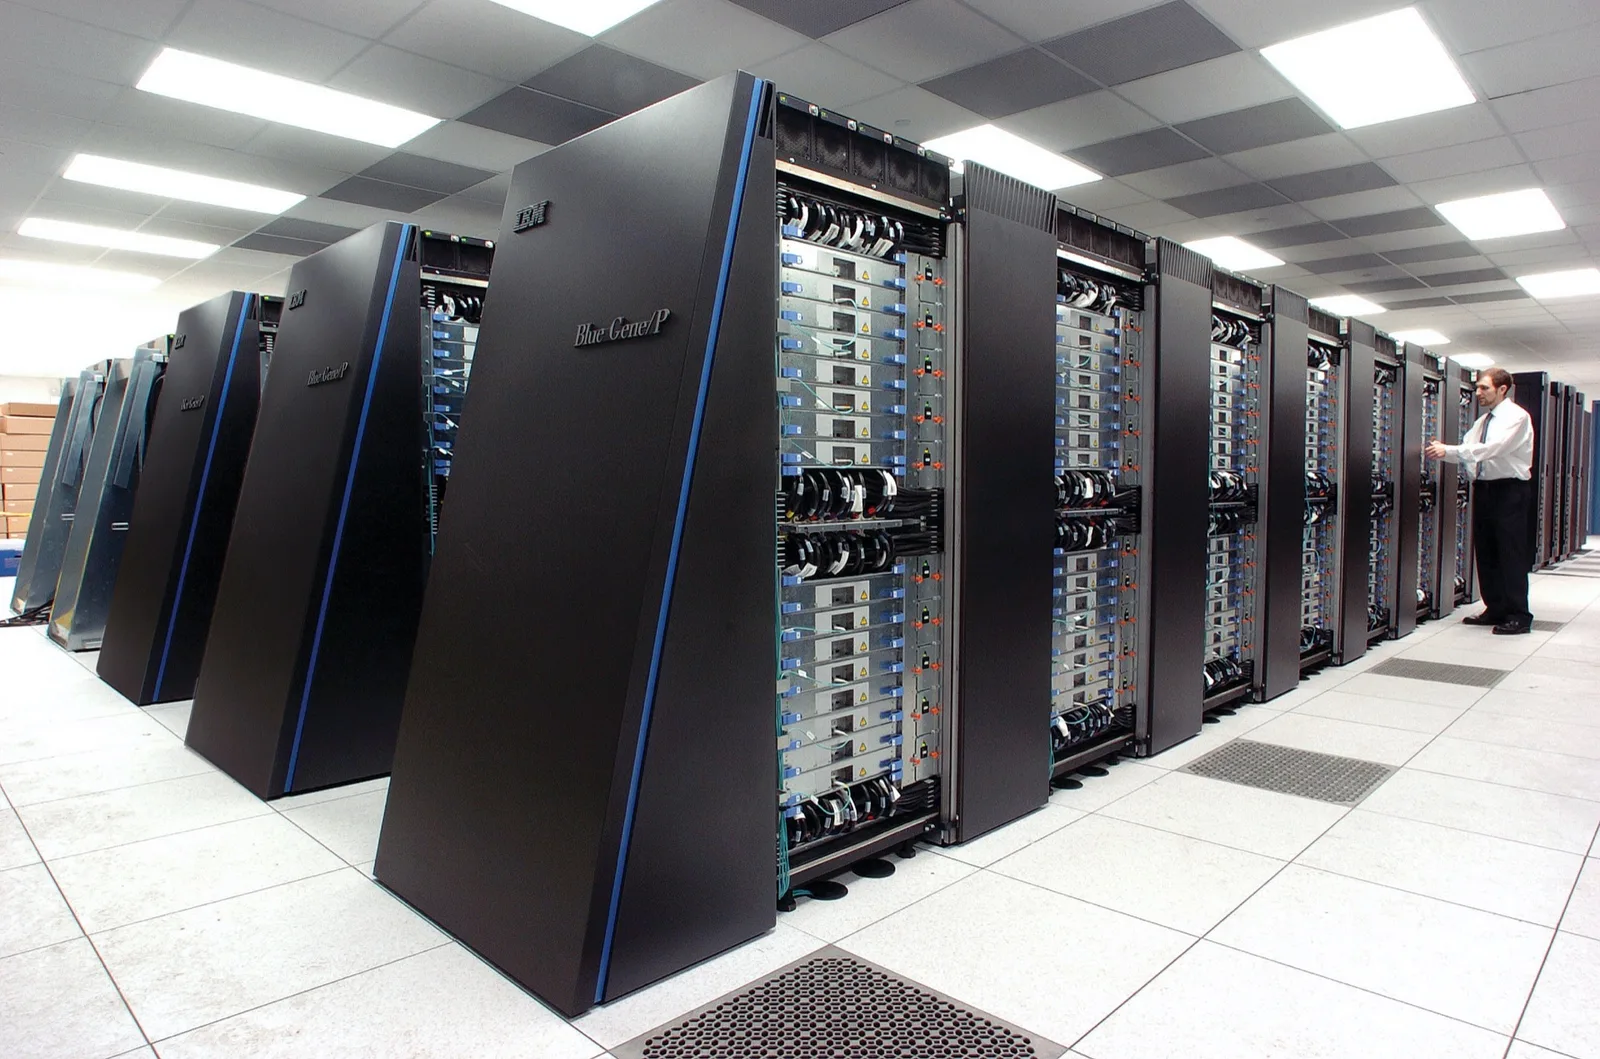
Zmierzch klasycznego potoku graficznego i kres geometrii wektorowej
Przez ponad cztery dekady fundamentem grafiki komputerowej w czasie rzeczywistym pozostawał paradygmat oparty na euklidesowej geometrii, siatkach wielokątów oraz deterministycznym potoku renderowania. Od pierwszych prymitywnych akceleratorów trójwymiarowych po najbardziej zaawansowane współczesne jednostki GPU przetwarzające miliardy trójkątów na sekundę, cały ekosystem cyfrowej symulacji wizualnej opierał się na tej samej niezmiennej logice. Scena wirtualna musiała zostać zdefiniowana w postaci matematycznych wierzchołków, zmatrycowana w przestrzeni trójwymiarowej, oświetlona za pomocą analitycznych modeli odbicia światła, a następnie zrasteryzowana do postaci dwuwymiarowej siatki pikseli na ekranie wyświetlacza. Wprowadzenie sprzętowego śledzenia promieni w czasie rzeczywistym stanowiło gigantyczny krok w stronę realizmu fotometrycznego, lecz nie zmieniło samej istoty procesu, wymuszając obliczanie setek milionów przecięć promieni ze strukturami przyspieszającymi BVH w każdej klatce obrazu. Jednakże wraz ze wzrostem wymagań dotyczących fotorealizmu, złożoności materiałowej oraz symulacji zjawisk falowych w mikrostrukturach, ten tradycyjny potok natrafił na barierę wykładniczego wzrostu kosztu obliczeniowego, której nie jest w stanie pokonać żadna miniaturyzacja litograficzna krzemu.
Równolegle w laboratoriach uczenia maszynowego dokonał się przełom, który podważył konieczność istnienia geometrycznego pośrednika między zamiarem symulacyjnym a generowanym fotonem. Rozwój generatywnych modeli dyfuzyjnych oraz transformatorów czasoprzestrzennych pokazał, że reprezentacja wizualna świata może zostać zakodowana nie w postaci sztywnych struktur bazodanowych czy plików assetów, lecz w wielowymiarowej przestrzeni wag głębokiej sieci neuronowej. Zamiast mozolnego teksturowania, cieniowania i wyliczania okluzji dla każdego trójkąta, model generatywny uczy się rozkładu prawdopodobieństwa występowania kolejnych stanów wizualnych bezpośrednio z surowych danych wideo. Oznacza to fundamentalne przejście od grafiki syntetycznej do neuronowej syntezy światów, w której renderowanie staje się procesem statystycznej inferencji w przestrzeni ukrytej, a nie mechanicznym rzutowaniem brył na płaszczyznę kamery.
Kluczowym katalizatorem tej transformacji stało się pojawienie modeli zdolnych do generowania wielosekundowych, spójnych sekwencji wideo o bezprecedensowej jakości, takich jak Sora, Movie Gen czy najnowsze iteracje otwartych architektur dyfuzyjnych. Przejście od statycznych obrazów do płynnego ruchu obnażyło jednak fundamentalną wadę klasycznych podejść generatywnych, jaką był brak interaktywności oraz zaporowe czasy generowania pojedynczych klatek. Tradycyjna inferencja dyfuzyjna wymagała dziesiątek, a niekiedy setek kroków odszumiania tensora ukrytego, co przy rozdzielczościach wysokiej definicji zajmowało od kilkunastu sekund do wielu minut na pojedynczą klatkę. Przełamanie tej bariery i wejście w reżim sześćdziesięciu klatek na sekundę przy minimalnym opóźnieniu wejście-wyjście wymagało całkowitej rekonceptualizacji architektury modeli, optymalizacji matematycznej procesu odszumiania oraz integracji pamięci przyczynowo-skutkowej, dając początek interaktywnemu neural renderingowi nowej ery.
Architektury Diffusion Transformers i tokenizacja czasoprzestrzenna
Fundamentem nowej generacji neuronowych silników graficznych jest połączenie mechanizmu dyfuzji ze skalowalnymi architekturami transformatorowymi, znanymi powszechnie jako Diffusion Transformers. W odróżnieniu od klasycznych sieci splotowych typu U-Net, które przez lata dominowały w generowaniu obrazów, transformatory czasoprzestrzenne nie nakładają sztywnych założeń indukcyjnych dotyczących lokalności przestrzennej. Cała sekwencja wideo traktowana jest jako zbiór trójwymiarowych tokenów czasoprzestrzennych, reprezentujących niewielkie wycinki przestrzenne w określonym oknie czasowym. W pierwszym etapie surowy sygnał wideo jest kompresowany przez zaawansowany czasoprzestrzenny autoenkoder wariacyjny, który redukuje redundancję danych o rzędy wielkości, mapując piksele do zwartej, wielowymiarowej przestrzeni ukrytej z jednoczesnym zachowaniem informacji o dynamice ruchu i relacjach geometrycznych.
W tak zdefiniowanej przestrzeni ukrytej każdy blok wideo staje się sekwencją wektorów, na których operują wielogłowicowe mechanizmy uwagi krzyżowej i własnej. To właśnie mechanizm uwagi czasoprzestrzennej pozwala modelowi na jednoczesne modelowanie relacji między odległymi fragmentami kadru oraz śledzenie ewolucji obiektów w czasie. W przeciwieństwie do tradycyjnych silników gier, w których fizyka kolizji, oświetlenie i animacja postaci są obsługiwane przez całkowicie odrębne podsystemy programowe, transformator uczy się tych zjawisk w sposób holistyczny. Cienie rzucane przez dynamiczne obiekty, zniekształcenia perspektywiczne przy gwałtownych ruchach kamery czy załamania światła na powierzchni wody nie wymagają dedykowanych procedur obliczeniowych ani shaderów, lecz wynikają bezpośrednio ze skumulowanej wiedzy o dynamice fizycznej wszechświata zawartej w parametrach sieci neuronowej.
Jednakże klasyczne transformatory czasoprzestrzenne borykają się z problemem kwadratowej złożoności obliczeniowej mechanizmu uwagi względem długości sekwencji. Przetwarzanie dziesiątek klatek w wysokiej rozdzielczości prowadzi do eksplozji wymagań pamięciowych, uniemożliwiając generowanie w czasie rzeczywistym na pojedynczych akceleratorach konsumenckich czy nawet serwerowych. Przełomem okazało się zastosowanie linearyzowanych mechanizmów uwagi, warstwowych struktur pamięci stanu oraz okienkowej uwagi czasowej, w której tokeny z bieżącej klatki wchodzą w interakcję jedynie ze ściśle zdefiniowanym buforem klatek historycznych oraz skompresowanym wektorem stanu globalnego. Dzięki temu koszt obliczeniowy inferencji kolejnej klatki staje się stały w czasie, co stanowi elementarny warunek wstępny dla jakiejkolwiek aplikacji interaktywnej o niskiej latencji.
Diffusion Forcing i przezwyciężenie dryfu autoregresyjnego
Jednym z najpoważniejszych wyzwań na drodze do stworzenia w pełni interaktywnych symulatorów neuronowych był tak zwany problem akumulacji błędów, znany również jako dryf autoregresyjny. Gdy model generuje sekwencję klatka po klatce, wykorzystując własne wcześniejsze predykcje jako dane wejściowe dla kolejnych kroków czasowych, nawet najdrobniejsze zniekształcenia probabilistyczne ulegają lawinowemu wzmocnieniu. Po zaledwie kilkudziesięciu wygenerowanych klatkach tradycyjny model dyfuzyjny tracił spójność geometryczną, obiekty ulegały rozmyciu, a fizyka sceny degradowała się do stanu niestabilnego chaosu. Zjawisko to uniemożliwiało tworzenie światów wirtualnych, w których użytkownik mógłby swobodnie poruszać się przez minuty lub godziny, oczekując niezmienności raz zaobserwowanych struktur.
Odpowiedzią na ten kryzys stał się paradygmat Diffusion Forcing, stanowiący nowatorskie połączenie sekwencyjnego uczenia autoregresyjnego z pełną elastycznością modeli dyfuzyjnych. Tradycyjne metody trenowania dyfuzji zakładały dodawanie jednolitego poziomu szumu do wszystkich klatek w przetwarzanym bloku czasowym. Diffusion Forcing wprowadza asymetryczny rozkład poziomów szumu wzdłuż osi czasu, w którym klatki przeszłe mogą znajdować się w stanie całkowicie odszumionym lub częściowo zaszumionym, podczas gdy klatka bieżąca i przyszłe poddawane są precyzyjnemu procesowi generowania warunkowanego. Pozwala to modelowi na jednoczesne pełnienie roli generatora nowej treści oraz filtra samokorygującego, który w czasie rzeczywistym stabilizuje reprezentację minionych stanów środowiska i zapobiega degeneracji geometrii.
Mechanizm ten działa niczym neuronowy bufor klatek o nieskończonej głębi semantycznej. Kiedy użytkownik wykonuje gwałtowny obrót wirtualną kamerą, a następnie powraca do punktu wyjścia, model nie generuje losowej nowej przestrzeni, lecz rekonstruuje dokładnie te same elementy architektoniczne i szczegóły otoczenia, które zostały zapamiętane w wektorach stanu ukrytego. Co więcej, Diffusion Forcing umożliwia płynne wprowadzanie zewnętrznych sygnałów sterujących, takich jak komendy z kontrolera gier, dane telemetryczne z gogli wirtualnej rzeczywistości czy bezpośrednie instrukcje tekstowe, modyfikując rozkład prawdopodobieństwa przyszłych klatek bez zrywania ciągłości fizycznej i wizualnej świata przedstawionego.
Destylacja krokowa i inferencja w jednej iteracji tensora
Nawet najbardziej wyrafinowana architektura transformatorowa nie pozwoliłaby na osiągnięcie sześćdziesięciu klatek na sekundę, gdyby inferencja każdej z nich wymagała tradycyjnego, wielokrokowego procesu całkowania równań różniczkowych stochastycznych. Klasyczne podejścia, takie jak algorytmy DDPM czy nawet zoptymalizowane solwery wyższego rzędu typu DPMSolver, potrzebowały minimum dziesięciu do dwudziestu iteracji sieci neuronowej, aby zredukować szum gaussowski do czystego sygnału wizualnego. Przy modelach liczących od kilku do kilkunastu miliardów parametrów, wykonanie tylu przejść w przód w oknie czasowym wynoszącym szesnaście milisekund przekraczało możliwości nawet najbardziej zaawansowanych klastrów obliczeniowych. Konieczne stało się zredukowanie liczby kroków odszumiania do wartości absolutnie minimalnej, czyli dokładnie jednej lub maksymalnie dwóch iteracji na klatkę.
Kluczem do osiągnięcia tego celu okazały się techniki zaawansowanej destylacji wiedzy, w szczególności destylacja spójności oraz dopasowywanie przepływów z kompresją trajektorii. W procesie destylacji model uczniowski jest trenowany tak, aby przewidywać punkt końcowy trajektorii odszumiania bezpośrednio z dowolnego zaszumionego stanu początkowego, eliminując konieczność stopniowego schodzenia po krzywej prawdopodobieństwa. Zaawansowane metody adversarialnej destylacji dyfuzji, wspierane przez dyskryminatory percepcji wieloskalowej, wymuszają na modelu generowanie ostrych krawędzi, mikrostruktur materiałowych i naturalnego ziarna fotograficznego w pojedynczym przejściu przez sieć. W ten sposób matematycznie złożony proces rozwiązywania stochastycznych równań różniczkowych zostaje przekształcony w deterministyczną funkcję nieliniową, realizowaną w ułamku milisekundy przez zoptymalizowane jądra tensorowe.
Dodatkowym czynnikiem radykalnie obniżającym opóźnienia jest technika projekcji resztkowej i propagacji cech w czasie. Zamiast generować od zera całą macierz pikseli w każdej kolejnej klatce, model neuronowy identyfikuje obszary o niskiej dynamice zmian i dokonuje jedynie transformacji współrzędnych przestrzennych dla istniejących cech ukrytych, skupiając moc obliczeniową wyłącznie na strefach okluzji, nowych źródłach światła oraz dynamicznie deformujących się obiektach. Taki hybrydowy przepływ obliczeń pozwala na osiągnięcie stałego czasu renderowania klatki na poziomie poniżej dziesięciu milisekund na nowoczesnych procesorach klasy Blackwell i Hopper, co z zapasem spełnia rygorystyczne wymagania interaktywnej rozrywki i profesjonalnych symulacji w czasie rzeczywistym.
Neuronowa fizyka i emergentne rozumienie praw dynamiki
Jednym z najbardziej fascynujących i zarazem kontrowersyjnych aspektów przejścia na neuronową syntezę wideo jest zjawisko emergencji praw fizyki. W tradycyjnym silniku gier komputerowych każde zachowanie obiektu musi zostać ściśle zaprogramowane w kodzie źródłowym za pomocą równań dynamiki bryły sztywnej, kinematyki odwrotnej, hydrodynamiki cząstek czy symulacji sprężystości tkanin. Jeśli programista nie zaimplementuje odpowiedniego algorytmu, woda nie będzie rozlewać się po podłodze, a szkło nie pęknie pod wpływem uderzenia. W modelach dyfuzyjnych nowej generacji rozumienie fizyki nie jest wprowadzane ręcznie, lecz wyłania się spontanicznie w trakcie pretreningu na gigantycznych zbiorach surowych nagrań wideo reprezentujących realny świat.
Analizując miliony godzin materiałów filmowych, głębokie sieci neuronowe indukują wewnętrzną, probabilistyczną reprezentację zasad rządzących mechaniką klasyczną, optyką i termodynamiką. Model uczy się, że upuszczony kubek z ceramiki po zderzeniu z twardą powierzchnią rozpada się na nieregularne odłamki, a znajdująca się w nim ciecz tworzy rozprysk o określonym napięciu powierzchniowym i rozkładzie kropli. Co istotne, model rozumie zachowanie grawitacji, bezwładności oraz zachowania pędu w stopniu umożliwiającym wiarygodną predykcję zachowania obiektów w sytuacjach, które nigdy wcześniej nie wystąpiły w zbiorze treningowym. To przejście od sztywnych reguł deterministycznych do statystycznej intuicji fizycznej otwiera drogę do tworzenia wirtualnych środowisk o stopniu złożoności i plastyczności absolutnie nieosiągalnym dla klasycznych algorytmów numerycznych.
Oczywiście neuronowa reprezentacja fizyki nie jest wolna od wad i osobliwości. W sytuacjach skrajnych, leżących poza rozkładem danych treningowych, modele dyfuzyjne miewają tendencję do generowania halucynacji geometrycznych, chwilowego naruszania ciągłości masy czy tworzenia nienaturalnych transformacji topologicznych. Dlatego w zaawansowanych systemach symulacyjnych stosuje się architektury hybrydowe, w których proces dyfuzji jest dodatkowo stabilizowany przez geometryczne więzy pomocnicze, śledzenie punktów kluczowych oraz wstępne siatki rzadkie. Pozwala to na połączenie nieograniczonej ekspresji wizualnej i fotorealizmu modeli generatywnych z matematyczną niezawodnością klasycznych systemów inżynieryjnych.
Transformacja przemysłu gier, kina i symulatorów militarnych
Konsekwencje wdrożenia generowania wideo w czasie rzeczywistym wykraczają daleko poza czysto techniczne aspekty renderowania grafiki, wywołując tektoniczne przesunięcie w całym przemyśle rozrywkowym, kinematografii oraz sektorze technologii obronnych. W branży gier komputerowych znikają dotychczasowe bariery produkcyjne związane z koniecznością ręcznego modelowania każdego obiektu, wypalania map oświetlenia, riggowania szkieletów animacyjnych i optymalizowania geometrii poziomów pod kątem budżetu pamięci VRAM. Twórca przyszłości przestaje być rzemieślnikiem manipulującym wierzchołkami w programie CAD, a staje się reżyserem semantycznym, który za pomocą języka naturalnego, szkiców koncepcyjnych lub demonstracji wideo definiuje zasady, estetykę i dynamikę generowanego w locie świata.
W kinematografii granica między produkcją a postprodukcją ulega ostatecznemu zatarciu. Tradycyjne techniki wirtualnej produkcji, wykorzystujące wielkie ściany LED z renderowanym w czasie rzeczywistym tłem z silników graficznych, zyskują nową jakość dzięki modelom dyfuzyjnym zdolnym do natychmiastowej reakcji na zmiany oświetlenia na planie filmowym, ruch aktorów i decyzje reżysera. Zamiast kosztownych tygodni renderowania efektów specjalnych na wielkich farmach obliczeniowych, zaawansowane sceny batalistyczne, symulacje zniszczeń czy fotorealistyczne kreacje cyfrowych postaci mogą być generowane, modyfikowane i rejestrowane bezpośrednio w trakcie ujęcia z zachowaniem pełnej spójności fotometrycznej.
Z kolei w zastosowaniach militarnych i szkoleniowych interaktywny neural rendering staje się fundamentem symulatorów nowej generacji o niespotykanym dotąd stopniu realizmu taktycznego. Zamiast sterylnych, powtarzalnych map poligonowych, systemy szkoleniowe dla pilotów myśliwców, operatorów dronów czy jednostek sił specjalnych mogą w czasie rzeczywistym generować dowolny teatr działań wojennych na podstawie aktualnych danych satelitarnych, zwiadowczych i meteorologicznych. Symulacja warunków atmosferycznych, zadymienia pola walki, zniszczeń infrastruktury czy zachowania tłumów w środowisku zurbanizowanym zyskuje wymiar organicznej nieprzewidywalności, wiernie odzwierciedlając chaos i złożoność współczesnego pola walki.
Nowa era syntetycznej percepcji i horyzont technologiczny
Stoimy na progu największej rewolucji w historii przetwarzania obrazu cyfrowego, która bezpowrotnie zmieni nasze rozumienie tego, czym jest obraz syntetyczny. Konwergencja wielkich modeli językowo-wizualnych, transformatorów dyfuzyjnych oraz dedykowanego krzemu akcelerującego obliczenia macierzowe doprowadziła do momentu, w którym granica między symulacją a rzeczywistością staje się kwestią czysto semantyczną. Klasyczne silniki graficzne nie znikną z dnia na dzień, lecz ich rola zostanie fundamentalnie zredukowana do funkcji niskopoziomowych rusztowań geometrycznych i układów koordynujących logikę rozgrywki, podczas gdy cała warstwa sensoryczna, estetyczna i fizyczna zostanie przejęta przez sieci neuronowe.
Kolejnym etapem tej ewolucji będzie pełna multimodalna integracja symulatorów świata, w której model generatywny w ramach jednolitej architektury syntetyzuje nie tylko fotorealistyczny obraz wideo w 60 klatkach na sekundę, lecz również przestrzenny dźwięk holograficzny, dotykowe sprzężenie zwrotne dla zaawansowanych interfejsów haptycznych oraz sygnały sterujące dla robotyki ucieleśnionej. Zdolność do generowania nieograniczonej liczby interaktywnych światów na żądanie przedefiniuje relację człowieka z informacją wizualną, tworząc przestrzeń dla zupełnie nowych form ekspresji twórczej, edukacji i badań naukowych. W tym nowym wspaniałym świecie algorytm nie jest już tylko narzędziem kreślarskim wykonującym instrukcje człowieka, lecz autonomicznym twórcą i fizykiem cyfrowej rzeczywistości.
Optymalizacja sprzętowa: Pamięć HBM3e, przepustowość magistrali i dedykowane silniki tensorowe
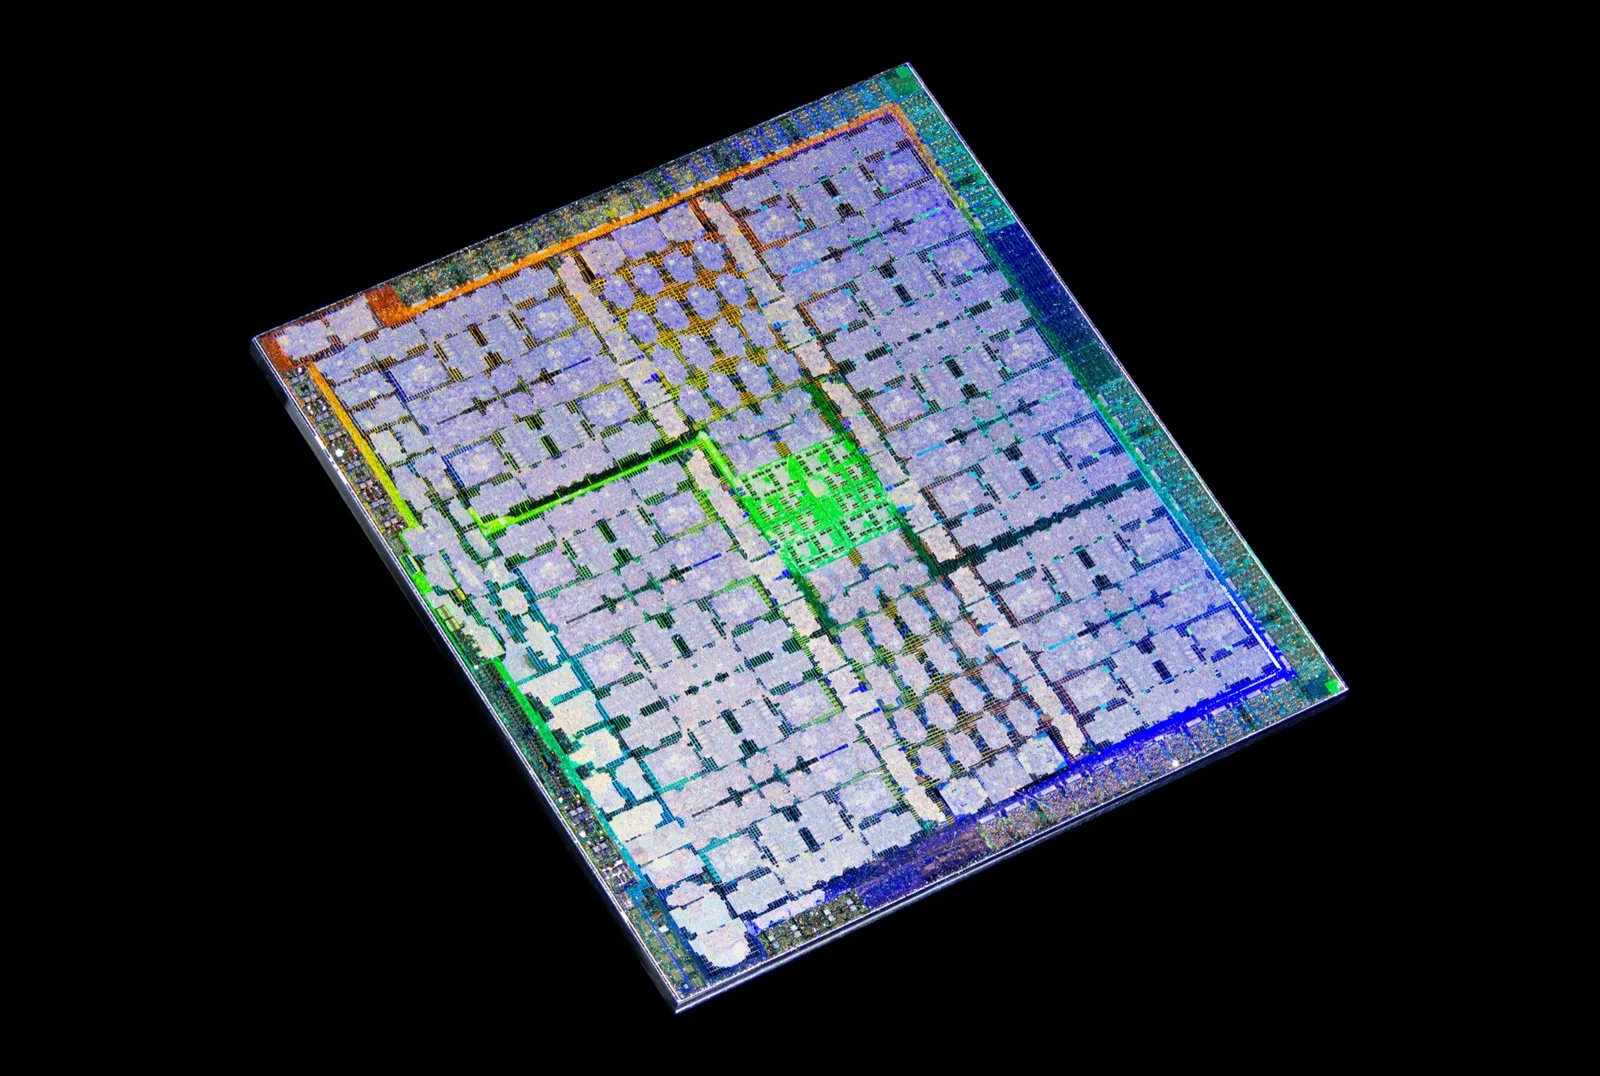
Osiągnięcie stabilnej przepustowości sześćdziesięciu klatek na sekundę w rozdzielczościach 4K dla modeli dyfuzyjnych o parametrach liczonych w miliardach wymagało przełamania nie tylko barier czysto algorytmicznych, lecz przede wszystkim radykalnego przeprojektowania mikroarchitektury krzemowej. W tradycyjnym przetwarzaniu grafiki wąskim gardłem była często wydajność jednostek cieniowania pikseli lub przepustowość pamięci tekstur. W przypadku interaktywnego neural renderingu charakter obciążenia ulega dramatycznemu przesunięciu w stronę masywnych mnożeń macierzy o niskiej precyzji oraz gigantycznych wymagań dotyczących pasma transferu wag modelu z pamięci VRAM do rejestrów procesora. Zastosowanie ultraszybkich stosów pamięci HBM3e oraz zintegrowanych magistrali pamięciowych o przepustowości przekraczającej osiem terabajtów na sekundę stało się bezwzględnym warunkiem koniecznym do tego, aby procesor był w stanie utrzymać stałe tempo inferencji bez przestojów w potoku wykonawczym.
Kluczową rolę w tym procesie odgrywa również ewolucja precyzji obliczeniowej. Zastąpienie standardowych formatów zmiennoprzecinkowych szesnastobitowych przez formaty FP8 oraz FP4 pozwoliło na czterokrotne zwiększenie gęstości upakowania wag w pamięci podręcznej SRAM bez zauważalnej degradacji jakości percepcyjnej generowanego obrazu. Nowoczesne jednostki obliczeniowe wprowadzają dedykowane mikrosilniki dekompresyjne i akceleratory uwagi czasoprzestrzennej, które bezpośrednio w krzemie realizują operacje FlashAttention oraz mechanizmy Diffusion Forcing. Dzięki temu narzut komunikacyjny między poszczególnymi blokami obliczeniowymi zostaje zminimalizowany, a energia zużywana na wygenerowanie pojedynczej klatki spada o rząd wielkości w porównaniu z rozwiązaniami serwerowymi poprzedniej generacji. Umożliwia to stopniową migrację technologii ze scentralizowanych klastrów chmurowych na zaawansowane stacje robocze twórców oraz platformy krawędziowe.
Wyzwania regulacyjne, znaki wodne C2PA i suwerenność syntetycznej rzeczywistości
Gwałtowny rozwój generowania wideo w czasie rzeczywistym o jakości nieodróżnialnej od rzeczywistości stawia społeczność międzynarodową, prawodawców oraz ekspertów do spraw bezpieczeństwa przed bezprecedensowymi wyzwaniami natury etycznej i regulacyjnej. Możliwość natychmiastowej, interaktywnej syntezy dowolnej postaci, wydarzenia czy otoczenia fizycznego stwarza gigantyczne pole do nadużyć w obszarze dezinformacji, inżynierii społecznej oraz wojny kognitywnej. W odpowiedzi na to zagrożenie wiodące konsorcja technologiczne oraz instytucje normalizacyjne przyspieszają wdrażanie kryptograficznych standardów uwierzytelniania treści, takich jak standard C2PA, który umożliwia osadzanie niezmiennych, cyfrowych podpisów pochodzenia bezpośrednio w strukturze generowanego strumienia wideo.
W przypadku wideo generowanego na żywo wyzwaniem staje się jednak stworzenie takich mechanizmów znakowania wodnego, które nie wpływają negatywnie na opóźnienia potoku renderowania, a jednocześnie wykazują całkowitą odporność na kompresję, kadrowanie czy zniekształcenia transmisyjne. Nowatorskie podejścia wykorzystują niewidoczne dla ludzkiego oka modyfikacje częstotliwościowe w przestrzeni ukrytej modelu, które działają jak niezmywalny genetyczny kod syntetycznego pochodzenia klatki. Równocześnie rządy i agencje wywiadowcze na całym świecie zaczynają traktować zaawansowane modele symulacji świata jako technologie podwójnego zastosowania o znaczeniu strategicznym, podlegające ścisłym kontrolom eksportowym na równi z technologiami nuklearnymi czy szyframi wojskowymi. Suwerenność w zakresie własnych fundamentów generatywnych staje się nowym filarem bezpieczeństwa narodowego w erze postprawdy.
W ostatecznym rozrachunku wkraczamy w epokę, w której syntetyczny obraz wideo przestaje być biernym zapisem przeszłości lub prostą iluzją graficzną stworzoną przez grafików, a staje się dynamicznym, żywym medium poznawczym. Zdolność do interaktywnego modelowania zjawisk fizycznych i społecznych w czasie rzeczywistym otworzy bezprecedensowe możliwości przed inżynierią materiałową, medycyną rekonstrukcyjną i autonomiczną eksploracją kosmosu. Społeczeństwo, które opanuje te narzędzia na poziomie suwerennej infrastruktury obliczeniowej, zyska nie tylko dominację technologiczną i kulturową, lecz przede wszystkim zdolność do kształtowania i przewidywania przyszłości w stopniu dotychczas zarezerwowanym wyłącznie dla sfery literatury fantastycznonaukowej.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.