
Generatywne modele świata World Models i inteligencja przestrzenna: Jak symulacje fizyki neuronowej, 3D Gaussian Splatting i architektury JEPA redefiniują fundamenty autonomii robotycznej na drodze do AGI
Granice symbolicznego paradygmatu: Dlaczego tekst nie wystarczy do zbudowania AGI
Współczesna fala zachwytu nad generatywną sztuczną inteligencją, napędzana przez wielomiliardowe autoregresyjne modele językowe LLM, doprowadziła do powstania złudzenia, że ekstrapolacja skalowania predykcji kolejnego tokena tekstowego jest bezpośrednią i wystarczającą ścieżką do osiągnięcia ogólnej sztucznej inteligencji AGI. Choć systemy oparte na architekturze Transformer wykazują zdumiewające zdolności w operowaniu strukturami gramatycznymi, syntetyzowaniu kodu źródłowego oraz streszczaniu wielkich korpusów literatury, ich kompetencje poznawcze okazują się dramatycznie kruche w chwili, gdy stają w obliczu elementarnych problemów ze świata fizycznego.
Model językowy może napisać bezbłędny esej na temat praw aerodynamiki lub fizyki Newtona, a jednocześnie wykazać całkowitą bezradność przy próbie przewidzenia, w którym kierunku potoczy się przewrócona szklanka z wodą na pochyłym blacie stołu kuchennego. Wynika to z faktu, że wiedza zakodowana w ciągach znaków alfanumerycznych jest wiedzą wtórną, odcieleśnioną i pozbawioną zakotwiczenia sensoryczno-motorycznego, określanego w kognitywistyce jako Symbol Grounding Problem.
Biologiczna ewolucja układów nerwowych na Ziemi poświęciła ponad pięćset milionów lat na doskonalenie percepcji przestrzennej, koordynacji ruchowej, modelowania interakcji z otoczeniem oraz intuicyjnego przewidywania następstw własnych działań motorycznych. Zdolności językowe pojawiły się u przodków człowieka zaledwie wczoraj w skali ewolucyjnej, będąc jedynie cienką, symboliczną nadbudową nad potężnym, ewolucyjnie ukształtowanym fundamentem inteligencji przestrzennej i sensorycznej.
Dziecko w wieku dwóch lat, które nie zna jeszcze zasad mechaniki klasycznej ani równań różniczkowych, bez trudu chwyta niestabilną zabawkę, ocenia jej ciężar, przewiduje trajektorię spadającego klocka i unika przeszkód w trójwymiarowej przestrzeni. Współczesny robot humanoidalny, wyposażony w procesor wykonujący biliony operacji na sekundę i podłączony do największego modelu językowego, bez odpowiedniego modelu świata przewraca się na prostej nierówności chodnika, ponieważ brakuje mu wewnętrznej reprezentacji praw fizyki rządzących otaczającą go materią.
Czym są generatywne modele świata: Od hipotezy Craika do fizyki w przestrzeni ukrytej
Koncepcja, zgodnie z którą inteligencja polega na budowaniu wewnątrz umysłu symulacji otaczającej rzeczywistości, nie jest nowa. Już w tysiąc dziewięćset czterdziestym trzecim roku szkocki psycholog i filozof Kenneth Craik sformułował przełomową hipotezę, że organizm żywy nosi w swoich strukturach neuronowych miniaturowy model zewnętrznego świata, który pozwala mu bezpiecznie testować różne scenariusze działania w wyobraźni przed ich fizycznym wdrożeniem.
We współczesnej inżynierii sztucznej inteligencji termin World Models zyskał precyzyjne znaczenie matematyczne. Model świata to samonadzorowana architektura neuronowa, która na podstawie sekwencji dotychczasowych obserwacji sensorycznych oraz podjętych działań motorycznych uczy się przewidywać przyszłe stany otoczenia w wielowymiarowej przestrzeni ukrytej Latent Space. Kluczowe jest przy tym odejście od naiwnej predykcji każdego piksela obrazu na rzecz modelowania głębokich, semantycznych i strukturalnych właściwości sceny.
Pionierskie prace Davida Ha i Jürgena Schmidhubera zdefiniowały klasyczny trójpodział architektury modelu świata na moduł percepcji wizyjnej V, moduł pamięci czasowej M oraz kontroler decyzyjny C. W nowoczesnych implementacjach moduł V to zaawansowany autoenkoder przestrzenny, który kompresuje strumień wielosensorowy do wektora cech, moduł M to probabilistyczny model rekurencyjny lub transformatorowy modelujący przejścia stanów w czasie, natomiast kontroler C to sieć optymalizująca politykę działania agenta wyłącznie w wyobraźni, czyli wewnątrz generowanej symulacji neuronowej.
Dzięki temu robot nie musi uczyć się chodzenia metodą prób i błędów w świecie fizycznym, gdzie każdy upadek grozi uszkodzeniem drogich siłowników harmonicznych i przekładni planetarnych. Agent wykonuje miliony wirtualnych kroków w przestrzeni symulowanej przez model świata, odkrywając optymalne wzorce równowagi w ułamku sekundy czasu rzeczywistego, po czym transferuje wyuczone umiejętności bezpośrednio do fizycznego ciała w paradygmacie Sim-to-Real.
Architektury JEPA i koniec marnotrawstwa rekonstrukcji pikseli
Jednym z najważniejszych przełomów teoretycznych w budowie modeli świata było sformułowanie przez Yanna LeCuna architektury JEPA Joint Embedding Predictive Architecture. Dotychczasowe generatywne modele wizyjne, oparte na dyfuzji pikselowej lub autoenkoderach maskowanych MAE, marnowały olbrzymią część mocy obliczeniowej na rekonstruowanie nieistotnych, chaotycznych szczegółów otoczenia, takich jak szum liści na wietrze, fluktuacje fal na wodzie czy faktura tynku na odległym budynku.
Próba przewidywania każdego pojedynczego piksela w warunkach niepewności prowadzi do zjawiska halucynacji lub rozmycia obrazu, ponieważ model stara się uśrednić nieskończoną liczbę możliwych mikrostawów tła, co uniemożliwia mu uchwycenie kluczowej struktury przyczynowo-skutkowej. Architektura JEPA całkowicie rezygnuje z generowania pikseli w przestrzeni wyjściowej na rzecz predykcji osadzeń w abstrakcyjnej przestrzeni cech.
W modelu JEPA koder sensoryczny przetwarza aktualny stan sceny, natomiast koder docelowy, aktualizowany za pomocą wykładniczej średniej kroczącej EMA, przetwarza stan przyszły. Sieć predykcyjna uczy się rzutować przeszłe osadzenia w przyszłe osadzenia pod wpływem zadanego wektora akcji motorycznej. W ten sposób model skupia się wyłącznie na przewidywaniu tych elementów otoczenia, które są przewidywalne i istotne z punktu widzenia fizyki interakcji, ignorując nieistotny szum tła.
Wdrożenie modeli takich jak I-JEPA dla obrazów statycznych oraz V-JEPA dla wideo udowodniło, że samonadzorowane uczenie bez etykiet pozwala na samorzutne wykształcenie w wagach sieci głębokiego rozumienia geometrii obiektów, ich stałości fizycznej Object Permanence oraz relacji przestrzennych. Gdy na nagraniu wideo duży obiekt przesłania mniejszy, model JEPA doskonale wie, że mniejszy obiekt nadal istnieje za przeszkodą i przewiduje moment, w którym wyłoni się z drugiej strony, co stanowi fundament percepcji każdego zaawansowanego robota autonomicznego.
Neural Rendering i 3D Gaussian Splatting: Reprezentacje geometrii dla robotów
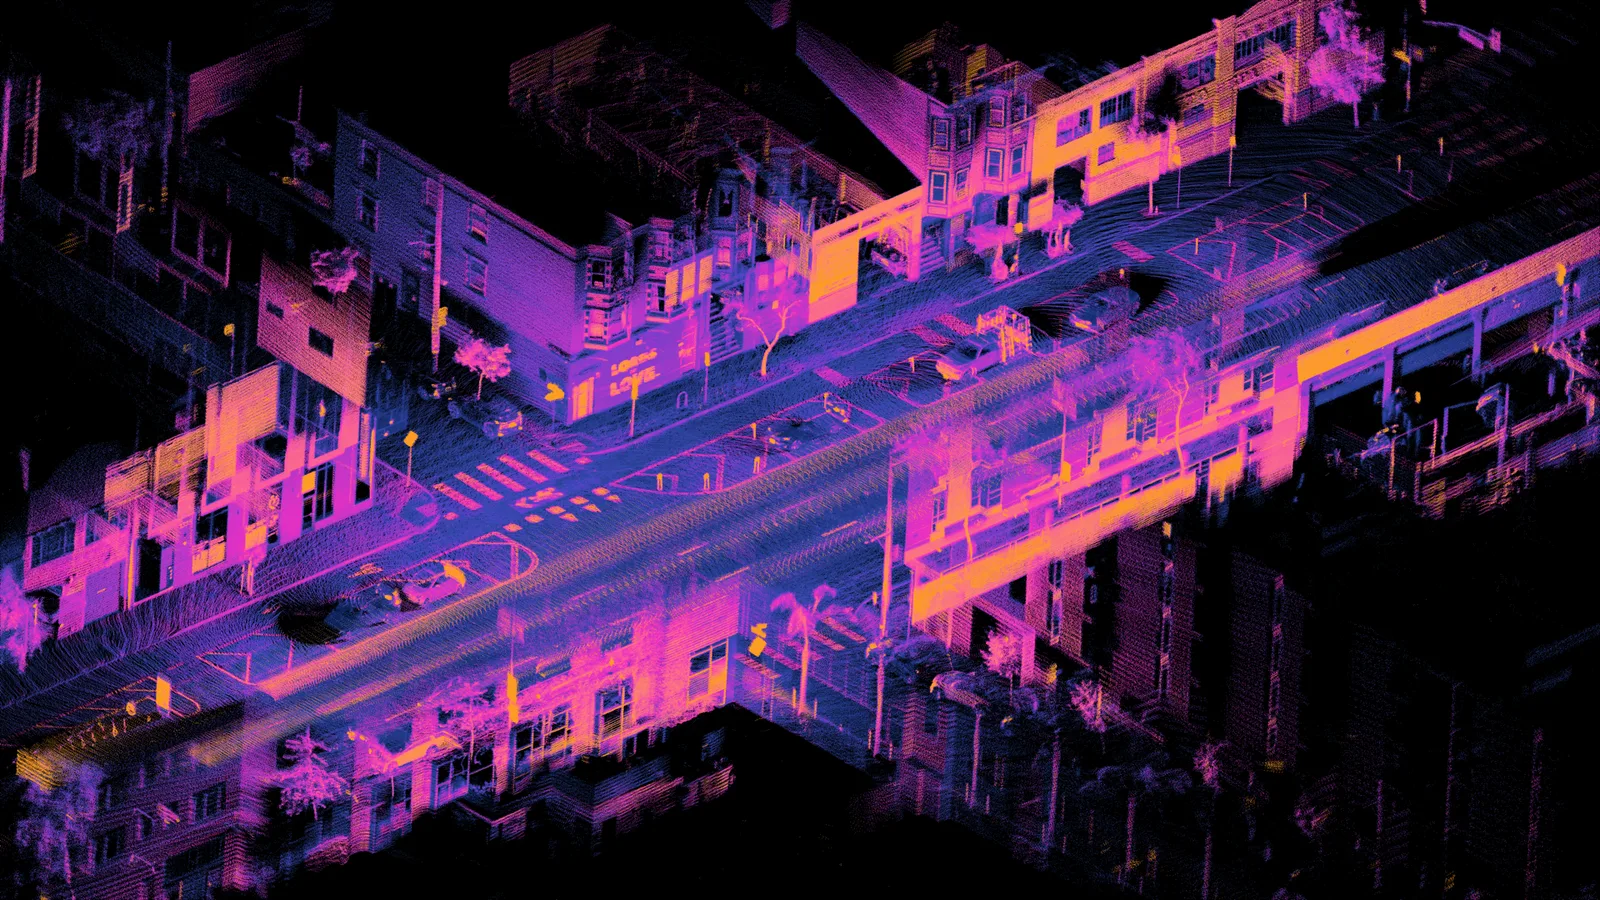
Aby model świata mógł precyzyjnie wspierać manipulację manualną i nawigację, musi dysponować gęstą, ciągłą i metrycznie dokładną reprezentacją trójwymiarową otaczającej przestrzeni. Przez lata standardem w teledetekcji robotycznej były siatki wielokątów Polygon Meshes, mapy zajętości Occupancy Grids oraz chmury punktów Point Clouds. Metody te charakteryzowały się jednak wysokim kosztem obliczeniowym, dyskretnym charakterem lub brakiem możliwości gładkiego różniczkowania w potokach uczenia maszynowego.
Prawdziwym przełomem stało się pojawienie się neuronowych pól promienistości NeRF Neural Radiance Fields, które reprezentują scenę 3D jako ciągłą funkcję objętościową kodowaną w wagach perceptronu wielowarstwowego MLP. Choć NeRF zrewolucjonizował fotorealistyczny neural rendering, jego gigantyczny narzut obliczeniowy związany z koniecznością próbkowania promieni wzdłuż osi widzenia Ray Marching uniemożliwiał zastosowanie w sterowaniu robotami w czasie rzeczywistym.
Odpowiedzią na ten impas okazała się technologia 3D Gaussian Splatting 3DGS, opracowana przez zespół Bernharda Kerbla. Zamiast ciągłej funkcji neuronowej, scena jest reprezentowana przez miliony anizotropowych, trójwymiarowych elipsoid Gaussa, z których każda posiada ściśle zdefiniowaną pozycję środka, kowariancję opisującą geometrię i orientację, przezroczystość alfa oraz współczynniki harmonicznych sferycznych kodujące kierunkowy kolor.
Renderowanie sceny w 3DGS odbywa się poprzez rzutowanie elipsoid na płaszczyznę kamery i ich superszybkie sortowanie kafelkowe na akceleratorach graficznych GPU, co pozwala na generowanie krystalicznie czystych obrazów w rozdzielczości czterech tysięcy pikseli z prędkością przekraczającą dwieście klatek na sekundę. W robotyce 3D Gaussian Splatting stał się idealnym geometrycznym mostem między percepcją a działaniem, umożliwiając robotowi błyskawiczną rekonstrukcję trójwymiarowego otoczenia z pojedynczej kamery RGB i natychmiastowe planowanie bezkolizyjnych trajektorii ramienia z mikrometrową precyzją.
Manipulacja obiektami odkształcalnymi i intuicyjna fizyka zderzeń
Najtrudniejszym sprawdzianem dla modeli świata jest manipulacja obiektami miękkimi, tekstyliami, płynami oraz ciałami sypkimi, które wymykają się tradycyjnym algorytmom analitycznej kinematyki robotycznej opartej na sztywnych bryłach bryły sztywnej Rigid Body Dynamics. Robot, który ma pościelić łóżko, zawiązać węzeł, pokroić warzywa czy napełnić kieliszek płynem, musi nieustannie antycypować deformacje materiału pod wpływem nacisku własnych chwytaków.
Nowoczesne generatywne modele świata integrują w swojej przestrzeni ukrytej neuronowe aproksymatory mechaniki ośrodków ciągłych, oparte na metodzie punktów materialnych MPM Material Point Method oraz wygładzonej hydrodynamice cząstek SPH Smoothed Particle Hydrodynamics. Sieć neuronowa uczy się traktować materię jako zbiór połączonych relacyjnie cząstek, przewidując naprężenia ścinające, plastyczność i sprężystość w czasie rzeczywistym.
Gdy robot chwyta delikatny owoc, model świata generuje symulację odkształcenia skórki pod wpływem zadanej siły zacisku siłownika tensometrycznego, natychmiast korygując trajektorię palców, aby nie uszkodzić miąższu. Z kolei przy krojeniu nożem model antycypuje propagację pęknięcia w strukturze materiału, dynamicznie modulując kąt natarcia ostrza. Ta zdolność do przewidywania nieliniowych reakcji fizycznych sprawia, że robot przestaje być ślepym automatem powtarzającym sztywno zaprogramowane sekwencje ruchów, stając się adaptacyjnym manipulatorem czującym opór materii.
Co więcej, integracja modeli świata z dotykowymi sensorami neuromorficznymi Tactile Sensing, takimi jak sensory żelowe GelSight oparte na pomiarze ugięcia elastomeru przez mikrokamerę, pozwala na fuzję wizyjno-haptyczną. Robot widzi obiekt, dotyka go, a jego wewnętrzny model świata łączy sygnały optyczne z mechanicznym oporem podłoża, tworząc jednolitą, spójną reprezentację fizyczną manipulowanego przedmiotu.
Uczenie zbrojenia w wyobraźni: Koniec z niszczeniem sprzętu na poligonach
Tradycyjne uczenie przez wzmacnianie Reinforcement Learning RL, które odniosło spektakularne sukcesy w grach logicznych takich jak Go czy szachy, w zastosowaniach robotycznych zderza się z barierą zwaną Sample Inefficiency. Aby wyszkolić sieć neuronową w wykonywaniu skomplikowanego manewru akrobatycznego na czworonożnym robocie, algorytm potrzebuje setek milionów interakcji ze środowiskiem. W świecie fizycznym oznaczałoby to lata ciągłych prób, podczas których setki prototypów uległyby całkowitemu zniszczeniu mechanicznemu.
Generatywne modele świata rewolucjonizują uczenie przez wzmacnianie poprzez przeniesienie całego procesu eksploracji do domeny wirtualnej, w paradygmacie Dreamer opracowanym przez Danafa Hafnera. W podejściu tym agent nie wchodzi w bezpośrednią interakcję ze środowiskiem zewnętrznym podczas treningu. Zamiast tego model świata generuje wyobrażone trajektorie stanów w przestrzeni ukrytej, a krytyk i aktor sieci neuronowej uczą się optymalnych decyzji, propagując gradienty błędu wstecz przez czas wewnątrz samej symulacji neuronowej.
Ponieważ symulacja w przestrzeni ukrytej jest w pełni różniczkowalna Differentiable Physics, agent nie musi błądzić po omacku za pomocą algorytmów bezgradientowych. Może dokładnie obliczyć analityczny gradient funkcji nagrody względem swoich parametrów sterowania, co przyspiesza tempo uczenia o kilka rzędów wielkości. Robot humanoidalny wyposażony w model Dreamer jest w stanie nauczyć się wstawania z podłogi, biegania po nierównym terenie czy łapania rzucanych piłek w ciągu zaledwie kilkunastu godzin symulacji na pojedynczej stacji roboczej.
Po osiągnięciu zbieżności w wyobraźni, wyuczona polityka sieci aktora jest wgrywana bezpośrednio do kontrolera rzeczywistego robota. Dzięki technice randomizacji domeny Domain Randomization, w której model świata podczas treningu wirtualnego celowo modyfikuje współczynniki tarcia, masy kończyn, opóźnienia siłowników i szumy sensorowe, transfer do rzeczywistości odbywa się bez utraty stabilności Zero-Shot Sim-to-Real Transfer.
Od robotyki przemysłowej po autonomię kosmiczną: Implikacje strategiczne
Skutki upowszechnienia generatywnych modeli świata wykraczają daleko poza laboratoria akademickie i fabryki samochodów, stając się kluczowym czynnikiem przewagi geopolitycznej i technologicznej w skali globalnej. Narody i korporacje, które opanują produkcję autonomicznych robotów wyposażonych w modele świata, zyskają rozwiązanie problemu zapaści demograficznej w przemyśle wytwórczym, budownictwie, logistyce oraz opiece nad osobami starszymi.
W wymiarze militarnym roboty posiadające intuicyjną fizykę i inteligencję przestrzenną staną się podstawą autonomicznych platform saperskich, systemów ewakuacji medycznej CASEVAC spod ostrzału oraz rojów rozpoznawczo-uderzeniowych operujących w skrajnie trudnym terenie miejskim i podziemnym bez dostępu do łączności satelitarnej. Robot, który rozumie, jak zawalają się stropy budynków i jak rozchodzą się fale uderzeniowe, może samodzielnie wyznaczać najbezpieczniejsze korytarze natarcia i manewru.
Równie fundamentalne znaczenie modele świata odegrają w eksploracji kosmosu. Bezzałogowe łaziki i drony eksplorujące powierzchnię Marsa, Księżyca czy lodowych księżyców Jowisza i Saturna muszą zmagać się z opóźnieniami sygnału radiowego sięgającymi kilkudziesięciu minut. Zdalne sterowanie joystickiem z Ziemi jest w tych warunkach niemożliwe. Autonomiczny robot wyposażony w model świata może badać nieznane jaskinie lawowe, oceniać stabilność regolitowych skarp i lądować na nieprzyjaznym gruncie bez asysty człowieka, będąc w pełni samodzielnym pionierem nowej ery eksploracji.
W perspektywie nadchodzących lat synteza generatywnych modeli świata, zwinnego neural renderingu 3DGS oraz wielomodalnych architektur JEPA ostatecznie zamknie przepaść dzielącą cyfrową sztuczną inteligencję od fizycznego świata. Maszyny przestaną być jedynie bezcielesnymi generatorami słów, stając się aktywnymi, rozumiejącymi fizykę uczestnikami materialnej rzeczywistości, co stanowi ostateczny i decydujący krok ku powstaniu prawdziwej, ucieleśnionej ogólnej sztucznej inteligencji Embodied AGI.
Warto szczegółowo zbadać matematyczne sformułowanie teorii kodowania predykcyjnego Predictive Coding w ujęciu Karla Fristona oraz zasadę wolnej energii Free Energy Principle, która stanowi teoretyczny rdzeń biologicznego modelowania świata. Zgodnie z tym sformułowaniem, każdy żywy układ poznawczy dąży do minimalizacji rozbieżności między swoimi wewnętrznymi przewidywaniami a docierającymi sygnałami sensorycznymi, określanej jako błąd predykcji Prediction Error. W sztucznych modelach świata funkcja straty opiera się na minimalizacji dywergencji Kullbacka-Leiblera pomiędzy rozkładem prawdopodobieństwa stanów przewidywanych a rozkładem stanów obserwowanych w przestrzeni ukrytej, co wymusza na sieci wykształcenie zwartych, estetycznych reprezentacji praw fizyki bez konieczności jakiegokolwiek nadzoru ze strony człowieka.
Równie istotnym aspektem inżynierii percepcji przestrzennej jest fuzja informacji z kamer korygujących pozycję z pomiarami z mikroskopijnych jednostek inercyjnych IMU Inertial Measurement Unit w ramach algorytmów odometrii wizyjno-inercyjnej VIO. Gdy robot wykonuje gwałtowne ruchy obrotowe głowy, sensory optyczne ulegają rozmyciu ruchowemu Motion Blur, co w tradycyjnych algorytmach SLAM prowadzi do natychmiastowej utraty orientacji i zerwania śledzenia trajektorii. W nowoczesnych modelach świata sieć neuronowa integruje przyspieszenia kątowe i liniowe z żyroskopów kwantowych bezpośrednio w przestrzeni ukrytej, przewidując przepływ optyczny w czasie mikrosekund i zachowując absolutną stabilność mapy otoczenia nawet przy ekstremalnych wstrząsach mechanicznych.
Nie można pominąć również kwestii bezpieczeństwa semantycznego i odporności modeli świata na zjawisko Out-of-Distribution OOD w nieprzewidywalnych warunkach środowiskowych. Tradycyjne systemy wizyjne wpadają w pułapkę konfabulacji w chwili, gdy napotykają obiekt niewystępujący w zbiorze treningowym, na przykład przewrócone drzewo o nietypowym kształcie czy lustrzaną kałużę odbijającą niebo na środku drogi. Generatywne modele świata, dzięki reprezentacji probabilistycznej opartej na ensemblach sieci neuronowych, są w stanie oszacować własną niepewność epistemiczną Epistemic Uncertainty. Gdy niepewność przekracza bezpieczny próg progowy, robot nie podejmuje ryzykownych manewrów w ciemno, lecz automatycznie zwalnia, wykonuje ostrożne ruchy sondujące chwytakiem lub prosi operatora o wsparcie, zapobiegając wypadkom przemysłowym.
Zrównoleglona fizyka GPU, kontrola odruchowa 1 kHz i zdrowy rozsądek przestrzenny
Warto szczegółowo zbadać zagadnienie minimalizacji luki symulacyjnej Sim-to-Real Gap za pomocą zrównoleglonych silników fizyki neuronowej nowej generacji, takich jak platformy NVIDIA Isaac Gym, MuJoCo czy Genesis. W tradycyjnych środowiskach symulacyjnych obliczenia dynamiki wieloczłonowej były wąskim gardłem procesora nadrzędnego CPU, co ograniczało symulację do kilkudziesięciu robotów jednocześnie. Przeniesienie symulatora fizyki bezpośrednio na tysiące rdzeni CUDA i Tensor Cores w architekturze GPU umożliwia równoległe uruchomienie setek tysięcy wirtualnych środowisk na pojedynczym klastrze serwerowym. W tym reżimie pracy model świata w ciągu zaledwie jednej doby generuje ekwiwalent dziesięciu tysięcy lat doświadczenia motorycznego, eksplorując skrajne scenariusze zderzeń, poślizgów na lodzie i nagłych uszkodzeń siłowników.
Kluczowym komponentem architektury sterowania jest również hierarchiczne rozdzielenie czasu reakcji na pętlę wolną semantyczną oraz pętlę szybką motoryczną. Wolna pętla modelu świata, pracująca z częstotliwością od dziesięciu do dwudziestu herców, odpowiada za generowanie długoterminowych celów przestrzennych, aktualizację reprezentacji 3D Gaussian Splatting oraz wnioskowanie o intencjach otaczających ludzi. Z kolei szybka pętla kontrolera odruchowego Reflex Controller, zasilana bezpośrednio z wyjścia modelu świata, musi wykonywać obliczenia kinematyki odwrotnej i sterowania impedancyjnego z częstotliwością co najmniej jednego kiloherca. Taka separacja gwarantuje, że robot zachowuje stabilność dynamiczną i natychmiastowo kompensuje zewnętrzne zaburzenia równowagi, nie czekając na zakończenie pełnego cyklu wnioskowania głębokiej sieci neuronowej.
Równie przełomowym kierunkiem jest wyłonienie się tak zwanego zdrowego rozsądku przestrzennego Spatial Commonsense Reasoning w wielomodalnych modelach świata. O ile wczesne roboty postrzegały przestrzeń jako zbiór geometrycznych współrzędnych bez znaczenia semantycznego, o tyle modele integrujące wizyjne osadzenia przestrzenne z dynamicznymi modelami przyczynowości natychmiast rozumieją relacje funkcjonalne pomiędzy przedmiotami. Robot widząc uchylone drzwi szafy wie, że pociągnięcie za klamkę zmieni stan przestrzenny obiektu, odsłaniając nową przestrzeń roboczą, a widząc niestabilnie ułożoną piramidę naczyń, unika potrącenia jej krawędzi, intuicyjnie szacując środek ciężkości i siłę bezwładności.
Ostatecznym sprawdzianem dla ucieleśnionych modeli świata stanie się ich odporność na manipulacje w środowiskach zmiennych dynamicznie z obecnością ludzi i zwierząt domowych. W przeciwieństwie do sterylnych hal fabrycznych, przestrzeń domowa charakteryzuje się nieustannym chaosem, porzuconymi zabawkami, zmiennym oświetleniem słonecznym i nieprzewidywalnymi trajektoriami domowników. Generatywny model świata, stale aktualizujący swoją mapę prawdopodobieństw w wyobraźni, traktuje obecność człowieka nie jako statyczną przeszkodę, lecz jako dynamicznego agenta o własnych zamiarach, antycypując jego ruchy i ustępując przejścia z gracją i płynnością przewyższającą jakiekolwiek tradycyjne algorytmy planowania ścieżki.
Warto na koniec podkreślić, że ostateczna konwergencja generatywnych modeli świata z architekturą neuropodobną oznacza definitywny koniec epoki naiwnego skalowania tekstowego. Dopiero maszyna, która rozumie opór grawitacji, tarcie powierzchniowe, nieodwracalność termodynamiczną i geometrię trójwymiarową, zyska prawo do miana prawdziwej sztucznej inteligencji. Przejście od przetwarzania symboli do modelowania fizycznego uniwersum to największy krok technologiczny naszej cywilizacji, otwierający drzwi do świata, w którym roboty staną się pełnoprawnymi partnerami człowieka w badaniu i przekształcaniu otaczającej nas rzeczywistości.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.