
Fotoniczne układy scalone PIC i optyczne połączenia chipletowe w klastrach AI: Jak krzemowa fotonika i technologia CPO przełamują barierę 100 Tb/s
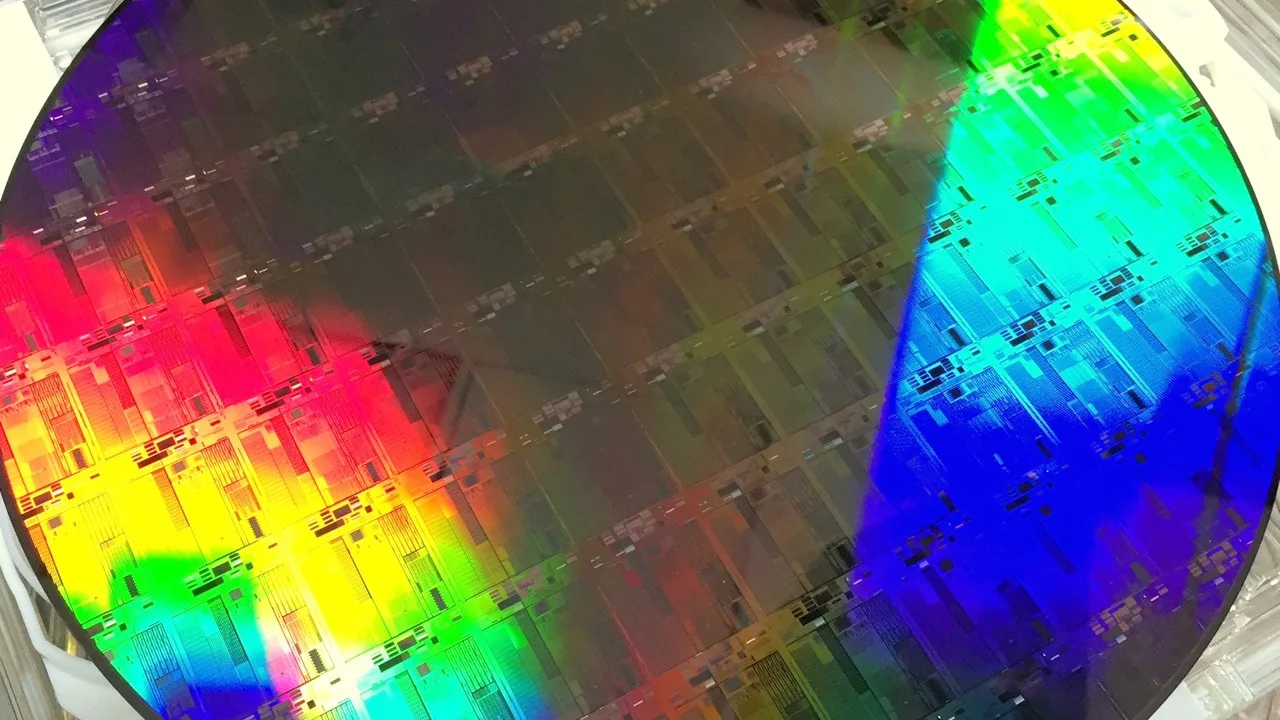
Skalowanie wielkich modeli językowych i systemów sztucznej inteligencji nowej generacji napotkało na niewidzialną, lecz bezwzględną barierę praw fizyki. Podczas gdy moc obliczeniowa akceleratorów graficznych GPU i procesorów wektorowych rosła w ostatnich latach w tempie geometrycznym, przepustowość interkonektów łączących poszczególne chipy w szafach serwerowych zaczęła drastycznie odbiegać od potrzeb algorytmicznych. Tradycyjna miedź, która przez dekady stanowiła podstawę budowy płyt głównych, magistrali PCIe oraz kabli transmisyjnych NVLink, osiągnęła swój fizyczny kres w reżimie ultrawysokich częstotliwości.
Przy prędkościach transmisji rzędu dwustu gigabitów na sekundę na pojedynczy pas transmisyjny PAM4, miedziane ścieżki na zaawansowanych laminatach dielektrycznych, takich jak Megtron-7 czy Tachyon-100G, wykazują katastrofalne tłumienie sygnału. Zjawisko naskórkowości Skin Effect, straty dielektryczne oraz interferencje elektromagnetyczne sprawiają, że maksymalny zasięg transmisji bez użycia energochłonnych układów re-timerów i equalizerów DSP skurczył się do zaledwie kilkunastu centymetrów. Ponad trzydzieści procent całkowitego budżetu energetycznego współczesnego serwera sztucznej inteligencji jest marnowane wyłącznie na przepychanie bitów przez miedziane magistrale.
W tej sytuacji jedyną technologicznie wykonalną ścieżką rozwoju stało się zastąpienie elektronów przez fotony nie tylko na poziomie długodystansowych połączeń między szafami serwerowymi, lecz bezpośrednio wewnątrz pakietu procesora. Rewolucję tę napędzają fotoniczne układy scalone Photonic Integrated Circuits PIC, krzemowa fotonika Silicon Photonics oraz nowatorska architektura współdzielonego pakowania optyki Co-Packaged Optics CPO.
Krzemowa fotonika: Gdy krzem staje się światłowodem
Przez dziesięciolecia dominowało przekonanie, że krzem jest materiałem zupełnie nieprzydatnym do budowy elementów optoelektronicznych ze względu na swoją strukturę pasmową o skośnej przerwie energetycznej Indirect Bandgap, która uniemożliwia wydajną emisję światła w wyniku rekombinacji promienistej elektronów i dziur. Przełom nastąpił wraz z uświadomieniem sobie, że krzem posiada jedną fundamentalną zaletę: niezwykle wysoki współczynnik załamania światła wynoszący około 3,45 w paśmie podczerwieni bliskiej, w porównaniu do 1,45 dla dwutlenku krzemu SiO2.
Ten gigantyczny kontrast współczynników załamania umożliwia budowę mikroskopijnych falowodów na podłożach typu Silicon-on-Insulator SOI o przekroju poprzecznym mniejszym niż pół mikrometra. Falowody te potrafią zakrzywiać strumień światła pod kątem o promieniu zaledwie kilku mikrometrów bez strat radiacyjnych, co pozwoliło na upakowanie setek tysięcy komponentów optycznych na pojedynczym kawałku krzemu o powierzchni zaledwie kilku milimetrów kwadratowych. Co najważniejsze, krzemowe układy fotoniczne mogą być wytwarzane na tych samych liniach litograficznych CMOS w fabrykach takich jak TSMC czy GlobalFoundries, wykorzystując sprawdzoną technologię masowej produkcji wafli krzemowych trzysta milimetrów.
Fizyka sprzężenia światłowodowego: Siatki dyfrakcyjne i sprzęgacze krawędziowe
Jednym z najtrudniejszych wyzwań inżynieryjnych w krzemowej fotonice jest wprowadzenie fali świetlnej ze standardowego jednomodowego włókna światłowodowego o średnicy rdzenia około dziewięciu mikrometrów do miniaturowego falowodu krzemowego o wymiarach zaledwie czterystu na dwieście nanometrów. Ta gigantyczna dysproporcja geometryczna bez odpowiedniego dopasowania polowego skutkowałaby utratą ponad dziewięćdziesięciu procent mocy optycznej.
Aby rozwiązać ten problem, inżynierowie stosują dwa konkurencyjne podejścia: powierzchniowe siatki dyfrakcyjne Grating Couplers oraz sprzęgacze krawędziowe Edge Couplers z odwróconym taperem falowodowym Inverse Taper. Siatka dyfrakcyjna wytrawiona na powierzchni wafla ugina wiązkę światła padającą pod kątem kilkunastu stopni, wprowadzając ją bezpośrednio do falowodu. Główną zaletą siatek jest możliwość szybkiego testowania optycznego milionów struktur na poziomie nienaruszonego wafla krzemowego przed jego pocięciem na pojedyncze chipy, co drastycznie obniża koszty kontroli jakości.
Z kolei w aplikacjach o krytycznym bilansie energetycznym, takich jak połączenia procesorów w klastrach sztucznej inteligencji, stosuje się zaawansowane sprzęgacze krawędziowe. Falowód krzemowy na krawędzi chipu zwęża się do szerokości zaledwie kilkudziesięciu nanometrów, zmuszając mod optyczny do rozlania się w otaczający płaszcz z azotku krzemu SiN lub tlenku krzemu, którego geometria idealnie odpowiada plamce włókna światłowodowego. Sprzęgacze krawędziowe osiągają straty wtrąceniowe poniżej pół decybela w szerokim paśmie optycznym, wymagają jednak precyzyjnego montażu z użyciem manipulatorów piezoelektrycznych o dokładności pozycjonowania rzędu kilkudziesięciu nanometrów.
Integracja heterogeniczna i źródła światła: Połączenie fosforku indu z krzemem
Ponieważ krzem nie potrafi efektywnie emitować fotonów, inżynierowie musieli rozwiązać problem zintegrowania zewnętrznego źródła światła z krzemową matrycą fotoniczną. Rozwiązaniem stała się zaawansowana integracja heterogeniczna Heterogeneous Integration. Polega ona na łączeniu cienkich warstw materiałów z grupy trójkowo-piątkowej, przede wszystkim fosforku indu InP oraz arsenku galu GaAs, bezpośrednio z waflami krzemowymi SOI za pomocą wiązania molekularnego Wafer Bonding w warunkach próżni.
W ten sposób powstają zminiaturyzowane lasery ze sprzężeniem zwrotnym DFB Distributed Feedback oraz lasery oparte na zjawisku rozproszonego zwierciadła Bragga DBR, w których optyczna wnęka rezonansowa znajduje się w krzemie, a wzmocnienie optyczne zachodzi w heterostrukturze InP. Dla najwyższych reżimów niezawodności w centrach danych stosuje się również architekturę zewnętrznego źródła światła ciągłego CW-ELS Continuous Wave External Light Source. W tym podejściu moduł laserowy jest umieszczony w wymiennej kasecie na przednim panelu serwera, a światło jest dostarczane do procesora za pomocą wielomodowych włókien optycznych, co chroni wrażliwe lasery przed ekstremalnym nagrzewaniem się rdzeni obliczeniowych GPU.
Mechanizmy modulacji elektrooptycznej: Interferometry Macha-Zehndera i mikropierścienie
Samo wygenerowanie światła podczerwonego to zaledwie początek procesu transmisji. Aby przenieść dane, falę świetlną należy zmodulować strumieniem bitów cyfrowych z prędkościami przekraczającymi sto gigabaudów. W krzemowej fotonice modulacja opiera się na zjawisku dyspersji plazmowej Plasma Dispersion Effect, polegającym na zmianie współczynnika załamania światła krzemu pod wpływem zmiany koncentracji swobodnych nośników ładunku w złączu p-n.
Do niedawna standardem przemysłowym były modulatory interferometryczne Macha-Zehndera MZM Mach-Zehnder Modulators. W modulatorze MZM strumień światła jest dzielony na dwa symetryczne ramiona. Zmiana napięcia na elektrodzie jednego z ramion indukuje przesunięcie fazowe fali świetlnej. Po ponownym połączeniu strumieni dochodzi do interferencji konstruktywnej lub destruktywnej, co przekształca modulację fazy w modulację amplitudy. Choć modulatory MZM charakteryzują się znakomitą stabilnością temperaturową i szerokim pasmem pracy, ich ramiona muszą mieć długość od jednego do kilku milimetrów, co ogranicza gęstość ich upakowania na chipie.
Nową jakość wprowadziły mikropierścienie rezonansowe Micro-Ring Resonators MRR o średnicy zaledwie kilku mikrometrów. Mikropierścień działa jak ultrawąski filtr optyczny sprzężony z falowodem przelotowym. Zmiana gęstości nośników ładunku w pierścieniu powoduje przesunięcie częstotliwości rezonansowej, co pozwala na błyskawiczne włączanie i wyłączanie transmisji wybranej długości fali. Mikropierścienie MRR zajmują powierzchnię stokrotnie mniejszą niż modulatory MZM i zużywają ułamek energii, wymagają jednak precyzyjnych mikrogrzałek termicznych kompensujących wahania temperatury otoczenia z dokładnością do ułamka stopnia Celsjusza.
Zwielokrotnienie falowe WDM i przełamanie bariery bilansu energetycznego
Największą przewagą optyki nad miedzią jest możliwość bezkolizyjnego przesyłania wielu niezależnych strumieni danych w jednym kanale fizycznym za pomocą gęstego zwielokrotnienia falowego DWDM Dense Wavelength Division Multiplexing. Pojedyncze włókno optyczne lub krzemowy falowód może przenosić jednocześnie osiem, szesnaście lub trzydzieści dwie różne długości fal świetlnych w pasmach O-band lub C-band.
Każda długość fali jest modulowana niezależnie z prędkością stu gigabitów na sekundę PAM4, co pozwala pojedynczemu złączu optycznemu o szerokości zaledwie kilkunastu mikrometrów na osiągnięcie sumarycznej przepustowości rzędu kilku terabitów na sekundę. W połączeniu z technologią mikropierścieni rezonansowych układ WDM eliminuje konieczność stosowania setek równoległych miedzianych pinów transmisyjnych na krawędzi obudowy procesora, drastycznie zmniejszając wymiary chipu i eliminując wąskie gardła magistrali wejścia-wyjścia.
Co więcej, bilans energetyczny transmisji fotonicznej jest niemal niezależny od dystansu na odległościach typowych dla centrum danych, wynoszących od jednego metra do dwóch kilometrów. Podczas gdy miedziany kabel PCIe pobiera od dziesięciu do piętnastu pikodżuli na przesłany bit pJ/bit na dystansie zaledwie dwóch metrów, zintegrowane połączenia optyczne CPO obniżają ten wskaźnik do poziomu poniżej jednego pikodżula na bit, przynosząc gigantyczne oszczędności w skali klastrów liczących dziesiątki tysięcy procesorów.
Architektura Co-Packaged Optics CPO i optyczne chiplety
Przejście na fotonikę wymagało całkowitego zredefiniowania fizycznej konstrukcji procesorów serwerowych. Przez lata moduły optyczne miały formę wymiennych transceiverów wtykanych w przedni panel szafy serwerowej, co nadal zmuszało sygnał elektryczny do pokonania kilkudziesięciu centymetrów miedzianych ścieżek na płycie głównej. Architektura Co-Packaged Optics CPO eliminuje ten dystans poprzez zintegrowanie silników optycznych Optical Engines bezpośrednio w obudowie wielochipowej procesora ASIC lub GPU.
W architekturze CPO na wspólnym zaawansowanym podłożu interposera krzemowego lub szklanego w technologiach TSV Through-Silicon Via umieszcza się matrycę logiczną procesora oraz miniaturowe chiplety fotoniczne Optical I/O Chiplets, takie jak układy TeraPHY opracowane przez firmę Ayar Labs czy moduły COUPE firmy TSMC. Odległość między wyjściem układu scalonego a modulatorem optycznym zostaje zredukowana do kilku milimetrów, co pozwala na bezpośrednie sterowanie toru optycznego z wyjść cyfrowych bez konieczności stosowania energochłonnych obwodów SerDes.
Z obudowy CPO wyprowadzane są bezpośrednio wiązki mikrowłókien optycznych zakończone precyzyjnymi złączami wielowłóknowymi MPO lub złączami soczewkowymi Expanded Beam. Zapewnia to bezprecedensową gęstość krawędziową przepustowości przekraczającą jeden terabit na sekundę na milimetr obwodu obudowy, umożliwiając budowę gigantycznych klastrów o płaskiej strukturze połączeń pozbawionej opóźnień konwersji elektryczno-optycznej.
Algorytmiczne obliczenia optyczne i fotoniczne akceleratory tensorowe O-TPU
Fotonika zintegrowana w centrach danych sztucznej inteligencji przestaje być wyłącznie medium transmisyjnym i wkracza w sferę bezpośredniego wykonywania operacji matematycznych. Podstawową operacją w głębokich sieciach neuronowych jest mnożenie macierzy przez wektor, które w tradycyjnych procesorach krzemowych pochłania miliardy cykli zegarowych i gigawaty mocy. W domenie fotonicznej mnożenie macierzowe można zrealizować z prędkością światła za pomocą siatek programowalnych interferometrów Macha-Zehndera.
Zgodnie z twierdzeniem Clementsa i Recka, dowolną unitarną macierz transformacji wielowymiarowej można odwzorować w postaci trójkątnej lub prostokątnej siatki przestrajalnych rozdzielaczy wiązki i przesuwników fazowych. Wektory wejściowe są kodowane w amplitudach i fazach wiązek laserowych wstrzykiwanych do równoległych falowodów. Gdy światło propaguje się przez siatkę interferometrów, zjawiska falowej interferencji wykonują pełne mnożenie macierzowe w czasie równym fizycznemu przejściu fotonów przez układ scalony, czyli w czasie poniżej stu pikosekund.
Pionierami komercjalizacji optycznych procesorów tensorowych O-TPU są start-upy takie jak Lightmatter z układem Envise oraz Celestial AI z platformą Photonic Fabric. Chociaż analogowe obliczenia optyczne charakteryzują się niższą precyzją bitową wynoszącą od czterech do ośmiu bitów w porównaniu do klasycznego krzemu zmiennoprzecinkowego, jest to wartość w zupełności wystarczająca dla inferencji skwantowanych modeli generatywnych LLM, oferując stukrotne obniżenie poboru energii w porównaniu do najnowocześniejszych akceleratorów graficznych.
Optyczne przełączniki przestrzenne OCS i eliminacja sieci Spine-Leaf
Integracja fotoniki krzemowej na poziomie procesorów umożliwia wdrożenie kolejnej radykalnej innowacji architektonicznej: w pełni optycznych przełączników przestrzennych Optical Circuit Switching OCS. W klasycznej sieci centrum danych typu Spine-Leaf pakiety danych wędrujące między odległymi procesorami GPU muszą przejść przez kilka warstw przełączników sieciowych, z których każdy musi przekonwertować fotony na elektrony, zbuforować pakiet w pamięci RAM, podjąć decyzję routingową i ponownie przekonwertować sygnał na światło, co generuje opóźnienia i potężny pobór mocy.
Przełączniki OCS, wdrożone pioniersko przez firmę Google w klastrach akceleratorów TPU v4 i TPU v5p, eliminują warstwę elektryczną przełączników. Układ OCS wykorzystuje dwuwymiarowe macierze mikroluster MEMS Micro-Electro-Mechanical Systems zawieszonych w próżni. Lustra te obracają się w dwóch osiach pod wpływem sił elektrostatycznych, kierując wiązki światła bezpośrednio z włókna wejściowego do włókna wyjściowego w domenie czysto optycznej.
Przełącznik optyczny nie analizuje nagłówków pakietów i jest całkowicie przezroczysty dla protokołów oraz prędkości transmisji; może z równą łatwością przekazywać sygnał o przepustowości stu gigabitów, jak i jednego terabita na sekundę. Pozwala to na dynamiczną rekonfigurację topologii klastra obliczeniowego w czasie kilkunastu milisekund w zależności od specyfiki trenowanego modelu sieci neuronowej, tworząc optymalne pierścienie lub torusy trójwymiarowe bez generowania jakichkolwiek strat pakietów.
Niezawodność przemysłowa, degradacja laserów i zarządzanie bilansu cieplnym
Masowe wdrożenie fotoniki zintegrowanej w centrach danych wymaga rozwiązania bezwzględnych problemów związanych z niezawodnością materiałową i eksploatacyjną. W szafach serwerowych pracujących pod pełnym obciążeniem treningowym temperatura otoczenia wokół procesorów GPU przekracza często osiemdziesiąt pięć stopni Celsjusza. W tak ekstremalnych warunkach półprzewodnikowe diody laserowe InP wykazują gwałtowny spadek sprawności elektrooptycznej oraz przyspieszoną degradację struktury krystalicznej wywołaną migracją defektów sieciowych Dark Line Defects DLD.
Co więcej, współczynnik temperaturowy długości fali lasera wynosi około jednej dziesiątej nanometra na kelwin, co oznacza, że wahania temperatury w serwerze powodują natychmiastowe rozstrojenie źródeł światła względem wąskopasmowych mikropierścieni rezonansowych na chipie fotonicznym. Z tego powodu producenci wdrażają zaawansowane pętle cyfrowego sprzężenia zwrotnego ze zintegrowanymi czujnikami fotodiody monitorującej, które sterują prądem mikrogrzałek polikrzemowych, utrzymując rezonatory w idealnym punkcie pracy niezależnie od obciążenia obliczeniowego.
Aby wyeliminować ryzyko przestoju całego klastra w przypadku awarii pojedynczego lasera, w architekturach optycznych stosuje się redundancję typu N plus jeden. Moduły zasilania optycznego integrują zapasowe linie laserowe, które w razie wykrycia spadku mocy na wyjściu poniżej progu krytycznego są automatycznie włączane przez przełącznik optyczny w ciągu mikrosekund, gwarantując ciągłość pracy misji obliczeniowych trwających wiele tygodni bez przerwy.
Metrologia nanometrowa i automatyczne stacje testowe na poziomie wafla
Przeniesienie technologii krzemowej fotoniki ze stadium prototypów laboratoryjnych do masowej produkcji w skali milionów sztuk wymagało skonstruowania zupełnie nowej klasy urządzeń kontrolno-pomiarowych. W klasycznej mikroelektronice cyfrowej testowanie struktur krzemowych na waflu odbywa się za pomocą standardowych igieł pomiarowych wprowadzanych w pady metalizacyjne. W fotonice zintegrowanej sygnał wejściowy i wyjściowy musi mieć postać spójnej wiązki laserowej.
Wiodące fabryki półprzewodników wdrożyły zautomatyzowane stacje sondowania optycznego Wafer-Level Optical Probers. Urządzenia te wykorzystują wieloosiowe manipulatory heksapodalne oparte na silnikach piezoelektrycznych, które w ułamku sekundy pozycjonują matryce mikrowłókien światłowodowych nad siatkami dyfrakcyjnymi z dokładnością poniżej dwudziestu nanometrów. Pomiary strat wtrąceniowych, tłumienia polaryzacyjnego oraz szerokości pasma rezonansowego są wykonywane dla tysięcy układów na waflu w trybie w pełni autonomicznym.
Niezwykle krytycznym aspektem jest również kontrola czystości środowiska produkcyjnego w klasie ISO 1. Pojedyncza cząstka kurzu o średnicy trzystu nanometrów, która w tradycyjnym procesie cyfrowym mogłaby nie wywołać zwarcia, na powierzchni falowodu krzemowego działa jak potężne centrum rozpraszania optycznego, powodując całkowitą utratę sygnału w kanale transmisyjnym. Precyzyjne techniki czyszczenia laserowego oraz zaawansowana mikroskopia sił atomowych AFM stanowią niezbędny element zapewnienia wysokiego uzysku produkcyjnego Yield w procesie fotonicznym.
Materiały nowej generacji: Tytanian baru, niobian litu i grafen w fotonice
Chociaż krzemowa fotonika pozostaje fundamentem komercjalizacji ze względu na zgodność z liniami CMOS, naukowcy i inżynierowie materiałowi wprowadzają do krzemu nowe materiały o nieliniowych właściwościach optycznych, które pozwolą na pokonanie ograniczeń efektu dyspersji plazmowej. Najbardziej obiecującym materiałem jest cienkowarstwowy niobian litu Thin-Film Lithium Niobate TFLN oraz tytanian baru BaTiO3 BTO.
Niobian litu charakteryzuje się potężnym współczynnikiem elektrooptycznym Pockelsa, który pozwala na bezpośrednią zmianę współczynnika załamania światła za pomocą zewnętrznego pola elektrycznego bez konieczności wprowadzania swobodnych nośników ładunku. Oznacza to, że modulatory TFLN mogą pracować przy częstotliwościach przekraczających sto gigaherców przy niemal zerowych stratach absorpcyjnych i znikomym nagrzewaniu się obwodu. Zintegrowanie heterogenicznych warstw TFLN na podłożach krzemowych SOI otwiera drogę do budowy transiwerów o prędkościach przekraczających 1,6 terabita na sekundę na pojedynczy moduł chipletowy.
Równolegle trwają badania nad wykorzystaniem grafenu oraz dichalkogenków metali przejściowych TMDC jako ultracienkich fotodetektorów i modulatorów szerokopasmowych. Monowarstwy grafenu osadzone na falowodach krzemowych wykazują ultraszybką odpowiedź optoelektroniczną w pełnym zakresie widmowym od widzialnego po daleką podczerwień, umożliwiając stworzenie fotodetektorów o pasmie przenoszenia sięgającym pięciuset gigaherców, co zaspokoi potrzeby telekomunikacji optycznej w perspektywie kolejnych dwóch dekad.
Geopolityka łańcucha dostaw optoelektroniki i standaryzacja UCIe
Rozwój fotoniki zintegrowanej przestał być wyłącznie kwestią czysto techniczną i stał się areną zaciętej rywalizacji geopolitycznej między Stanami Zjednoczonymi, Unią Europejską a Chinami. Zdolność do budowy wielkoskalowych klastrów sztucznej inteligencji o niskim śladzie węglowym zależy bezpośrednio od dostępu do zaawansowanych linii produkcyjnych fotoniki krzemowej oraz zaawansowanych obudów wielochipowych.
Stany Zjednoczone zainwestowały miliardy dolarów w ramach programu CHIPS Act w rozwój krajowych kompetencji w zakresie zaawansowanego pakowania CPO, wspierając ekosystem wokół konsorcjum UCIe Universal Chiplet Interconnect Express oraz Optical Internetworking Forum OIF. Standard UCIe definiuje otwarte protokoły komunikacyjne i interfejsy fizyczne pozwalające na łączenie chipletów obliczeniowych wykonanych w najbardziej zaawansowanych węzłach litograficznych dwóch nanometrów z chipletami optycznymi wytwarzanymi w tańszych, starszych technologiach mikrofalowych.
Unia Europejska, opierając się na badaniach instytutów takich jak imec w Belgii oraz CEA-Leti we Francji, rozwija własne niezależne linie pilotażowe fotoniki scalonej, dążąc do utrzymania suwerenności technologicznej w segmencie infrastruktury telekomunikacyjnej. Tymczasem Chiny, odcięte przez zachodnie sankcje od najnowocześniejszych maszyn litograficznych EUV do produkcji klasycznych tranzystorów krzemowych, upatrują w fotonice zintegrowanej szansy na obejście embarga, intensywnie dotując państwowe zakłady w Wuhanie i Szanghaju rozwijające procesory optoelektroniczne.
Przejście od elektronów do fotonów wewnątrz serwerów to największa rewolucja w architekturze sprzętu komputerowego od czasu wynalezienia układu scalonego przez Roberta Noyce'a i Jacka Kilby'ego. Zastąpienie miedzianych magistrali przez krzemowe falowody optyczne, modulację wielofalową WDM oraz architekturę Co-Packaged Optics pozwala na przełamanie barier przepustowości i poboru mocy, które groziły zatrzymaniem rewolucji sztucznej inteligencji. Fotoniczne układy scalone stają się krwioobiegiem przyszłości superkomputerów, bez którego dalszy rozwój cywilizacji cyfrowej byłby niemożliwy.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.