
Fotoniczne układy scalone PIC i optyczne akceleratory sztucznej inteligencji: Jak interferometry Macha-Zehndera, fotonika krzemowa i obliczenia z prędkością światła przełamują barierę poboru mocy w klastrach wielkich modeli językowych
Fizyczne granice elektroniki i kryzys energetyczny centrów danych
Współczesna rewolucja generatywnej sztucznej inteligencji doprowadziła globalną infrastrukturę obliczeniową do punktu krytycznego, w którym tradycyjne krzemowe procesory graficzne i dedykowane akceleratory tensorowe zderzają się z nieprzekraczalnymi prawami fizyki półprzewodników. Skalowanie modeli językowych liczących setki miliardów parametrów wymaga łączenia dziesiątek tysięcy układów scalonych w potężne klastry, których zapotrzebowanie na energię elektryczną zaczyna rywalizować ze zużyciem średniej wielkości aglomeracji miejskich. Głównym źródłem strat energetycznych w architekturach elektronicznych nie są same elementarne operacje przełączania bramek logicznych, lecz pasożytnicza pojemność i opór omowy metalicznych połączeń transmisyjnych. Każde przesłanie bitu informacji wzdłuż miedzianej ścieżki na płytce krzemowej lub magistrali międzysystemowej wiąże się z cyklicznym ładowaniem i rozładowywaniem mikroskopijnych pojemności RC, co zgodnie z prawem Joule'a przekształca bezcenną energię w ciepło odpadowe. Gdy częstotliwości taktowania i przepustowości interkonektów przekraczają granice setek gigaherców, straty dielektryczne i efekt naskórkowy w przewodnikach miedzianych wymuszają stosowanie agresywnych korektorów sygnału i wzmacniaczy, które same w sobie konsumują znaczącą część budżetu energetycznego akceleratora.
Zjawisko to, powszechnie określane mianem ściany termicznej oraz kryzysu interkonektów, stawia pod znakiem zapytania dalsze skalowanie systemów uczących się w oparciu o czysto elektroniczne paradygmaty przetwarzania danych. Gęstość mocy w najnowocześniejszych węzłach litograficznych zbliża się do wartości obserwowanych w rdzeniach reaktorów jądrowych, co zmusza projektantów centrów danych do wdrażania skomplikowanych i kosztownych systemów bezpośredniego chłodzenia cieczą oraz instalacji kriogenicznych. Co więcej, przepustowość magistrali łączących jednostki arytmetyczno-logiczne z pamięcią HBM nie nadąża za apetytem jednostek obliczeniowych na dane wejściowe, co tworzy strukturalne wąskie gardło von Neumanna na poziomie wielochipowym. W tym kontekście technologia fotonicznych układów scalonych, określanych akronimem PIC od angielskiego Photonic Integrated Circuits, przestaje być wyłącznie akademickim eksperymentem, stając się strategiczną koniecznością dla całego sektora zaawansowanych technologii cyfrowych. Wykorzystanie fotonów zamiast elektronów jako nośników informacji elementarnej pozwala na ominięcie fundamentalnych ograniczeń pojemnościowych i rezystancyjnych, otwierając drogę do przetwarzania z prędkością propagacji światła w dielektryku.
Propagacja fali elektromagnetycznej w odpowiednio zaprojektowanym falowodzie krzemowym charakteryzuje się brakiem oporu omowego i minimalnymi stratami rozproszeniowymi, co eliminuje zależność strat energetycznych od dystansu i częstotliwości modulacji w stopniu niespotykanym w metalach. W przeciwieństwie do elektronów, które wykazują silne oddziaływania kulombowskie i wzajemne odpychanie, fotony jako bozony mogą poruszać się w tym samym medium bez generowania zjawisk interferencji destruktywnej, o ile różnią się długością fali lub stanem polaryzacji. Ta unikalna właściwość pozwala na jednoczesne przesyłanie wielu niezależnych strumieni danych wzdłuż pojedynczej ścieżki optycznej za pośrednictwem gęstego zwielokrotnienia falowego WDM. Zastosowanie fotoniki w obszarze algebry liniowej, która stanowi absolutny fundament współczesnych architektur uczenia głębokiego, pozwala na przekształcenie najbardziej zasobożernych operacji matematycznych w zjawiska natury falowej, zachodzące w czasie rzeczywistym bez konieczności buforowania w rejestrach elektronicznych.
Matematyka fali świetlnej i siatki interferometrów Macha-Zehndera
Sercem fotonicznych akceleratorów sztucznej inteligencji są programowalne siatki interferometrów Macha-Zehndera, znanych w literaturze specjalistycznej jako MZI. Aby zrozumieć, w jaki sposób zjawiska optyczne realizują mnożenie macierzy przez wektor, należy przyjrzeć się matematycznemu opisowi przejścia fali świetlnej przez pojedynczą komórkę interferometryczną. Pojedynczy interferometr MZI składa się z dwóch kierunkowych sprzęgaczy optycznych o podziale mocy pięćdziesiąt na pięćdziesiąt procent oraz dwóch równoległych ramion falowodowych, z których przynajmniej jedno wyposażone jest w precyzyjny przesuwnik fazowy. Wiązka światła o określonej amplitudzie i fazie początkowej wchodzi do pierwszego sprzęgacza, gdzie zostaje podzielona na dwie równe części propagujące się wzdłuż niezależnych ramion. Na jednym z ramion następuje modyfikacja współczynnika załamania światła materiału falowodu, co wywołuje kontrolowane przesunięcie fazowe fali przed jej ponownym połączeniem w drugim sprzęgaczu kierunkowym.
W zależności od różnicy faz między dwiema falami, na wyjściach interferometru zachodzi zjawisko konstruktywnej lub destruktywnej interferencji, co w kategoriach macierzowych odpowiada mnożeniu wektora wejściowego przez dwuwymiarową macierz unitarną transformacji SU(2). Zmieniając fazę sygnału w ramieniu interferometru, operator może płynnie regulować stosunek mocy światła trafiającego do poszczególnych wyjść, co odpowiada ciągłej regulacji wag wagowych w sztucznej sieci neuronowej. Przełomem w zastosowaniu tej technologii do zadań głębokiego uczenia było odkrycie uniwersalnych algorytmów dekompozycji macierzy, opracowanych pierwotnie przez zespół Michaela Recka, a następnie udoskonalonych przez Davida Clemensa. Dowiedli oni, że dowolną n-wymiarową macierz unitarną opisującą wielowymiarową przestrzeń wag neuronowych można zredukować do regularnej, trójkątnej lub prostokątnej siatki dwuportowych interferometrów Macha-Zehndera połączonych kaskadowo.
W praktycznej realizacji oznacza to, że wektor sygnałów wejściowych kodowany jest w postaci amplitud i faz fal świetlnych wprowadzanych równolegle do wielu falowodów wejściowych układu fotonicznego. Światło rozchodzi się wewnątrz krzemowej siatki interferometrów z prędkością zależną od efektywnego współczynnika załamania falowodu, pokonując całą matrycę obliczeniową w czasie rzędu kilkudziesięciu pikosekund. Gdy czoło fali dociera do wyjść układu scalonego, natężenie promieniowania zarejestrowane przez fotodiody p-i-n lub lawinowe odpowiada wynikowi pomnożenia wektora danych wejściowych przez zaprogramowaną uprzednio macierz wag modelu. Cała operacja mnożenia macierzowo-wektorowego GEMM, która na klasycznych procesorach graficznych wymaga milionów cykli zegarowych i ciągłego transferu ładunków w tranzystorach, w domenie optycznej realizowana jest w jednym ciągłym akcie fizycznej propagacji falowej bez pobierania dodatkowej energii z zasilacza w trakcie samego przejścia światła.
Pobór mocy w siatkach MZI ogranicza się wyłącznie do podtrzymania zadanego stanu przesuwników fazowych oraz konwersji sygnałów na styku fotoniki i elektroniki. Tradycyjne przesuwniki termooptyczne wykorzystują mikroskopijne grzałki metaliczne umieszczone nad falowodem, które poprzez lokalną zmianę temperatury modyfikują współczynnik załamania krzemu w oparciu o efekt termooptyczny. Choć rozwiązanie to charakteryzuje się wysoką stabilnością i precyzją, pobór mocy grzałek rzędu kilkunastu miliwatów na pojedynczy węzeł przy matrycach zawierających dziesiątki tysięcy interferometrów tworzy znaczący balast cieplny. Z tego powodu najnowocześniejsze fotoniczne procesory tensorowe przechodzą na przesuwniki elektrooptyczne oparte na zjawisku dyspersji nośników plazmowych w złączach p-n lub wykorzystujące heterogeniczne warstwy ferroelektryczne, takie jak tytanian baru BTO oraz niobian litu na izolatorze LNOI. Materiały te charakteryzują się liniowym efektem Pockelsa, pozwalając na zmianę fazy światła za pomocą pola elektrycznego niemal bezprzepływowo, co redukuje zużycie energii do poziomu attożeli na pojedynczy piksel obliczeniowy.
Heterogeniczna integracja i fotonika krzemowa w skali przemysłowej
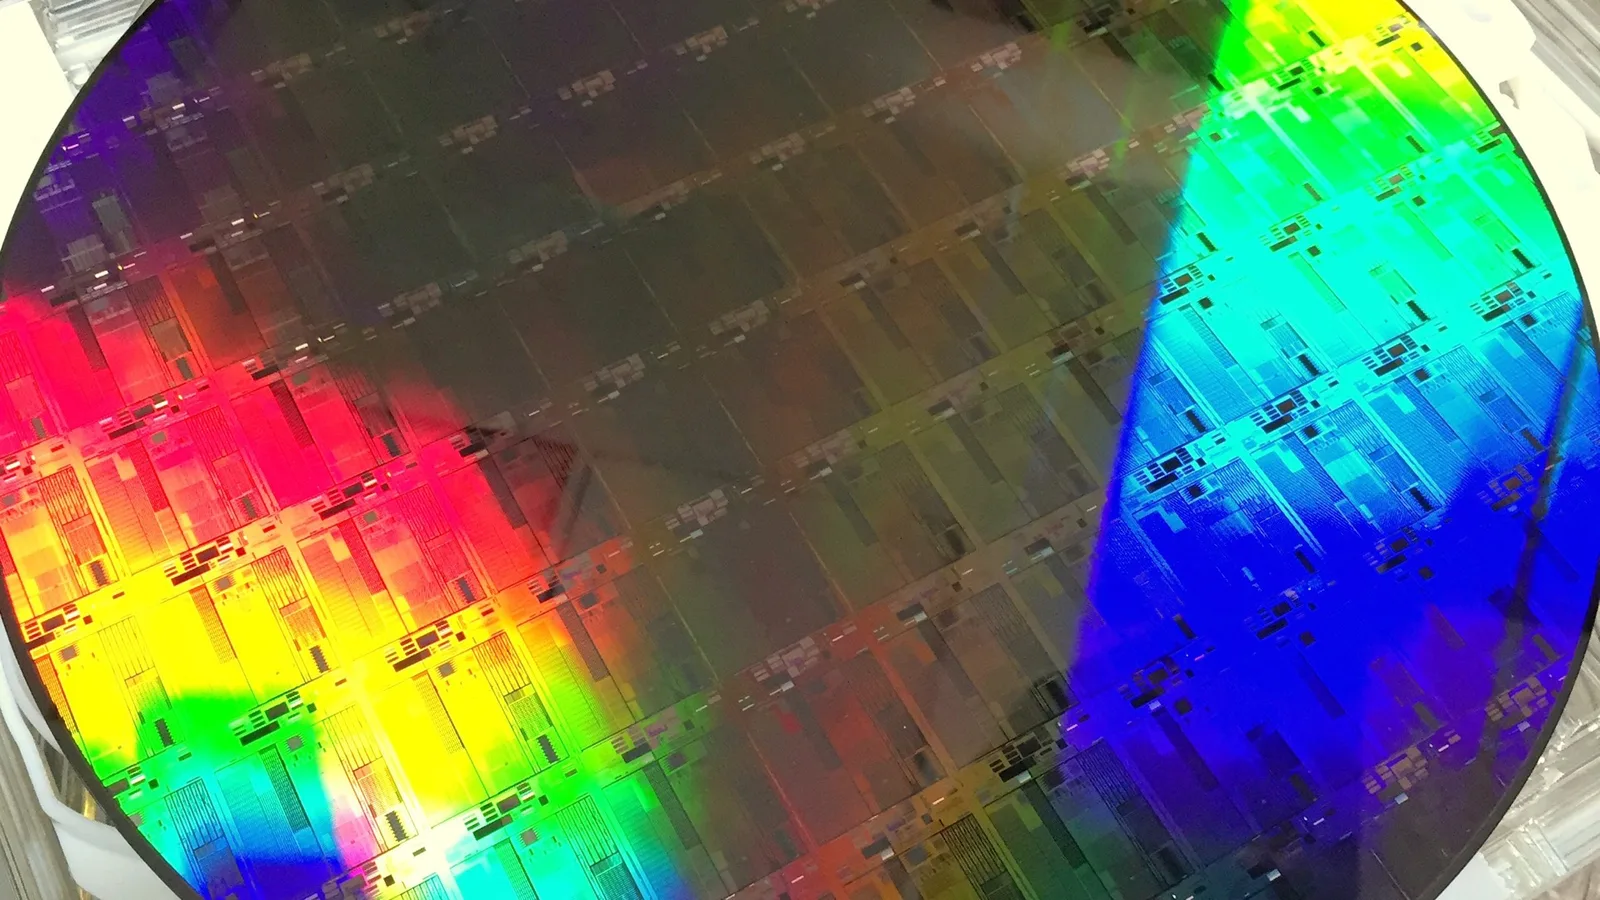
Krzem jako pierwiastek czternastej grupy układu okresowego jest materiałem o skośnej przerwie energetycznej, co w praktyce oznacza, że elektrony rekombinujące z dziurami w sieci krystalicznej oddają nadmiar energii w postaci fononów, czyli drgań cieplnych sieci, zamiast emitować fotony. Ta fundamentalna właściwość kwantowa sprawia, że krzem jest doskonałym medium do budowy pasywnych falowodów, rozdzielaczy i modulatorów, lecz nie nadaje się do tworzenia wydajnych, monolitycznych źródeł światła laserowego. Przez dziesięciolecia brak zintegrowanego lasera na krzemie stanowił barierę nie do pokonania dla masowej produkcji fotonicznych procesorów w standardowych fabrykach półprzewodników CMOS. Rozwiązaniem tego impasu okazała się zaawansowana heterogeniczna integracja materiałów grupy III-V, takich jak fosforek indu InP oraz arsenek galu GaAs, bezpośrednio na powierzchni podłoży krzemowych SOI za pomocą technologii bezpośredniego łączenia molekularnego na poziomie całych wafli.
W nowoczesnych procesach produkcyjnych mikroskopijne struktury laserowe ze sprzężeniem zwrotnym DFB lub lasery oparte na kropkach kwantowych QD są integrowane hybrydowo z falowodami krzemowymi z dokładnością poniżej stu nanometrów. Generowane światło laserowe jest bezstratnie przekazywane z warstwy aktywnej materiału III-V do falowodu krzemowego za pośrednictwem zjawiska fali gasnącej i sprzężenia adiabatycznego. Dzięki temu możliwe jest wytwarzanie na jednym monolicie krzemowym zarówno dziesiątek stabilnych źródeł koherentnego promieniowania o ściśle określonych długościach fal, jak i rozległych siatek obliczeniowych oraz matryc fotodetektorów germanowych. Zastosowanie germanu, który posiada bezpośrednie przejście pasmowe w zakresie telekomunikacyjnym, pozwala na budowę ultraszybkich fotodiod o pasmie modulacji przekraczającym sto gigaherców, co gwarantuje natychmiastową zamianę przetworzonych sygnałów optycznych na równoległe sygnały elektryczne.
Ogromnym atutem fotoniki krzemowej jest pełna kompatybilność procesowa z istniejącymi liniami produkcyjnymi fabryk litograficznych pracujących w standardzie trzystu milimetrów. Zastosowanie głębokiego ultrafioletu DUV o długości fali sto dziewięćdziesiąt trzy nanometry pozwala na precyzyjne trawienie struktur falowodowych o wymiarach poprzecznych rzędu czterystu pięćdziesięciu na dwieście dwadzieścia nanometrów z minimalną chropowatością ścianek bocznych. Kontrola chropowatości na poziomie pojedynczych atomów ma kluczowe znaczenie, ponieważ wszelkie nieregularności powierzchni granicznej między rdzeniem krzemowym a płaszczem z dwutlenku krzemu wywołują zjawisko rozpraszania Rayleigha, które dramatycznie zwiększa tłumienność fali optycznej. Dzięki opanowaniu chemicznego polerowania planarnego CMP oraz precyzyjnego trawienia plazmowego RIE, współczesne komercyjne platformy fotoniczne osiągają tłumienie na poziomie poniżej jednego decybela na centymetr długości falowodu, co umożliwia konstruowanie struktur optycznych o długości całkowitej mierzonej w metrach na powierzchni pojedynczego procesora.
Kolejnym filarem skalowalności jest technologia mikrorezonatorów pierścieniowych, czyli mikroskopijnych pętli falowodowych o promieniu zaledwie kilku mikrometrów, umieszczonych w bliskim sąsiedztwie głównego toru transmisyjnego. Rezonatory te charakteryzują się niezwykle wysoką dobrocią optyczną Q i reagują wyłącznie na ściśle określoną długość fali spełniającą warunek rezonansu konstruktywnego. Poprzez minimalną zmianę współczynnika załamania rezonatora za pomocą zintegrowanej diody p-i-n można błyskawicznie włączać lub wyłączać transmisję danego kanału optycznego, realizując funkcję modulatora o skrajnie małym poborze mocy rzędu femtożeli na bit. Architektury oparte na rezonatorach pierścieniowych pozwalają na upakowanie setek kanałów obliczeniowych na ułamku milimetra kwadratowego powierzchni krzemu, stanowiąc kompaktową alternatywę dla obszernych interferometrów Macha-Zehndera w zastosowaniach wymagających ekstremalnej gęstości upakowania logiki.
Architektura Co-Packaged Optics i przełamywanie barier interkonektów
Nawet najbardziej wyrafinowany optyczny rdzeń obliczeniowy traci rację bytu, jeśli transfer danych pomiędzy domeną optyczną a cyfrową elektroniką sterującą wiąże się ze stratami niweczącymi uzyskane korzyści. W klasycznych rozwiązaniach wtykowe moduły optyczne umieszczane były na krawędziach płyt głównych serwerów, co wymuszało prowadzenie sygnałów elektrycznych o wysokiej częstotliwości przez kilkudziesięciocentymetrowe ścieżki laminatu drukowanego PCB. Na tym dystansie sygnał elektryczny ulegał gwałtownej degradacji, wymuszając stosowanie prądożernych układów re-timerów i wzmacniaczy sygnału. Odpowiedzią przemysłu na ten problem stała się rewolucyjna koncepcja zaawansowanego pakowania optycznego, znana jako Co-Packaged Optics lub w skrócie CPO. W architekturze CPO matryce fotoniczne PIC oraz cyfrowe procesory obliczeniowe ASIC lub GPU montowane są bezpośrednio obok siebie na wspólnym, zaawansowanym interpozerze krzemowym lub organicznym wewnątrz tej samej obudowy układu scalonego.
Zastosowanie bezpośredniego łączenia hybrydowego miedź-miedź oraz mikroskopijnych mikro-wybrzuszeń o rastrze poniżej dziesięciu mikrometrów pozwala na skrócenie elektrycznych ścieżek transmisyjnych z kilkudziesięciu centymetrów do ułamków milimetra. Na tak mikroskopijnym dystansie pasożytnicza pojemność linii spada o kilka rzędów wielkości, co eliminuje konieczność stosowania złożonych korektorów sygnału i pozwala na bezpośrednie sterowanie modulatorami optycznymi przez logikę cyfrową przy minimalnych poziomach napięć logicznych. Integracja w standardzie CPO umożliwia osiągnięcie łącznej przepustowości interfejsów wejścia-wyjścia na poziomie przekraczającym pięćdziesiąt jeden terabitów na sekundę z pojedynczej obudowy procesora, przy jednoczesnym obniżeniu jednostkowego zużycia energii poniżej dwóch pikodżuli na przesłany bit danych. Dla porównania, konwencjonalne magistrale elektryczne miedziane pracujące z szybkościami rzędu stu gigabitów na linię zużywają od dziesięciu do dwudziestu pikodżuli na bit, co w skali klastra zawierającego tysiące procesorów przekłada się na gigantyczne oszczędności mocy liczone w megawatach.
Równolegle z rozwojem CPO inżynierowie mierzą się z wyzwaniem stabilizacji termicznej układów optycznych. W przeciwieństwie do krzemu elektronicznego, który zachowuje poprawność logiczną w szerokim zakresie temperatur roboczych, parametry elementów fotonicznych wykazują niezwykle silną zależność temperaturową. Zmiana temperatury o ułamek stopnia Celsjusza prowadzi do dryfu współczynnika załamania światła i przesunięcia długości fali rezonansowej interferometrów oraz rezonatorów pierścieniowych, co grozi całkowitą utratą kalibracji wag w sieci neuronowej. Aby temu zapobiec, nowoczesne akceleratory PIC wyposaża się w zintegrowane układy sprzężenia zwrotnego, wykorzystujące wbudowane fotodiody monitorujące oraz cyfrowe pętle PLL do ciągłej kompensacji dryfu termicznego w czasie rzeczywistym. Zaawansowane algorytmy sterowania dynamicznie korygują napięcia polaryzacji przesuwników fazowych, zapewniając niezmienną dokładność obliczeniową nawet w warunkach gwałtownych skoków obciążenia obliczeniowego serwera.
Kluczowym elementem całego ekosystemu optycznego są również przetworniki cyfrowo-analogowe DAC oraz analogowo-cyfrowe ADC o ultrawysokiej rozdzielczości czasowej i precyzji rzędu ośmiu do szesnastu bitów. Przetworniki te muszą próbkować sygnały z częstotliwościami sięgającymi dziesiątek gigaherców, aby nadążyć za optycznym torem transmisyjnym, nie stając się wąskim gardłem całej architektury. Współczesne badania skupiają się na redukcji złożoności przetworników poprzez bezpośrednie kodowanie wag i aktywacji w stanach kwantowych lub fazowych impulsów świetlnych, co pozwala na przeniesienie części operacji nieliniowych, takich jak funkcje aktywacji ReLU czy GELU, bezpośrednio do domeny optycznej za pomocą nieliniowych zjawisk optycznych w falowodach o wysokim współczynniku nieliniowości Kerra.
Hybrydowa przyszłość i konwergencja optyczno-cyfrowa
Wbrew wczesnym, entuzjastycznym prognozom głoszącym rychły i całkowity koniec tradycyjnej elektroniki krzemowej, przyszłość wielkoskalowej sztucznej inteligencji nie będzie należeć do komputerów czysto fotonicznych, lecz do głęboko zintegrowanych architektur hybrydowych. Zjawiska optyczne wykazują bezkonkurencyjną przewagę w operacjach liniowych, takich jak mnożenie macierzy przez wektor, dyskretne transformaty Fouriera czy konwolucje, gdzie brak opóźnień i równoległość falowa pozwalają na oszczędność tysięcy watów mocy. Z kolei elektronika cyfrowa pozostaje bezdyskusyjnym liderem w realizacji precyzyjnych operacji logicznych, zarządzaniu wskaźnikami pamięci, sterowaniu przepływem instrukcji oraz realizacji ostrych nieliniowości matematycznych. Optymalna architektura przyszłości to koprocesor, w którym warstwa elektroniczna zarządza strukturą sieci i funkcjami nieliniowymi, podczas gdy potężne, gęste bloki algebry liniowej oddelegowywane są do wyspecjalizowanych matryc fotonicznych.
Taki hybrydowy model obliczeniowy staje się fundamentem nowej generacji superkomputerów przeznaczonych do trenowania modeli typu frontier AI. Dzięki zastosowaniu optycznych matryc GEMM czas trwania pojedynczego kroku propagacji w przód i w tył ulega skróceniu o rząd wielkości, co umożliwia skalowanie rozmiarów modeli do poziomów wcześniej nieosiągalnych ze względu na ograniczenia czasowe i finansowe treningu. Co równie istotne, fotonika eliminuje zjawisko opóźnienia komunikacyjnego na poziomie całego klastra. Poprzez bezpośrednie łączenie chipletów obliczeniowych optycznymi światłowodami bez pośrednictwa konwencjonalnych przełączników pakietowych ethernetowych, pamięć rozproszona tysięcy węzłów staje się widziana jako jedna, spójna przestrzeń adresowa o niemal zerowym czasie dostępu, co ostatecznie likwiduje barierę komunikacyjną ograniczającą algorytmy równoległości tensora i rurociągu.
Ekonomiczne i geopolityczne konsekwencje przejścia na akcelerację fotoniczną są trudne do przecenienia. Państwa i korporacje, które zdołają opanować technologie zintegrowanej fotoniki krzemowej i zaawansowanego pakowania CPO, zyskają decydującą przewagę w wyścigu po dominację technologiczną. Ograniczenie zużycia energii centrów danych AI ma fundamentalne znaczenie nie tylko dla rentowności komercyjnych usług chmurowych, lecz także dla globalnej stabilności sieci elektroenergetycznych stojących w obliczu transformacji dekarbonizacyjnej. Przeniesienie ciężaru obliczeń ze spowalniających elektronów na bezmasowe fotony jest najbardziej obiecującym kierunkiem rozwoju fizyki komputerowej w XXI wieku, zapewniającym dalszą ciągłość rozwoju sztucznej inteligencji poza granicami klasycznego prawa Moore'a.
Precyzja numeryczna i wyzwania kalibracji matryc optycznych
Jednym z najczęściej podnoszonych zagadnień w debacie nad praktyczną użytecznością procesorów fotonicznych w zastosowaniach produkcyjnych jest kwestia precyzji numerycznej i odporności na zakłócenia analogowe. W klasycznych procesorach cyfrowych reprezentacja liczb opiera się na arytmetyce zmiennoprzecinkowej o ściśle zdefiniowanych standardach, takich jak FP32, FP16, a w ostatnich latach zyskujące ogromną popularność formaty o obniżonej precyzji, w tym FP8 czy mikroskopijne formaty mikroskalowe FP4. W układzie fotonicznym przetwarzanie sygnałów odbywa się w sposób w pełni analogowy, co oznacza, że wartości wag oraz aktywacji są reprezentowane przez ciągłe wielkości fizyczne, takie jak amplituda, faza czy natężenie fali elektromagnetycznej. Wszelkie niedoskonałości fizycznej struktury falowodu, szumy śrutowe fotonów, fluktuacje termiczne oraz niedoskonałości zintegrowanych fotodetektorów bezpośrednio przekładają się na błędy numeryczne w wynikach operacji mnożenia macierzy.
Wczesne prototypy optycznych układów tensorowych borykały się z efektywną liczbą bitów ENOB na poziomie zaledwie czterech do sześciu bitów, co drastycznie ograniczało ich zastosowanie do prostych zadań klasyfikacyjnych i uniemożliwiało precyzyjny trening wielkich modeli językowych wrażliwych na kumulację błędów gradientowych. Przełom ostatnich miesięcy polega na wdrożeniu nowatorskich technik kwantyzacji świadomej sprzętu oraz architektur hybrydowych z nadpróbkowaniem sygnału. Zamiast dążyć do uzyskania laboratoryjnej precyzji szesnastu bitów w pojedynczym kanale optycznym, inżynierowie stosują dekompozycję wag na sumy składowych o niższej precyzji, realizowanych równolegle na wielu długościach fal za pośrednictwem gęstego zwielokrotnienia WDM. Wyniki cząstkowe są sumowane w domenie optycznej lub na poziomie przetworników analogowo-cyfrowych z zachowaniem pełnej dynamiki sygnału, co pozwala na osiągnięcie efektywnej precyzji odpowiadającej formatowi INT8 oraz FP8 bez straty dokładności inferencyjnej modelu językowego.
Niezwykle istotnym elementem stabilizacji optycznych koprocesorów jest również dynamiczne uczenie kompensacyjne, w którym drobne wady produkcyjne siatki interferometrów oraz lokalne naprężenia mechaniczne krzemu są uwzględniane bezpośrednio w procesie programowania wag. Zamiast wymuszać idealną geometryczną symetrię każdego ramienia interferometrycznego, co w masowej skali produkcyjnej prowadzi do dramatycznego spadku uzysku dobrych struktur z wafla, algorytmy kalibracyjne dokonują wirtualnego mapowania nieidealności fizycznej matrycy. Zaawansowane optymalizatory matematyczne znajdują taki zestaw faz roboczych dla poszczególnych przesuwników, który kompensuje wady sąsiednich węzłów, przywracając globalną unitarność całej transformacji macierzowej. W ten sposób fotonika krzemowa adaptuje metody znane z cyfrowej teorii sterowania adaptacyjnego, przekształcając fizyczne ograniczenia analogowego medium w kontrolowane parametry układu obliczeniowego nowej generacji.
Czytaj również w dziale Sztuczna Inteligencja

Architektury Reasoning i Test-Time Compute w generatywnej sztucznej inteligencji: Jak przeszukiwanie drzewa myśli MCTS i procesowe modele nagrody PRM przełamują prawa skalowania Chinchilla

Modele Foundation w robotyce humanoidalnej i uczenie ze sprzężeniem VLA: Jak architektury Vision-Language-Action oraz policyjne sieci dyfuzyjne przełamują paradoks Moraveca

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.