
Wojna o pamięć HBM4 i interkonekty CXL: Dlaczego przepustowość pamięci, hybrydowe łączenie Cu-Cu i zaawansowane pakowanie decydują o dominacji w klastrach AI
Przez ponad cztery dekady rozwój architektury komputerowej napędzany był klasycznym skalowaniem Dennarda oraz prawem Moore’a, które gwarantowały wykładniczy wzrost gęstości tranzystorów i częstotliwości taktowania jednostek logicznych. Jednakże w architekturze von Neumanna przetwarzanie danych i ich przechowywanie pozostają odseparowane fizyczną magistralą komunikacyjną. Podczas gdy teoretyczna wydajność arytmetyczna procesorów graficznych GPU i akceleratorów tensorycznych TPU rosła w tempie kilkudziesięciu procent rocznie, przepustowość pamięci operacyjnej DRAM oraz energii wymaganej do przesłania pojedynczego bajta informacji zwiększała się w tempie znacznie wolniejszym. Zjawisko to, zdefiniowane w literaturze naukowej jako ściana pamięci memory wall, w dobie generatywnej sztucznej inteligencji i modeli transformerowych z setkami miliardów parametrów stało się fundamentalnym ograniczeniem rozwoju cywilizacji cyfrowej.
Współczesne modele językowe podczas fazy wnioskowania oraz trenowania wymagają nieustannego przesyłania bilionów wag synaptycznych oraz wektorów uwagi attention matrix między pamięcią dynamiczną a jednostkami wykonawczymi mnożenia macierzy GEMM. Kiedy procesor o mocy obliczeniowej rzędu tysięcy teraflopów spędza ponad siedemdziesiąt procent czasu cyklu maszynowego w stanie oczekiwania na dostarczenie danych z zewnętrznych modułów pamięci, tradycyjne podejście oparte na magistralach DDR5 czy GDDR6 staje się ekonomicznym i energetycznym absurdem. Odpowiedzią przemysłu półprzewodnikowego stała się pamięć o wysokiej przepustowości HBM od High Bandwidth Memory, która w nadchodzącej generacji HBM4 przekształca się ze standardowego podzespołu magazynującego dane w wysoce zintegrowany, trójwymiarowy heterogeniczny system obliczeniowy.
Od HBM1 do HBM3E: Ewolucja stosów pamięciowych i fizyczne granice microbumps
Koncepcja pamięci HBM, zapoczątkowana ponad dekadę temu przez konsorcjum firm SK Hynix i AMD, opierała się na radykalnej rezygnacji z długich ścieżek na laminacie płytki drukowanej PCB na rzecz pionowego układania struktur krzemowych DRAM jedna na drugiej w stosy 3D. Kluczowym elementem umożliwiającym komunikację pionową stały się przelotki krzemowe TSV od Through-Silicon Vias, czyli mikroskopijne kanały wytrawiane w strukturze kryształu krzemu i wypełniane galwanicznie miedzią. W połączeniu z krzemowym interposerem o submikronowej litografii, umieszczonym bezpośrednio na podłożu organicznym, pamięć HBM zaoferowała szeroką szynę danych o szerokości tysiąca dwudziestu czterech bitów na pojedynczy stos, co stanowiło szesnastokrotność szerokości pojedynczego kanału pamięci GDDR.
Ewolucja standardu przez generacje HBM2, HBM2E, HBM3 aż po współczesny HBM3E pozwoliła na osiągnięcie przepustowości przekraczającej 1.2 terabajta na sekundę na pojedynczy stos przy taktowaniu rzędu dziewięciu gigabitów na sekundę na pin. Osiem stosów HBM3E rozmieszczonych wokół monolitycznego lub modularnego procesora AI zapewnia zagregowaną przepustowość przekraczającą dziesięć terabajtów na sekundę przy pojemności pamięci sięgającej niemal trzystu gigabajtów. Jednakże w generacji HBM3E dotychczasowa technologia łączenia poszczególnych warstw pamięciowych natrafiła na nieprzekraczalną barierę fizyczną.
Tradycyjne łączenie warstw opierało się na technologii mikrokulek lutowniczych zwanych microbumps, wykonanych ze stopów miedzi, niklu i cyny. W procesie termokompresji NCF z folią nieprzewodzącą lub lutowania rozpływowego z ciekłym wypełnieniem kapilarnym MR-MUF, stosowanym z ogromnym sukcesem przez SK Hynix, mikro-kulki ulegały stopieniu, tworząc połączenie elektryczne między polami kontaktowymi sąsiednich struktur krzemowych. Kiedy jednak podziałka między stykami bump pitch spadła poniżej dwudziestu pięciu mikrometrów, zjawisko mostkowania cyny, powstawania pustek gazowych oraz wzrostu oporu pasożytniczego zaczęło drastycznie obniżać uzysk produkcyjny, uniemożliwiając dalsze zwiększanie liczby warstw do szesnastu w ramach standardowego limitu wysokości obudowy.
HBM4 i podwojenie szyny do 2048 bitów: Rewolucja interfejsu
Ogłoszony przez organizację JEDEC standard HBM4 stanowi najbardziej rewolucyjną zmianę architektoniczną w historii technologii pamięciowych. Fundamentalną innowacją jest podwojenie szerokości szyny danych z tysiąca dwudziestu czterech do dwóch tysięcy czterdziestu ośmiu bitów na stos. Podwojenie liczby równoległych linii sygnałowych pozwala na uzyskanie gigantycznego skoku przepustowości bez konieczności windowania częstotliwości taktowania do poziomów generujących niestabilność sygnałową i gigantyczne straty mocy na przełączaniu pojemności pasożytniczych.
Przy szerokości szyny 2048 bitów pojedynczy stos HBM4 osiąga przepustowość przekraczającą 2.5 do 3 terabajtów na sekundę. W układzie akceleratora AI nowej generacji, wyposażonego w sześć do ośmiu stosów szesnastowarstwowych HBM4 o pojemności sześćdziesięciu czterech gigabajtów każdy, sumaryczna przepustowość pamięci przekroczy dwadzieścia terabajtów na sekundę przy łącznej pamięci operacyjnej sięgającej pół terabajta na jednym module obliczeniowym. Oznacza to, że cały model o wielkości kilkuset miliardów parametrów w formacie szesnastobitowym FP16 może rezydować bezpośrednio w pamięci podręcznej akceleratora, eliminując konieczność kosztownej komunikacji międzysystemowej podczas pojedynczych kroków wnioskowania.
Tak potężna szyna danych wymusiła jednak całkowite przeprojektowanie matrycy bazowej stosu, określanej w branży jako Base Die lub Buffer Die. W poprzednich generacjach matryca bazowa była produkowana w tych samych, dojrzałych procesach litograficznych DRAM o wymiarze kilkunastu nanometrów. W HBM4 matryca bazowa musi obsłużyć ponad pięćdziesiąt tysięcy przelotek TSV oraz gigantyczną matrycę połączeń logicznych, co sprawiło, że jej wytwarzanie w fabrykach pamięci stało się niemożliwe. Matryca bazowa HBM4 staje się zaawansowanym chipletem logicznym, produkowanym w technologii odlewniczej TSMC lub Samsung Foundry w węzłach pięciu, czterech, a nawet trzech nanometrów FinFET i GAAFET.
Hybrydowe łączenie Direct Cu-Cu Bonding: Eliminacja lutowia i fizyka atomowa złączy
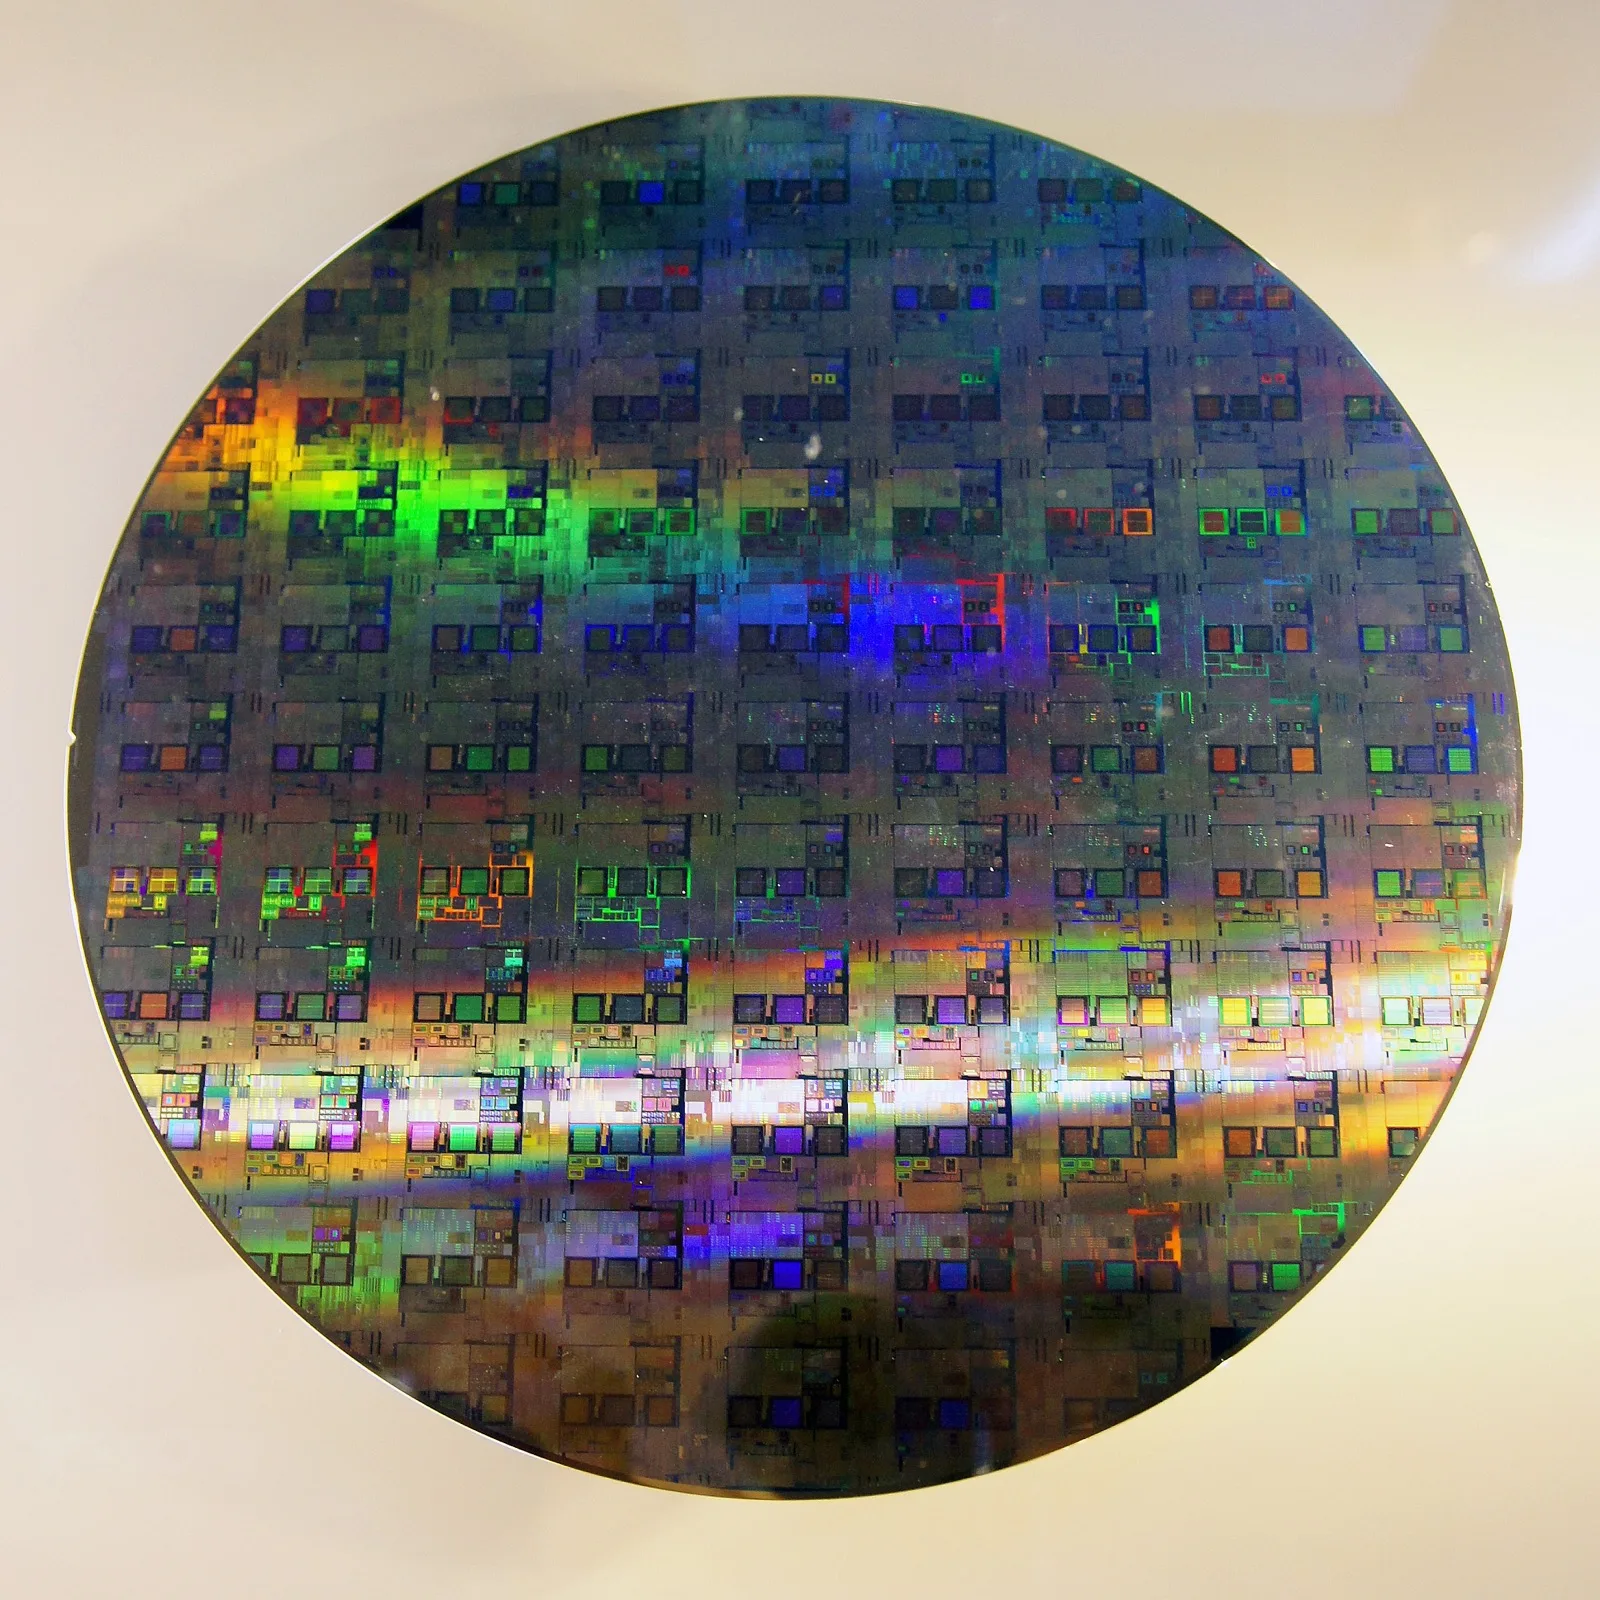
Drugim filarem technologicznym HBM4 jest wdrożenie hybrydowego łączenia miedź-miedź bez użycia kulek lutowniczych, znanego jako Direct Cu-Cu Hybrid Bonding lub pod nazwami handlowymi TSMC SoIC oraz DBI od Direct Bond Interconnect. W procesie tym powierzchnia wafla krzemowego zawierającego matryce pamięciowe zostaje poddana planaryzacji chemiczno-mechanicznej CMP z atomową precyzją, uzyskując chropowatość powierzchni poniżej jednego nanometra. Na powierzchni znajdują się zarówno odsłonięte punkty kontaktowe z czystej miedzi, jak i otaczająca je warstwa dielektryka, zazwyczaj dwutlenku krzemu SiO2 lub węgloazotku krzemu SiCN.
Podczas łączenia w temperaturze pokojowej w warunkach ultra-czystego próżniowego cleanroomu dochodzi w pierwszej kolejności do spontanicznego wiązania molekularnego między warstwami dielektryka pod wpływem sił van der Waalsa. Następnie cały pakiet poddawany jest wyżarzaniu termicznemu w temperaturze około trzystu stopni Celsjusza. W tej temperaturze współczynnik rozszerzalności cieplnej miedzi, będący znacznie wyższy niż dla dwutlenku krzemu, powoduje wybrzuszenie mikro-kontaktów miedzianych ku sobie, wywołując potężny nacisk mechaniczny na styku. Dochodzi wówczas do zjawiska dyfuzji atomowej w ciele stałym: atomy miedzi przekraczają barierę międzykryształu, rekrystalizując i tworząc jednolite, ciągłe metaliczne połączenie pozbawione jakichkolwiek granic fazowych.
Hybrydowe łączenie Cu-Cu pozwala na zredukowanie podziałki między stykami z dwudziestu pięciu mikrometrów do zaledwie jednego do trzech mikrometrów, co oznacza wzrost gęstości połączeń pionowych o rząd wielkości. Co więcej, brak kulek lutowniczych redukuje pasożytniczą indukcyjność i rezystancję złącza niemal do zera, zmniejszając straty energii na transmisję bitu o ponad siedemdziesiąt procent. Umożliwia to również drastyczne pocienienie pojedynczych warstw krzemu DRAM do grubości zaledwie dwudziestu do trzydziestu mikrometrów, dzięki czemu szesnastowarstwowy stos HBM4 mieści się w standardowym profilu obudowy o grubości poniżej siedmiuset mikrometrów.
Zarządzanie termiczne w stosach 16-Hi: Bariera odprowadzania ciepła i mikrokanały
Upakowanie szesnastu aktywnych warstw krzemowych w mikroskopijnym prostopadłościanie o wymiarach zaledwie dziesięć na dziesięć milimetrów rodzi gigantyczne wyzwania termodynamiczne. Komórki pamięci DRAM są niezwykle wrażliwe na temperaturę: w miarę nagrzewania się struktury powyżej osiemdziesięciu pięciu stopni Celsjusza prądy upływu tranzystorów dostępowych rosną wykładniczo, co skraca czas retencji ładunku w mikroskopijnych kondensatorach głębokiego rowka deep trench. Wymusza to drastyczne skrócenie okresu odświeżania pamięci refresh rate, co z kolei konsumuje pasmo magistrali danych i generuje dodatkowe straty mocy w postaci ciepła Joule'a.
W tradycyjnych stosach HBM obecność polimerowych żywic wypełniających underfill stanowiła poważną barierę dla przewodnictwa cieplnego, jako że współczynnik przewodzenia ciepła polimerów wynosi poniżej jednego wata na metr-kelwin, podczas gdy dla czystego krzemu przekracza sto czterdzieści watów na metr-kelwin. Zastosowanie hybrydowego łączenia Cu-Cu eliminuje warstwę żywicy: bezpośredni kontakt miedzi i dielektryka tworzy jednorodną ścieżkę termiczną, przez którą ciepło z dolnych warstw stosu może być efektywnie odprowadzane pionowo w górę ku zintegrowanemu rozpraszaczowi ciepła IHS wykonanemu z miedzi niklowanej lub kompozytów diamentowo-miedzianych.
Dla najbardziej wymagających klastrów trenowania AI, w których gęstość strumienia cieplnego przekracza sto watów na centymetr kwadratowy, laboratoria badawcze opracowują zintegrowane mikrokanały chłodzące wycinane bezpośrednio w nieaktywnych obszarach krzemu Base Die. Wtłaczanie dielektrycznych cieczy chłodzących pod ciśnieniem kilkunastu barów bezpośrednio do wnętrza struktury półprzewodnikowej pozwala na utrzymanie temperatury krytycznych złączy p-n poniżej sześćdziesięciu stopni Celsjusza nawet przy permanentnym obciążeniu obliczeniami tensorycznymi.
Ekonomia uzysku KGD: Wbudowane obwody BIST i redundantne linie TSV
Jednym z najpilniej strzeżonych sekretów producentów pamięci jest wskaźnik uzysku produkcyjnego znanego jako KGD od Known Good Die. W tradycyjnym procesie montażu pojedyncza wadliwa struktura pamięciowa oznacza stratę taniej kości w obudowie BGA. W przypadku HBM4 montaż szesnastu warstw krzemowych oznacza, że defekt w zaledwie jednej z nich powoduje konieczność wyrzucenia do kosza całego stosu zawierającego piętnaście w pełni sprawnych matryc DRAM oraz ultranowoczesną matrycę bazową wyprodukowaną w drogim procesie odlewniczym TSMC. Przy uzyskach pojedynczej matrycy na poziomie dziewięćdziesięciu procent, matematyczny uzysk szesnastowarstwowego stosu bez zaawansowanych mechanizmów naprawczych wynosiłby zaledwie osiemnaście procent, co zrujnowałoby ekonomikę projektu.
Aby temu zapobiec, producenci implementują potężne mechanizmy redundancji sprzętowej oraz wbudowane systemy samotestujące BIST od Built-In Self-Test. Każda matryca DRAM zawiera dodatkowe, nadmiarowe przelotki krzemowe TSV oraz rezerwowe bloki komórek pamięciowych. Zintegrowany kontroler na poziomie Base Die przeprowadza testy integralności sygnałowej w locie: w razie wykrycia mikropęknięcia ścieżki lub zwarcia na linii danych następuje automatyczne przekierowanie sygnału na linię rezerwową za pomocą trwałego przepalania mikroskopijnych bezpieczników elektronicznych eFuse lub programowania pamięci nieulotnej MRAM.
Dzięki tym zabiegom oraz doskonaleniu chemiczno-mechanicznej planaryzacji w fabrykach w Korei Południowej, komercyjny uzysk produkcyjny stosów HBM osiąga dziś poziomy przekraczające osiemdziesiąt procent. Sprawia to, że mimo astronomicznych cen jednostkowych sięgających kilku tysięcy dolarów za pojedynczy moduł pamięciowy, HBM4 stanowi najbardziej opłacalne ekonomicznie rozwiązanie w przeliczeniu na pojedynczy token generowany przez infrastrukturę sztucznej inteligencji.
Standaryzacja UCIe i heterogeniczne chiplety AI
Równolegle do rozwoju pionowych stosów pamięciowych, fundamentalnym wyzwaniem stała się standaryzacja połączeń poziomych między rdzeniami obliczeniowymi a interfejsem pamięci. Przez lata czołowi gracze stosowali zamknięte, autorskie protokoły komunikacyjne, takie jak Nvidia NVLink czy AMD Infinity Fabric, co zmuszało projektantów do budowania układów w obrębie ekosystemu jednego dostawcy. Przełomem stało się powołanie konsorcjum Universal Chiplet Interconnect Express UCIe, zrzeszającego ponad sto wiodących przedsiębiorstw branży półprzewodnikowej.
Standard UCIe definiuje kompletną specyfikację warstwy fizycznej Die-to-Die D2D oraz protokołów transportowych, umożliwiając łączenie w jednym pakiecie chipletów produkowanych w różnych węzłach technologicznych i w różnych fabrykach na świecie. Interfejs UCIe charakteryzuje się opóźnieniami transakcyjnymi poniżej dwóch nanosekund oraz efektywnością energetyczną rzędu ułamków pikodżula na przesłany bit, co oznacza ponad dziesięciokrotną redukcję strat mocy w porównaniu z tradycyjnymi magistralami PCIe. Dzięki UCIe baza logiczna Base Die pamięci HBM4 może komunikować się bezpośrednio z układem GPU za pomocą zunifikowanych linii sygnałowych, co drastycznie upraszcza trasowanie połączeń na interposerze krzemowym i przyspiesza projektowanie niestandardowych akceleratorów ASIC dla hiperskali.
Compute Express Link CXL: Pamięć rozproszona i pooling w szafach serwerowych
Nawet najbardziej przepustowa pamięć HBM4 ma jedną wadę konstrukcyjną: musi znajdować się w bezpośredniej bliskości procesora na wspólnym interposerze krzemowym, co ogranicza jej maksymalną fizyczną pojemność ze względu na limit powierzchni siatki litograficznej reticle limit. W klastrach trenujących modele frontierowe o bilionach parametrów konieczne jest utrzymywanie gigantycznych tablic stanów optymalizatora Adam, gradientów wag oraz pamięci podręcznej klucz-wartość KV-cache, które nie mieszczą się w buforach HBM. Rozwiązaniem tego problemu na poziomie architektury centrum danych stał się standard Compute Express Link CXL.
CXL to otwarty standard interkonektu przemysłowego bazujący na fizycznej warstwie PCIe 5.0 oraz PCIe 6.0 z sygnalizacją PAM4, wprowadzający protokoły niskich opóźnień CXL.io, CXL.cache oraz CXL.mem. Protokół CXL.mem umożliwia procesorom centralnym CPU, procesorom graficznym GPU oraz dedykowanym akceleratorom AI bezpośredni, spójny pamięciowo dostęp do zewnętrznych modułów pamięci dynamicznej z opóźnieniami transakcyjnymi na poziomie poniżej stu nanosekund, bezpośrednio poprzez operacje ładowania i zapisu load/store, bez narzutu stosu sieciowego jądra systemu operacyjnego.
W generacjach CXL 2.0 i CXL 3.0 pojawia się kluczowa koncepcja poolingu pamięci memory pooling oraz współdzielenia pamięci memory sharing. Zamiast dedykować sztywne moduły pamięci DDR do konkretnych węzłów serwerowych, w szafie serwerowej instalowane są scentralizowane skrzynie pamięciowe CXL Memory Expander, połączone z procesorami za pośrednictwem krosownic CXL Switches. Pamięć jest przydzielana dynamicznie w locie tym instancjom obliczeniowym, które w danym momencie wykonują fazę wstępnego przetwarzania tokenów lub alokację warstw modelu. Pozwala to na wyeliminowanie zjawiska osieroconej pamięci stranded memory, które w tradycyjnych klastrach hiperskalowych marnowało nawet trzydzieści procent zainstalowanych gigabajtów RAM.
Zaawansowane pakowanie 2.5D i 3D: CoWoS, Foveros i mostki krzemowe EMIB
Wojna o pamięć HBM4 i interkonekty CXL nierozerwalnie wiąże się z bitwą o moce produkcyjne w obszarze zaawansowanego pakowania półprzewodników Advanced Packaging. Współczesny procesor graficzny AI przestał być pojedynczym kawałkiem krzemu, stając się super-układem scalonym złożonym z kilkunastu chipletów połączonych na podłożu pośrednim. Liderem rynkowym w tej dziedzinie pozostaje tajwański gigant TSMC ze swoją technologią CoWoS od Chip-on-Wafer-on-Substrate.
W wariancie CoWoS-S rolę nośnika pełni pasywny interposer krzemowy o powierzchni sięgającej ponad trzech do czterech masek litograficznych, na którym obok siebie montowane są matryce obliczeniowe oraz stosy HBM. Ze względu na wysoki koszt i podatność na pękanie wielkich płytek krzemowych, przemysł wdraża warianty alternatywne: CoWoS-R, wykorzystujący elastyczne warstwy redystrybucyjne RDL z polimerów dielektrycznych, oraz CoWoS-L, który integruje lokalne mostki krzemowe LSI umieszczone wewnątrz organicznego laminatu, łącząc zalety niskiego kosztu podłoży organicznych z submikronową gęstością ścieżek krzemowych.
Konkurencyjne rozwiązania, takie jak Intel EMIB od Embedded Multi-die Interconnect Bridge oraz technologia Foveros 3D, pozwalają na jeszcze bardziej elastyczne łączenie heterogenicznych struktur krzemowych z różnych fabryk i węzłów technologicznych. Sukces rynkowy Nvidii, AMD czy akceleratorów Google TPU zależy dziś w równym stopniu od dostępności wafelków pięcionanometrowych, co od przepustowości linii produkcyjnych CoWoS i zdolności dostawców materiałów do dostarczenia ultraczystych folii underfill oraz precyzyjnych zgrzewarek termokompresyjnych.
Geopolityka krzemu i wielki sojusz SK Hynix, TSMC i Nvidii przeciwko Samsungowi
Stawka w wojnie o dominację w pamięciach AI jest kolosalna. Firma SK Hynix, która dzięki pionierskiemu wdrożeniu technologii MR-MUF zdominowała rynek HBM3 i HBM3E, zdobywając ponad siedemdziesiąt procent udziału w dostawach dla firmy Nvidia, zawarła bezprecedensowy sojusz technologiczny z TSMC. W ramach tego partnerstwa SK Hynix przekazuje produkcję bazowych matryc logicznych Base Die dla HBM4 do zaawansowanych węzłów odlewniczych TSMC, integrując swoje stosy bezpośrednio z liniami montażowymi CoWoS w tajwańskich fabrykach w Taichung i Chiayi. Tworzy to potężny trójkąt przemysłowy: Nvidia projektuje architekturę, SK Hynix dostarcza struktury DRAM, a TSMC wytwarza matrycę bazową i łączy cały moduł w jedną całość.
Tymczasem południowokoreański czebol Samsung Electronics dąży do przełamania tej dominacji za pomocą strategii kompleksowej integracji pionowej One-Stop Turnkey Solution. Samsung jest jedyną firmą na świecie, która pod jednym dachem posiada fabryki zaawansowanych pamięci DRAM, odlewnię półprzewodników logicznych Samsung Foundry z technologią bramek GAAFET oraz zakłady zaawansowanego pakowania z autorską technologią I-Cube i Saint. Samsung oferuje hiperskalom kompletną usługę produkcyjną od projektu po gotowy moduł, eliminując konieczność koordynacji łańcucha dostaw między Koreą a Tajwanem. Do walki dołącza również amerykański Micron Technology, który po udanym debiucie z ośmiowarstwowym HBM3E w węźle 1-beta buduje potężne linie montażu pamięci w Hiroszimie oraz Singapurze, korzystając ze szczodrych dotacji w ramach amerykańskiego i japońskiego CHIPS Act.
Perspektywy: Przetwarzanie w pamięci PIM i rewolucja krzemowej fotoniki CPO
W horyzoncie kolejnych pięciu lat nawet HBM4 i interkonekty CXL zaczną napotykać fundamentalne ograniczenia termiczne. Przesyłanie prądów o natężeniu setek amperów przez interposery krzemowe generuje gęstości mocy przekraczające sto watów na centymetr kwadratowy, wymagając stosowania zaawansowanych systemów chłodzenia cieczą z bezpośrednim natryskiem na krzem direct-to-chip lub chłodzenia zanurzeniowego immersion cooling. Dlatego kolejnym etapem ewolucji staje się przetwarzanie bezpośrednio w pamięci Processing-in-Memory PIM.
Architektury HBM-PIM integrują programowalne jednostki arytmetyczno-logiczne SIMD bezpośrednio wewnątrz każdej warstwy matrycy DRAM lub w matrycy bazowej Base Die. Zamiast przesyłać gigabajty danych z pamięci do procesora GPU wyłącznie w celu wykonania prostej operacji dodawania wektorów czy normalizacji Softmax, operacje te są wykonywane lokalnie wewnątrz stosu pamięciowego. Zmniejsza to obciążenie magistrali komunikacyjnej o ponad połowę i drastycznie redukuje pobór energii całego klastra.
Ostatecznym przełomem, który zlikwiduje ograniczenia miedzianych interkonektów CXL i szyn HBM, będzie integracja optyki współdzielonej Co-Packaged Optics CPO opartej na krzemowej fotonice. Zastąpienie miedzianych ścieżek mikro-falowodami optycznymi zintegrowanymi na wspólnym podłożu pozwoli na przesyłanie terabitów danych za pomocą laserów wielofalowych WDM z zerową dyssypacją ciepła i opóźnieniami determinowanymi wyłącznie prędkością światła. Wojna o pamięć AI to nie tylko wyścig o ułamki nanometrów w litografii, lecz fundamentalna batalia o fizykę transportu energii i informacji, która zdefiniuje układ sił w globalnej gospodarce na nadchodzące dziesięciolecia.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.