
Pamięci MRAM i memrystory ReRAM w architekturze In-Memory Computing: Jak magnetyczne złącza tunelowe MTJ i operacje macierzowe w pamięci przełamują wąskie gardło von Neumanna w sprzętowych akceleratorach sztucznej inteligencji
Współczesna architektura systemów obliczeniowych znalazła się w obliczu najbardziej fundamentalnego kryzysu od czasu narodzin ery krzemowej. Eksplozja zapotrzebowania na moc obliczeniową dla wielkich modeli sztucznej inteligencji, liczących setki miliardów i biliony parametrów wagowych, zderzyła się z nieprzekraczalną barierą fizyczną znaną jako wąskie gardło von Neumanna von Neumann bottleneck oraz ściana pamięci memory wall. W klasycznej architekturze komputerowej jednostka arytmetyczno-logiczna ALU procesora jest fizycznie oddzielona od pamięci operacyjnej magistralą transmisyjną. W rezultacie w najnowocześniejszych akceleratorach graficznych GPU, takich jak układy NVIDIA H100 czy Blackwell B200, ponad osiemdziesiąt procent energii elektrycznej zużywanej podczas inferencji modelu transformatora nie służy do wykonywania mnożeń i dodawań, lecz do ciągłego, bezsensownego pompowania miliardów wektorów zmiennoprzecinkowych tam i z powrotem między stosami pamięci HBM3e a rdzeniami Tensor Core.
Ten gigantyczny narzut energetyczny doprowadził do sytuacji, w której dalsze skalowanie cyfrowych procesorów CMOS grozi wyczerpaniem rezerw sieci elektroenergetycznych centrów danych. Co więcej, prawo Moore'a, wyznaczające tempo miniaturyzacji tranzystorów polowych MOSFET, uległo drastycznemu spowolnieniu, a koszty litografii w węzłach poniżej trzech nanometrów rosną w postępie geometrycznym. W tej sytuacji jedyną drogą do przełamania impasu staje się radykalna redefinicja paradygmatu przetwarzania danych: odejście od cyfrowej separacji obliczeń i pamięci na rzecz architektury przetwarzania bezpośrednio w pamięci Compute-In-Memory CiM lub In-Memory Computing IMC.
W nowej architekturze to sama komórka pamięci staje się procesorem. Wykorzystując prawa fizyki rządzące przepływem prądu elektrycznego w obwodach analogowych, macierz pamięci nieulotnej potrafi wykonać operację mnożenia macierzowo-wektorowego Vector-Matrix Multiplication VMM – stanowiącego ponad dziewięćdziesiąt procent operacji w sieciach głębokich – w jednym cyklu zegarowym dla milionów parametrów jednocześnie. Głównymi filarami tej spintronicznej i memrystorowej rewolucji są magnetyczne pamięci o dostępie swobodnym MRAM oparte na złączach tunelowych MTJ oraz rezystywne pamięci ReRAM wykorzystujące zjawisko przełączania przewodności w nanometrowych warstwach tlenków metali.
Fizyka magnetycznych złączy tunelowych MTJ: Od TMR do prostopadłej anizotropii magnetycznej
Magnetyczna pamięć RAM MRAM opiera się na zjawiskach spintroniki, czyli dziedziny fizyki ciała stałego wykorzystującej nie tylko ładunek elektryczny elektronu, ale przede wszystkim jego wewnętrzny moment pędu – spin. Podstawowym elementem budulcowym komórki MRAM jest nanometryczne magnetyczne złącze tunelowe MTJ Magnetic Tunnel Junction. Struktura ta składa się z trzech ściśle ułożonych warstw atomowych: stałej warstwy ferromagnetycznej zwanej warstwą odniesienia reference layer, której kierunek namagnesowania jest trwale zablokowany przez sprzężenie antyferromagnetyczne, ultracienkiej warstwy dielektrycznej bariery tunelowej o grubości zaledwie jednego nanometra wykonanej z tlenku magnezu MgO, oraz swobodnej warstwy ferromagnetycznej free layer, najczęściej ze stopu kobaltu, żelaza i boru CoFeB, której wektor namagnesowania może być przełączany między dwoma stabilnymi stanami równoległym i antyrównoległym.
Działanie złącza MTJ opiera się na kwantowo-mechanicznym efekcie tunelowego magnetooporu TMR Tunnel Magnetoresistance. Zgodnie z modelem Julliere'a, prawdopodobieństwo przejścia elektronu przez barierę izolacyjną zależy od wzajemnej orientacji spinów elektronów przewodnictwa i gęstości stanów spinowych w warstwach ferromagnetycznych. Gdy namagnesowanie warstwy swobodnej jest równoległe do warstwy odniesienia, elektrony o zgodnej polaryzacji spinowej napotykają na niską barierę potencjału, a opór elektryczny złącza jest niski stan logiczny zero. W przypadku konfiguracji antyrównoległej opór elektryczny wzrasta wielokrotnie stan logiczny jeden, a współczynnik TMR w nowoczesnych złączach z barierą MgO przekracza dwieście pięćdziesiąt procent w temperaturze pokojowej.
Fundamentalnym krokiem milowym w skalowaniu złączy MTJ poniżej węzła dwudziestu nanometrów było wdrożenie prostopadłej anizotropii magnetycznej p-MTJ Perpendicular Magnetic Anisotropy. Wczesne struktury planarne in-plane cierpiały na niestabilność termiczną przy miniaturyzacji, gdyż fluktuacje cieplne mogły samoistnie odwrócić namagnesowanie złącza. W strukturach p-MTJ wektory namagnesowania są skierowane prostopadle do płaszczyzny cienkiej warstwy, co wynika z silnej hybrydyzacji orbitalnej na granicy faz między orbitalami 3d żelaza i kobaltu a orbitalami 2p tlenu w barierze MgO. Zapewnia to wysoki współczynnik stabilności termicznej delta przekraczający sześćdziesiąt do osiemdziesięciu, co gwarantuje ponad dziesięcioletnią retencję danych w temperaturze stu dwudziestu pięciu stopni Celsjusza, spełniając rygorystyczne normy przemysłu motoryzacyjnego AEC-Q100.
Ponadto w celu wyeliminowania pasożytniczych dipolowych pól rozproszenia stray fields, które mogłyby asymetrycznie przesuwać próg przełączania warstwy swobodnej, nowoczesne złącza p-MTJ wykorzystują syntetyczną strukturę antyferromagnetyczną SAF Synthetic Antiferromagnet w warstwie odniesienia. Dwie warstwy magnetyczne przedzielone subnanometrową przekładką z rutenu Ru są silnie sprzężone antyrównolegle poprzez oddziaływanie wymienne RKKY Ruderman-Kittel-Kasuya-Yosida, co powoduje idealne skasowanie zewnętrznego pola magnetycznego w objętości warstwy swobodnej.
Ewolucja SOT-MRAM: Sprzężenie spin-orbita i nieskończona trwałość
Przełomem technologicznym w zapisie danych w komórkach MTJ stało się wyeliminowanie zewnętrznych pól magnetycznych na rzecz zjawiska przeniesienia momentu pędu spinu STT Spin-Transfer Torque. W technologii STT-MRAM spolaryzowany spinowo prąd elektryczny przepływający bezpośrednio przez złącze wywiera moment obrotowy na elektrony warstwy swobodnej, obracając jej wektor namagnesowania. Jednakże przepływ dużego prądu zapisu przez nanometrową barierę MgO wywołuje jej powolną degradację dielektryczną TDDB Time-Dependent Dielectric Breakdown, ograniczając żywotność komórki do około dziesięciu do potęgi dwunastej cykli.
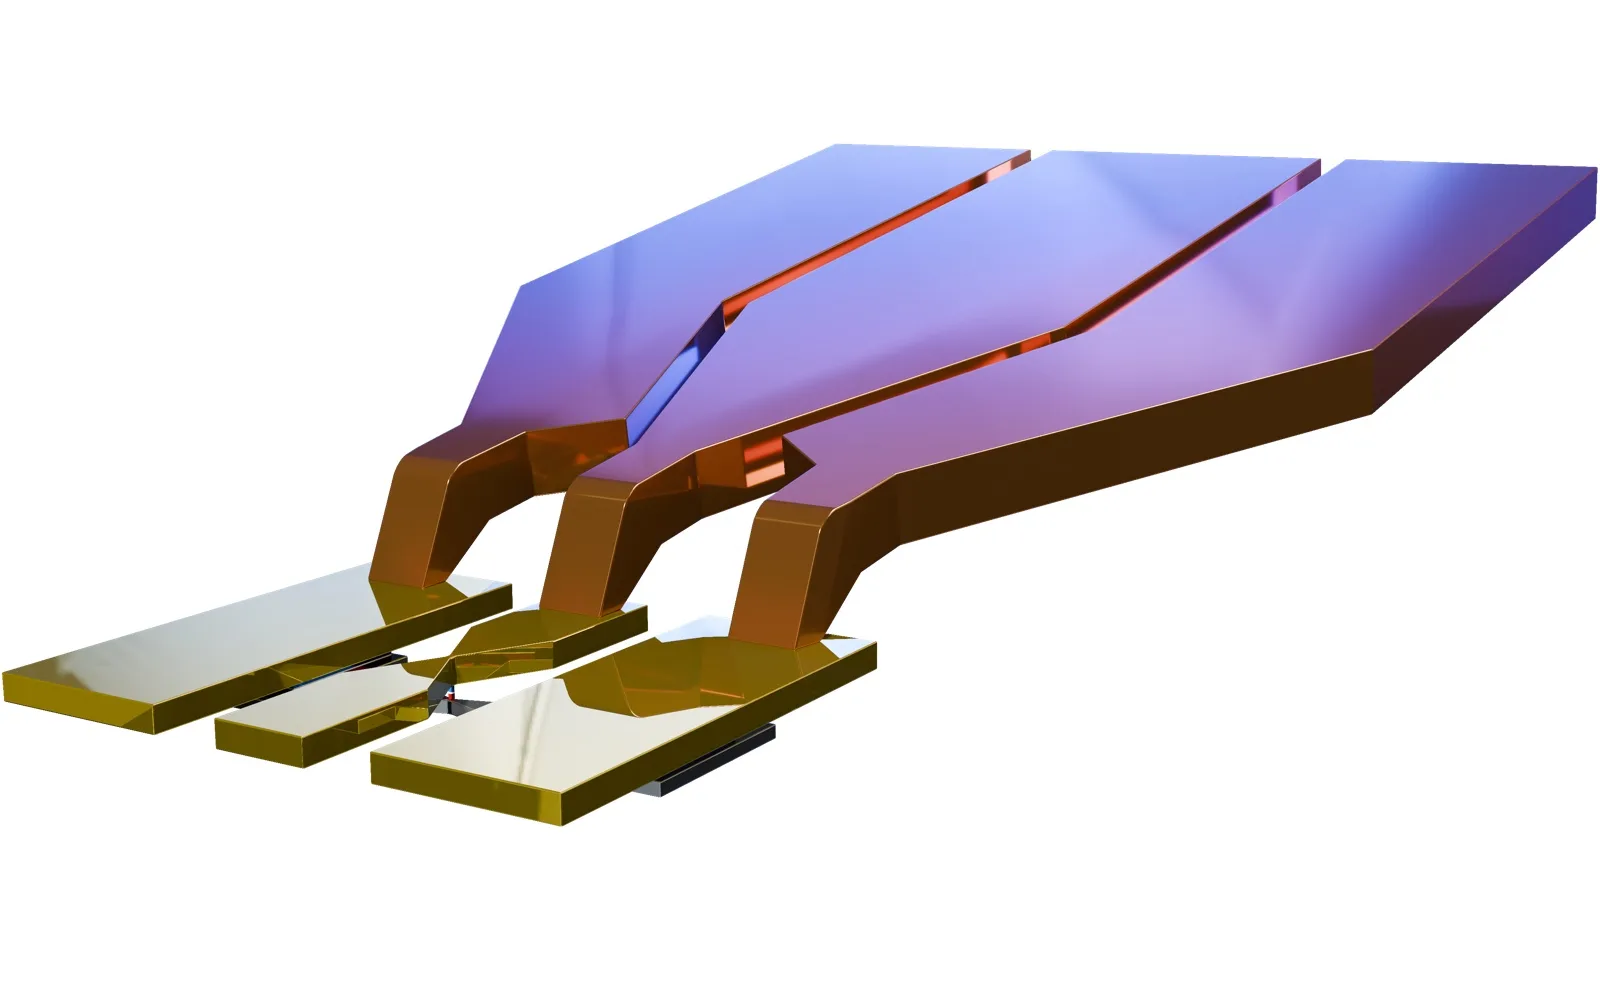
Odpowiedzią na te ograniczenia stała się pamięć oparta na momencie obrotowym sprzężenia spin-orbita SOT-MRAM Spin-Orbit Torque. W architekturze SOT złącze MTJ zostaje umieszczone na podłożu z metalu ciężkiego o silnym sprzężeniu spinowo-orbitalnym, takiego jak platyna, wolfram lub tantal, tworząc komórkę trójkońcówkową z oddzielną ścieżką zapisu i odczytu.
Gdy prąd zapisu przepływa poziomo przez kanał z metalu ciężkiego pod złączem, zjawisko spinowego efektu Halla SHE Spin Hall Effect oraz efekt Raszby wywołują poprzeczną separację spinów: elektrony o spinach skierowanych w górę akumulują się na jednej powierzchni, a elektrony o spinach w dół na przeciwległej. Powstały w ten sposób czysty prąd spinowy wstrzykiwany jest pionowo do swobodnej warstwy MTJ, powodując jej ultraszybkie przełączenie w czasie poniżej kilkuset pikosekund. Ponieważ prąd zapisu nie przepływa przez delikatną barierę tunelową MgO, trwałość endurance pamięci SOT-MRAM staje się praktycznie nieskończona, przekraczając dziesięć do potęgi piętnastej cykli, a zużycie energii podczas zapisu spada o rząd wielkości w porównaniu z STT.
Dzięki tym parametrom SOT-MRAM staje się idealnym kandydatem do zastąpienia pamięci podręcznej SRAM poziomu L1, L2 i L3 bezpośrednio na strukturze krzemowej procesorów AI. W odróżnieniu od pamięci SRAM, która wymaga aż sześciu tranzystorów 6T na pojedynczy bit i cierpi na wysoki prąd upływu w stanie spoczynku leakage power, komórka SOT-MRAM jest nieulotna, zajmuje trzykrotnie mniejszą powierzchnię krzemu i pozwala na natychmiastowe usypianie i wybudzanie rdzeni obliczeniowych normally-off computing bez jakichkolwiek strat energii.
Co więcej, eliminacja konieczności ciągłego odświeżania zawartości komórek, typowa dla dynamicznych pamięci DRAM, redukuje pobór mocy w trybie czuwania stand-by o ponad dziewięćdziesiąt procent, co jest kluczowym parametrem dla urządzeń zasilanych bateryjnie i systemów klasy ultra-low power.
Memrystory i pamięci rezystywne ReRAM: Czwarty element obwodu Leona Chua
Drugim rewolucyjnym filarem obliczeń w pamięci są pamięci rezystywne Resistive RAM ReRAM, będące fizyczną realizacją koncepcji memrystora memory-resistor sformułowanej teoretycznie przez Leona Chua w 1971 roku. Memrystor to bierny dwubiegunowy element obwodu elektrycznego, w którym opór elektryczny nie jest stały, lecz zależy od całki przepływającego przez niego prądu lub przyłożonego napięcia w czasie, reprezentując właściwość pamiętania przeszłego ładunku elektrycznego.
Fizyczna struktura komórki ReRAM opiera się na układzie metal-izolator-metal MIM. Nanometrowa warstwa tlenku metalu przejściowego, najczęściej dwutlenku hafnu HfO2, tlenku tantalu Ta2O5 lub dwutlenku tytanu TiO2, umieszczona jest między elektrodą aktywną z miedzi lub srebra a elektrodą obojętną z platyny, złota lub azotku tytanu TiN. W procesie zwanym elektroformowaniem electroforming przyłożenie odpowiedniego impulsu napięciowego wywołuje migrację wakatów tlenowych w sieci krystalicznej dielektryka, prowadząc do uformowania nanometrowego włókna przewodzącego conductive filament łączącego obie elektrody.
Kinetyka formowania i zrywania włókna podlega prawu Motta-Gurneya dotyczącemu przeskoku jonów w ekstremalnych lokalnych polach elektrycznych przekraczających dziesięć megawoltów na centymetr. Przewodnictwo w przewężeniu włókna wykazuje charakter kwantowy, opisany formalizmem Landauera-Büttikera, w którym prąd jest sumą dyskretnych kanałów przewodnictwa balistycznego. W zależności od polaryzacji i amplitudy kolejnych impulsów elektrycznych włókno przewodzące może być stopniowo zwężane lub rozbudowywane, co prowadzi do płynnej, analogowej modulacji przewodności elektrycznej conductance złącza w szerokim zakresie wartości. Zjawisko to wykazuje uderzające podobieństwo do biologicznej plastyczności synaptycznej w ludzkim mózgu, w tym długotrwałego wzmocnienia synaptycznego LTP Long-Term Potentiation oraz długotrwałego osłabienia LTD Long-Term Depression opisanego regułą Hebba.
Aby zapobiec powstawaniu pasożytniczych prądów upływu sneak-path currents w gęstych macierzach krzyżowych pozbawionych tranzystorów dostępowych, inżynieria materiałowa wdrożyła architekturę 1S1R One-Selector One-Resistor. W układzie tym szeregowo z memrystorem integrowany jest miniaturowy przełącznik progowy selector oparty na zjawisku owonicznym OTS Ovonic Threshold Switch w stopach chalkogenkowych lub przejściu metal-izolator MIT w dwutlenku wanadu VO2. Selektor wykazuje skrajnie nieliniową charakterystykę prądowo-napięciową, blokując przepływ prądu dla niskich napięć odczytu komórek nieaktywnych i otwierając się wyłącznie przy pełnym napięciu adresowania komórki wybranej.
Neuromorficzne sieci impulsowe SNN i plastyczność zależna od czasu impulsu STDP
Prawdziwy potencjał memrystorów ujawnia się w architekturach neuromorficznych trzeciej generacji, znanych jako impulsowe sieci neuronowe SNN Spiking Neural Networks. W odróżnieniu od klasycznych sieci głębokich, w których neurony wymieniają ciągłe wartości numeryczne w każdym kroku czasowym, sieci SNN naśladują ludzki mózg, kodując informacje w dyskretnych w czasie potencjałach czynnościowych – impulsach spike. Neuron syntetyczny akumuluje ładunek elektryczny na mikroskopijnej pojemności pasożytniczej bramki i generuje krótki impuls napięciowy dopiero po przekroczeniu progu pobudzenia integrate-and-fire.
Wykorzystanie komórek ReRAM jako sztucznych synaps umożliwia bezpośrednią sprzętową realizację biologicznej reguły plastyczności zależnej od czasu impulsu STDP Spike-Timing-Dependent Plasticity. Jeżeli impuls z neuronu przedsynaptycznego wyprzedza impuls z neuronu zasynaptycznego o kilka milisekund, wypadkowy gradient napięcia na memrystorze przesuwa wakaty tlenowe i zwiększa jego przewodność elektryczną, wzmacniając wagę połączenia. W przeciwnym razie, gdy kolejność impulsów jest odwrotna, synapsa ulega osłabieniu. Proces ten zachodzi lokalnie, bezpośrednio w fizycznej strukturze materiału, bez konieczności globalnego algorytmu wstecznej propagacji błędu backpropagation i bez angażowania zewnętrznego procesora.
W połączeniu z neuromorficznymi czujnikami wizyjnymi DVS Dynamic Vision Sensors, rejestrującymi wyłącznie zmiany natężenia światła w pikselach w ułamkach mikrosekund, koprocesory ReRAM-SNN tworzą systemy percepcji brzegowej o niespotykanej dotąd efektywności. Dron wyposażony w taką kamerę i memrystorowy chip neuromorficzny potrafi wykrywać i omijać przeszkody z prędkościami naddźwiękowymi przy całkowitym poborze mocy poniżej stu miliwatów, co oznacza rewolucję w autonomicznych mikrodronach i robotyce wojskowej.
Obliczenia analogowe w macierzach krzyżowych Crossbar Array: Prawa Ohma i Kirchhoffa
Prawdziwa magia obliczeń In-Memory Computing ujawnia się po połączeniu komórek MRAM lub ReRAM w dwuwymiarową macierz krzyżową Crossbar Array. W układzie tym równoległe poziome linie słów wordlines przecinają się z pionowymi liniami bitów bitlines, a w każdym punkcie przecięcia znajduje się komórka pamięci o zadanej przewodności elektrycznej Gij, reprezentującej wagę macierzy w warstwie sieci neuronowej.
Kiedy na linie słów podany zostaje wektor napięć wejściowych Vi reprezentujący aktywacje wejściowe sieci, w każdym punkcie przecięcia prąd elektryczny płynący przez element pamięci wynosi zgodnie z prawem Ohma dokładnie Iij = Vi * Gij, co stanowi fizyczne mnożenie napięcia przez przewodność. Następnie, zgodnie z pierwszym prawem Kirchhoffa, prądy ze wszystkich komórek w danej kolumnie sumują się w sposób naturalny na pionowej linii bitu: całkowity prąd wyjściowy Ij jest równy sumie iloczynów Vi * Gij. W ten sposób kompletna operacja mnożenia macierzy wag przez wektor aktywacji wejściowych zostaje zrealizowana w ułamku nanosekundy jako bezpośredni stan ustalony obwodu elektrycznego, bez konieczności odczytywania wag do rejestrów procesora.
Efektywność energetyczna takiego układu jest porażająca. Podczas gdy najnowocześniejsze cyfrowe jednostki TPU i GPU osiągają sprawność na poziomie od dziesięciu do dwudziestu teraoperacji na wat TOPS/W, analogowe akceleratory CiM oparte na macierzach ReRAM i MRAM demonstrują w warunkach laboratoryjnych efektywność przekraczającą sto do nawet trzystu TOPS/W. Złożoność czasowa mnożenia macierzy o rozmiarze N na N spada z poziomu O(N kwadrat) do stałego czasu O(1), niezależnie od liczby wag w macierzy.
Inżynieria precyzji: Wyzwania przetworników ADC i spadków napięć IR-Drop
Przejście od eleganckiej teorii fizycznej do wielkoskalowych komercyjnych chipów CiM napotyka jednak na potężne bariery inżynierii sygnałowej. Podstawowym problemem jest pasożytnicza rezystancja metalowych linii przewodzących metal wire resistance. Prąd płynący przez cienkie ścieżki miedziane na strukturze krzemowej wywołuje spadek napięcia wzdłuż linii zwany IR-drop, co oznacza, że komórki pamięci położone na końcu linii otrzymują niższe napięcie wejściowe niż komórki na początku, wprowadzając nieliniowe zniekształcenia w wynikach obliczeń.
Kolejnym krytycznym wąskim gardłem są interfejsy mieszane analogowo-cyfrowe na obrzeżach macierzy krzyżowej. Aby połączyć analogowy blok obliczeniowy ze standardową architekturą cyfrową, prądy wyjściowe z linii bitów muszą zostać przekształcone w cyfrowe słowa binarne za pomocą przetworników analogowo-cyfrowych ADC. Przetworniki te, pracujące z wysoką rozdzielczością od sześciu do ośmiu bitów, zajmują ponad siedemdziesiąt procent powierzchni krzemu chipa akceleratora i odpowiadają za większość zużycia energii całego układu. Projektanci muszą zatem balansować między precyzją kwantyzacji sieci neuronowej a kosztem energetycznym konwersji sygnałów.
Dodatkowym wyzwaniem w technologii ReRAM jest zmienność komórka-do-komórki device-to-device variability oraz relaksacja przewodności w czasie conductance drift wywołana stochastyczną dyfuzją wakatów tlenowych. Aby skompensować te niedoskonałości fizyczne, stosuje się algorytmy treningu odpornego na szum sprzętowy hardware-aware training, w których sieć neuronowa podczas uczenia na klastrze GPU jest celowo poddawana zniekształceniom modelującym charakterystykę fizyczną konkretnej fabryki półprzewodników, co pozwala zachować dokładność inferencji zbliżoną do idealnej arytmetyki zmiennoprzecinkowej FP32.
Monolityczna integracja trójwymiarowa BEOL i pamięci FeFET
Kluczowym atutem technologii MRAM i ReRAM z punktu widzenia ekonomiki produkcji półprzewodników jest możliwość ich monolitycznej integracji trójwymiarowej w warstwie metalizacji BEOL Back-End-of-Line. W przeciwieństwie do pamięci DRAM, która wymaga budowy głębokich rowów kondensatorowych w podłożu krzemowym w wysokich temperaturach przekraczających tysiąc stopni Celsjusza, warstwy MTJ i ReRAM mogą być nanoszone metodą napylania magnetronowego PVD i osadzania warstw atomowych ALD w temperaturach poniżej czterystu stopni Celsjusza.
Oznacza to, że macierze pamięci obliczeniowej mogą być wytwarzane bezpośrednio nad gotowymi tranzystorami logicznymi CMOS, pomiędzy czwartą a piątą warstwą metalizacji chipa, nie degradując parametrów krzemowych bramek tranzystorowych. Otwiera to drogę do budowy monolitycznych struktur 3D-CiM o gigantycznej przepustowości pionowej sięgającej terabajtów na sekundę, eliminując konieczność stosowania drogich krzemowych przekładek interposer i mikroskopijnych połączeń przelotowych TSV Through-Silicon Via.
Równolegle rozwijają się technologie ferroelektrycznych tranzystorów polowych FeFET. Poprzez domieszkowanie dwutlenku hafnu cyrkonem HfO2:ZrO2 HZO materiał zyskuje stabilne właściwości ferroelektryczne przy grubościach rzędu kilku nanometrów. Komórka FeFET łączy funkcję tranzystora logicznego i nieulotnej pamięci analogowej w pojedynczej strukturze bramki tranzystora, oferując bezstratny odczyt napięciowy i pełną kompatybilność z technologią FinFET i nanosheet GAAFET w wiodących procesach litograficznych.
Współczesne techniki projektowania elektronicznego EDA Electronic Design Automation, dostarczane przez rynkowych liderów Synopsys i Cadence, wdrażają wyspecjalizowane biblioteki komórek standardowych dla struktur CiM, umożliwiając automatyczną syntezę układów hybrydowych łączących cyfrowe procesory RISC-V z analogowymi koprocesorami macierzowymi. Standaryzacja modeli behawioralnych w językach Verilog-A i SPICE pozwala inżynierom na symulację miliardów cykli pracy przed wysłaniem masek litograficznych do odlewni, drastycznie redukując ryzyko kosztownych błędów wdrożeniowych.
Geopolityka krzemu i komercjalizacja: Przemysłowy wyścig o eMRAM i ReRAM
Przejście na architekturę In-Memory Computing stało się areną zaciętej rywalizacji czołowych światowych odlewni półprzewodników. Liderzy rynkowi, w tym TSMC, Samsung Foundry, Intel oraz GlobalFoundries, wdrożyli już moduły wbudowanej pamięci embedded MRAM eMRAM w zaawansowanych procesach technologicznych od 22 nm do 12 nm FinFET, zastępując pamięci Flash w mikrokontrolerach przemysłowych, systemach motoryzacyjnych oraz układach Internetu Rzeczy IoT.
Kluczowym atutem MRAM w zastosowaniach militarnych i kosmicznych jest jej absolutna odporność na promieniowanie jonizujące i cząstki wysokoenergetyczne radiation-hardened. W przeciwieństwie do pamięci SRAM i DRAM, w których uderzenie ciężkiego jonu wywołuje odwrócenie bitu Single-Event Upset SEU, namagnesowanie złącza MTJ pozostaje całkowicie nienaruszone, co czyni spintronikę fundamentem pokładowych akceleratorów AI dla autonomicznych satelitów rozpoznawczych i sond dalekiego kosmosu.
Równolegle start-upy technologiczne, takie jak Mythic, Syntiant czy Weebit Nano, wprowadzają na rynek pierwsze komercyjne koprocesory inferencyjne oparte na macierzach ReRAM dla systemów widzenia maszynowego w dronach i kamerach przemysłowych. Układy te przetwarzają strumienie wideo w czasie rzeczywistym przy poborze mocy rzędu kilkudziesięciu miliwatów, umożliwiając pracę zaawansowanych modeli detekcji obiektów przez wiele miesięcy na pojedynczej baterii.
Integracja spintroniki i memrystorów w architekturze In-Memory Computing zamyka trwającą ponad pół wieku epokę bezwzględnego panowania modelu von Neumanna. Przenosząc obliczenia bezpośrednio w głąb struktury atomowej pamięci i zastępując cyfrową abstrakcję analogową fizyką przepływu elektronów, inżynieria krzemowa otwiera wrota do stworzenia sztucznej inteligencji o efektywności energetycznej i gęstości integracji dorównującej biologicznemu mózgowi, redefiniując granice tego, co technologicznie możliwe w erze post-krzemowej.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.