
Krzemowy przewrót TSMC i ASML: Debiut węzła sub-1.4nm, zasilanie od spodu wafla i rewolucja optyki CPO w akceleratorach AI
Zmierzch klasycznej litografii i narodziny architektury A14
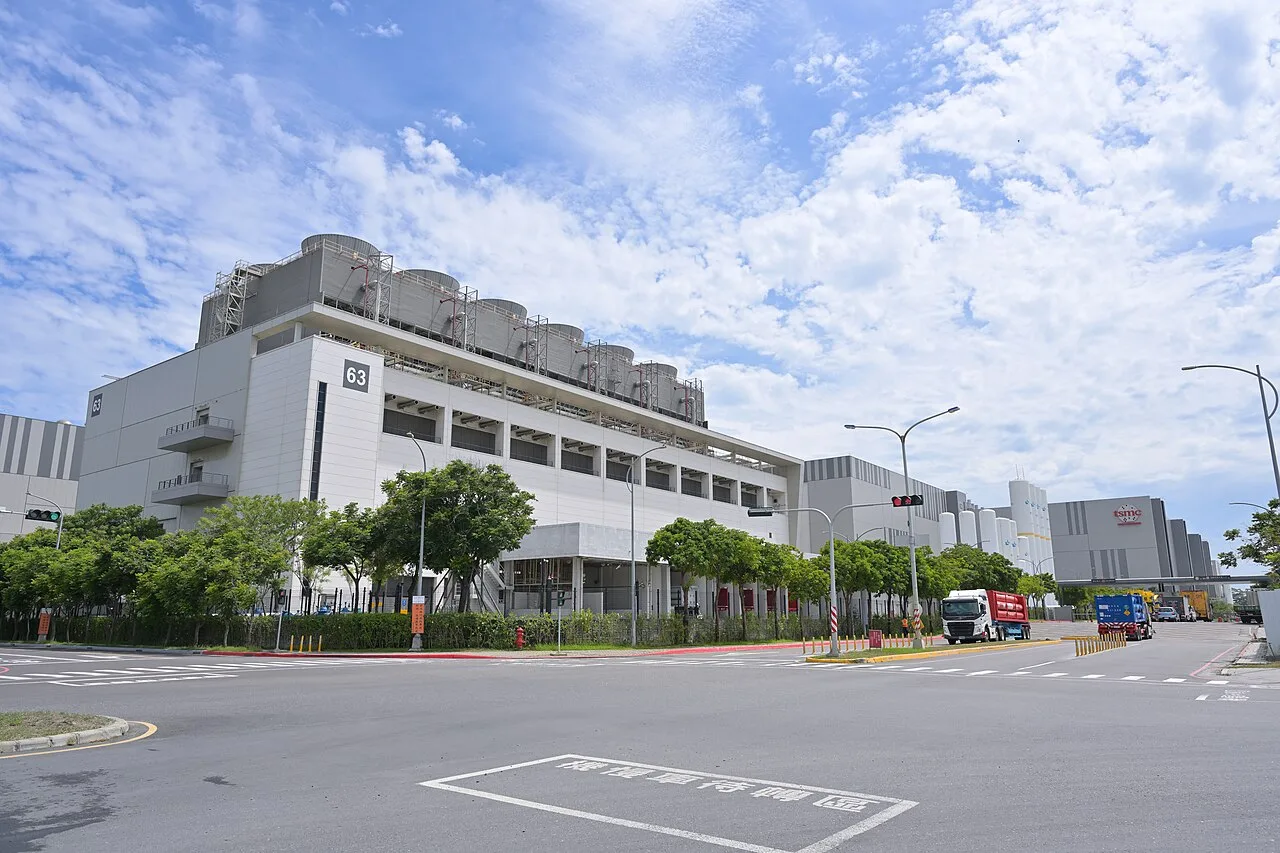
Druga połowa września dwa tysiące dwudziestego szóstego roku zapisze się w kronikach inżynierii materiałowej jako moment, w którym fizyczne granice miniaturyzacji krzemu zostały po raz kolejny zepchnięte w niebyt. Przez niemal dekadę czołowi fizycy ciała stałego oraz sceptyczni analitycy rynkowi wieszczyli ostateczną śmierć prawa Moore’a, argumentując, że zbliżenie się do dystansów międzyatomowych wywoła niekontrolowane zjawiska tunelowania kwantowego, które uniemożliwią budowę stabilnych bramek logicznych. Odpowiedź tajwańskiego giganta Taiwan Semiconductor Manufacturing Company nadeszła jednak w sposób bezprecedensowy. Podczas ściśle strzeżonego, zamkniętego sympozjum technologicznego w Hsinchu kierownictwo koncernu po raz pierwszy zademonstrowało w pełni operacyjne struktury krzemowe wykonane w nowatorskim procesie litograficznym A14, schodzącym głęboko poniżej bariery półtora nanometra i otwierającym nową epokę w architekturze akceleratorów sztucznej inteligencji.
Skala tego osiągnięcia wykracza daleko poza tradycyjne, stopniowe zagęszczanie siatki tranzystorów, do jakiego branża przywykła w trakcie ewolucji od litografii pięciu nanometrów do węzła dwóch nanometrów. Proces A14 stanowi całkowite zerwanie z dotychczasową anatomią układu scalonego, wprowadzając hybrydową architekturę trójwymiarowych nanowstęg w połączeniu z zasilaniem poprowadzonym od spodu struktury krystalicznej oraz zintegrowanymi złączami fotonicznymi bezpośrednio na poziomie krzemu. W ten sposób rozwiązano problem, który od ponad trzech lat dławił rozwój klastrów obliczeniowych najnowszej generacji: katastrofalną degradację energetyczną wynikającą z oporności miniaturowych ścieżek miedzianych oraz barierę przepustowości magistrali komunikacyjnych łączących rdzenie obliczeniowe z pamięcią o wysokiej przepustowości.
Nie bez znaczenia pozostaje również idealna synchronizacja tego ogłoszenia z postępami holenderskiego monopolisty litograficznego ASML. Równolegle z prezentacją w Hsinchu, z centrali w Veldhoven nadeszło oficjalne potwierdzenie rozpoczęcia dostaw seryjnych skanerów litograficznych Twinscan EXE:5200B o aperturze numerycznej zero przecinek pięćdziesiąt pięć, przystosowanych do naświetlania nowo standaryzowanych, dwunastocalowych fotomasek. Połączenie holenderskiego mistrzostwa optycznego z bezwzględną precyzją produkcyjną tajwańskich gigafabryk wywołało szok na światowych rynkach finansowych, zmuszając amerykańskich konkurentów z korporacji Intel do natychmiastowej rewizji własnych harmonogramów wdrożeniowych i stawiając pod znakiem zapytania dotychczasową strategię reindustrializacji Zachodu.
Aby pojąć rewolucyjny charakter węzła A14, należy cofnąć się do fundamentalnych ograniczeń, z którymi inżynierowie zderzyli się przy masowej produkcji układów w litografii N2 oraz N3. Dotychczasowa technologia bramek otaczających kanał ze wszystkich stron, powszechnie określana w nomenklaturze inżynierskiej jako Gate-All-Around lub nanosheet, pozwoliła na skuteczne powstrzymanie ucieczki ładunków elektrycznych na poziomie pojedynczego tranzystora, lecz pozostawiła nietknięty problem tak zwanego wąskiego gardła interkonektów. W miarę jak wymiary bramek kurczyły się do kilkunastu nanometrów, przekrój poprzeczny miedzianych przewodów doprowadzających prąd i sygnały logiczne stał się tak mikroskopijny, że zjawisko rozpraszania elektronów na granicach ziaren metalu doprowadziło do gigantycznego wzrostu oporności pasożytniczej oraz wydzielania niszczycielskich ilości ciepła.
W układach klasy serwerowej, takich jak współczesne procesory graficzne pobierające ponad tysiąc watów mocy na pojedynczą obudowę, ponad jedna trzecia energii elektrycznej była marnowana wyłącznie na pokonanie oporu wewnętrznych warstw metalizacji, zanim prąd w ogóle dotarł do właściwych bramek logicznych. Dodatkowo, plątanina mikroskopijnych ścieżek zasilających i sygnałowych umieszczonych na tej samej stronie płytki krzemowej tworzyła potężne zakłócenia elektromagnetyczne, zmuszając projektantów do obniżania częstotliwości taktowania i stosowania skomplikowanych układów ekranujących. Węzeł A14 eliminuje ten problem poprzez zastosowanie bezkompromisowej separacji fizycznej: cała sieć zasilająca została przeniesiona na drugą, dolną stronę wafla krzemowego, uwalniając wierzchnią warstwę wyłącznie dla ultraszybkich magistrali transmisji danych.
Zastosowanie w węźle A14 ulepszonych nanowstęg o zmiennej szerokości pozwala projektantom na dynamiczne dostrajanie parametrów poszczególnych komórek logicznych w zależności od ich funkcji. W blokach odpowiedzialnych za operacje zmiennoprzecinkowe stosuje się szersze wstęgi zapewniające maksymalną wydajność prądową i bezprecedensowe taktowanie przekraczające cztery gigaherce w warunkach chłodzenia cieczą, podczas gdy w sekcjach pamięci podręcznej SRAM inżynierowie wykorzystują wstęgi wąskie, minimalizujące prądy upływu w stanach bezczynności. Z testów laboratoryjnych wynika, że nowa struktura zapewnia ponad trzydziestoprocentowy wzrost efektywności energetycznej w porównaniu z procesem N2P przy zachowaniu identycznej powierzchni matrycy krzemowej.
Architektura NanoFlex Super Power Rail: Koniec z dławieniem miedzi
Kluczowym filarem sukcesu nowej litografii jest technologia określana mianem NanoFlex Super Power Rail, stanowiąca najbardziej zaawansowaną na świecie komercyjną implementację zasilania tylnego typu Backside Power Delivery. Dotychczasowe próby wdrożenia tego rozwiązania, podejmowane przez konkurencję w ramach wcześniejszych generacji układów testowych, napotykały na gigantyczne bariery technologiczne związane z precyzyjnym przewiercaniem wafla krzemowego za pomocą tak zwanych przelotek krzemowych nano-TSV. Średnica tych miniaturowych pionowych tuneli musiała wynosić zaledwie kilkadziesiąt nanometrów, a błąd ich centrowania względem bramek umieszczonych po przeciwnej stronie nie mógł przekraczać ułamka nanometra.
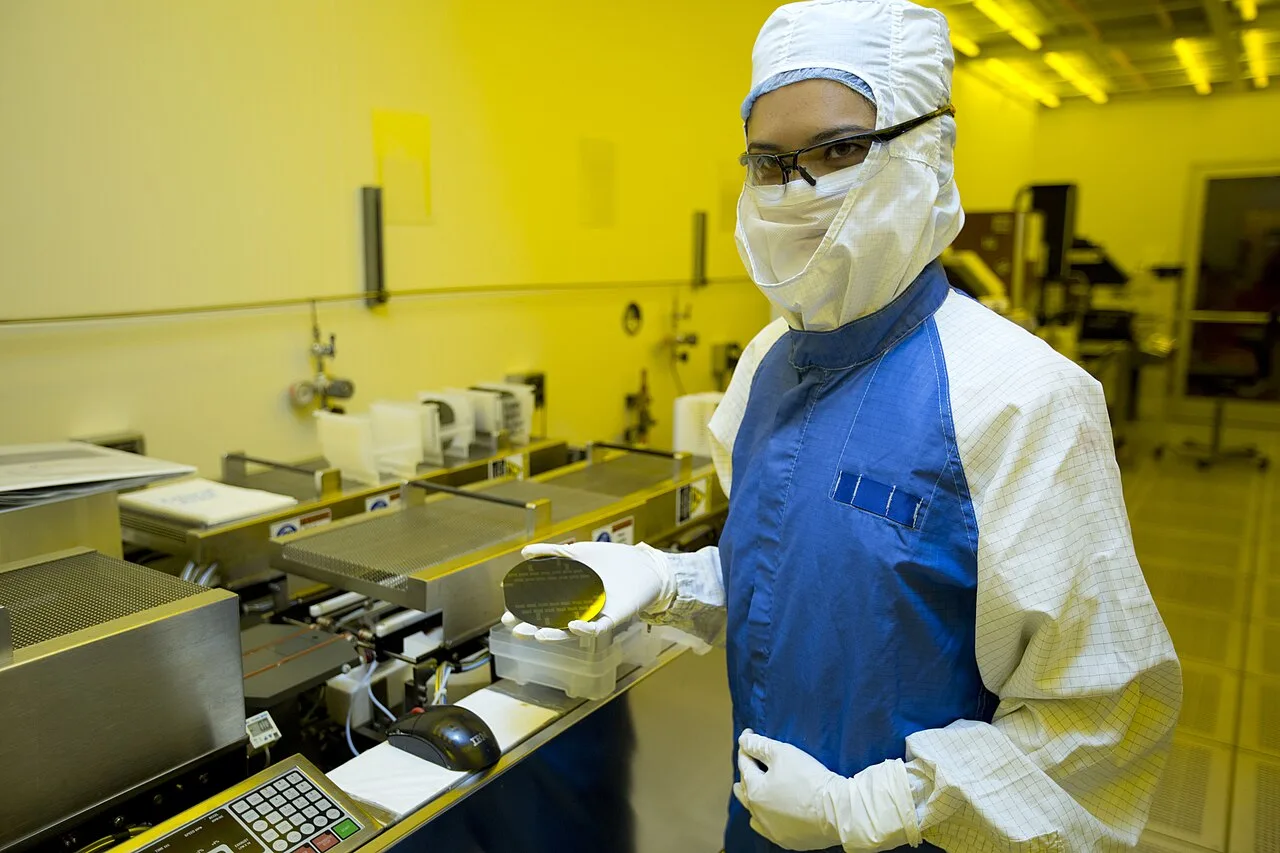
TSMC rozwiązało to zadanie poprzez zastosowanie nowatorskiego procesu chemiczno-mechanicznego polerowania oraz fuzji materiałowej, w ramach której wafel zawierający uformowane tranzystory jest odwracany i łączony z nośnym waflem krzemowym, a następnie szlifowany od tyłu aż do odsłonięcia styków źródła i drenu z dokładnością atomową. Dopiero na tak przygotowaną powierzchnię nanoszona jest gruba, niskorezystancyjna warstwa metalizacji rutenowej, która doprowadza prąd bezpośrednio do elementów wykonawczych bez konieczności przechodzenia przez kilkanaście pięter wąskich ścieżek logicznych. W efekcie spadek napięcia roboczego, powszechnie znany jako zjawisko IR-drop, został zredukowany o ponad siedemdziesiąt pięć procent.
Zastosowanie rutenowych oraz molibdenowych warstw przewodzących w miejsce konwencjonalnej miedzi stanowi jedno z najbardziej wyrafinowanych osiągnięć metalurgii nanometrycznej. Miedź w skrajnie cienkich przekrojach cierpi na drastyczny wzrost oporności ze względu na rozpraszanie elektronów o ścianki dielektryka barierowego. Ruten charakteryzuje się znacznie krótszą średnią drogą swobodną nośników ładunku, co oznacza, że przy wymiarach poniżej dziesięciu nanometrów przewodzi prąd ze znacznie mniejszymi stratami omowymi. Dzięki temu inżynierowie TSMC mogli zredukować grubość warstw pośrednich bez ryzyka wystąpienia zjawiska elektromigracji, które we wcześniejszych układach scalonych prowadziło do powstawania pustek materiałowych i przedwczesnego przepalania się mikroskopijnych połączeń pod wpływem wysokich gęstości prądu.
Z perspektywy architektów megawatowych klastrów obliczeniowych ta modyfikacja ma znaczenie fundamentalne. Brak spadków napięcia oznacza, że akcelerator może pracować przy znacznie niższym napięciu bazowym, co przekłada się na drastyczne obniżenie całkowitego poboru mocy w przeliczeniu na pojedynczą operację inferencyjną. Co więcej, uwolnienie górnej powierzchni krzemu pozwoliło na zagęszczenie ścieżek sygnałowych o niemal czterdzieści procent, co umożliwiło rozbudowę wewnętrznych magistrali danych do szerokości niespotykanych dotychczas w architekturze układów monolitycznych. Układ krzemowy przestaje być piecem marnującym energię na opór pasożytniczy, a staje się precyzyjnym instrumentem o sprawności energetycznej bliskiej teoretycznym maksimom termodynamicznym.
Optyka współpakowana CPO: Światłowody wtopione bezpośrednio w krzem
Drugim rewolucyjnym filarem zaprezentowanym podczas sympozjum w Hsinchu jest bezpośrednia integracja optyki współpakowanej, znanej powszechnie pod akronimem CPO, czyli Co-Packaged Optics. Przez ostatnie dekady cała komunikacja między procesorami w centrach danych opierała się na sygnałach elektrycznych wędrujących przez ścieżki na laminacie płyty głównej, miedziane kable Direct Attach Copper oraz gniazda PCIe. W erze modeli sztucznej inteligencji liczących setki miliardów parametrów, gdzie w trakcie jednej sekundy klastry muszą wymieniać terabajty gradientów wag i stanów uwagi, miedź dotarła jednak do ściany praw fizyki. Tłumienie sygnałów elektrycznych o częstotliwościach rzędu stu gigaherców na odcinku kilkunastu centymetrów stało się tak potężne, że tradycyjne transceivery zużywały więcej prądu niż same rdzenie obliczeniowe.
W procesie A14 tajwańscy inżynierowie zintegrowali miniaturowe falowody krzemowe, modulatory Mach-Zehndera oraz lasery na bazie fosforku indu bezpośrednio w strukturze zaawansowanego podłoża pośredniego interposer w ramach technologii pakowania CoWoS-X. Zamiast wyprowadzać sygnały elektryczne na zewnętrzne złącza, dane z rdzeni logicznych trafiają natychmiast do zintegrowanego silnika optycznego, który zamienia strumień elektronów w wiązki fotonów o różnych długościach fal i przesyła je bezpośrednio elastycznymi wstęgami światłowodowymi wprost do sąsiednich szaf serwerowych. Przepustowość pojedynczego modułu obliczeniowego osiągnęła niewiarygodną wartość trzech przecinek dwóch terabita na sekundę na milimetr krawędzi układu, co stanowi ponad czterokrotny skok względem standardu PCIe siódmej generacji.
Fundamentalnym wyzwaniem w konstrukcji modułów optyki współpakowanej było dotychczas odprowadzanie ciepła z delikatnych struktur laserowych. Lasery półprzewodnikowe wykazują skrajną wrażliwość na dryft temperaturowy; wzrost temperatury powyżej osiemdziesięciu stopni Celsjusza prowadzi do gwałtownego spadku wydajności kwantowej oraz rozmycia długości fali generowanego światła, co w gęstych siatkach zwielokrotnienia falowego WDM wywołuje nieakceptowalne przesłuchy między kanałami transmisyjnymi. W architekturze A14 problem ten rozwiązano poprzez stworzenie mikrokanalikowego systemu chłodzenia cieczą wykonanego bezpośrednio w warstwie krzemu nośnego. Chłodziwo dielektryczne opływa spód podłoża fotonicznego z prędkością kilku metrów na sekundę, utrzymując temperaturę emiterów optycznych w stabilnym reżimie pięćdziesięciu stopni Celsjusza, nawet w sytuacji, gdy sąsiadujące rdzenie tensorowe wydzielają punktowo ciepło o gęstości przekraczającej trzysta watów na centymetr kwadratowy.
Ta zmiana paradygmatu całkowicie dekonstruuje architekturę współczesnych centrów danych. Dzięki eliminacji miedzianych interkonektów opóźnienia w transmisji danych między tysiącami akceleratorów spadły z setek nanosekund do wartości poniżej pięciu nanosekund, tworząc iluzję pracy na jednym gigantycznym, rozproszonym procesorze wielkości całego budynku serwerowni. Co więcej, usunięcie ciężkich miedzianych wiązek kablowych i zewnętrznych transceiverów optycznych pozwoliło na zmniejszenie oporów przepływu powietrza i chłodziwa w szafach serwerowych, otwierając drogę do projektowania ultrakompaktowych klastrów o gęstości mocy przekraczającej sto pięćdziesiąt kilowatów na szafę rackową.
ASML Twinscan EXE:5200B i triumf dwunastocalowych fotomasek
Wdrożenie tak skrajnie wyrafinowanej architektury nie byłoby fizycznie możliwe bez przełomu w technologii litograficznej, którego autorem jest holenderski gigant ASML. Wprowadzenie skanerów pierwszej generacji High-NA EUV o aperturze numerycznej zero przecinek pięćdziesiąt pięć wiązało się bowiem z potężnym kompromisem inżynieryjnym: ze względu na geometrię luster optyki refleksyjnej Zeissa maksymalne pole naświetlania zostało zmniejszone o połowę, do zaledwie dwudziestu sześciu na szesnaście i pół milimetra. Dla producentów gigantycznych procesorów sztucznej inteligencji oznaczało to koszmar produkcyjny konieczności łączenia dwóch masek w procesie naświetlania pojedynczej matrycy krzemowej, co drastycznie obniżało uzysk sprawnych struktur i windowało koszty do astronomicznych poziomów.
Odpowiedzią na ten kryzys jest zaprezentowany właśnie system ASML Twinscan EXE:5200B, który został od podstaw zaprojektowany do współpracy z nowym formatem dwunastocalowych fotomasek kwarcowych, zastępujących stosowany od ponad dwóch dekad standard sześciocalowy. Nowy skaner wykorzystuje zaawansowany stolik reticle poruszający się z przyspieszeniem sięgającym trzydziestu g, co w połączeniu ze źródłem światła ekstremalnego ultrafioletu o mocy ośmiuset watów pozwala na naświetlanie ponad dwustu dwudziestu wafli na godzinę. Zwiększenie pola maski pozwoliło na powrót do naświetlania pełnowymiarowych matryc wielochipowych za jednym podejściem, eliminując błędy zszywania i podnosząc uzysk produkcyjny o ponad dwadzieścia pięć punktów procentowych.
Koszt pojedynczego egzemplarza maszyny EXE:5200B przekracza obecnie trzysta osiemdziesiąt milionów euro, co czyni ją najdroższym instrumentem przemysłowym w dziejach ludzkości. Jednak w rachunku ekonomicznym megakorporacji technologicznych inwestycja ta zwraca się błyskawicznie. Możliwość wyprodukowania jednolitego akceleratora o powierzchni przekraczającej tysiąc milimetrów kwadratowych w jednym cyklu naświetlania pozwala na zredukowanie kosztu jednostkowego procesora nowej generacji o niemal połowę w stosunku do architektur składanych z wielu mniejszych klocków krzemowych. TSMC zabezpieczyło już ponad osiemdziesiąt procent mocy produkcyjnych holenderskich zakładów na najbliższe trzy lata, blokując dostęp do najnowocześniejszych narzędzi konkurencji z Azji i Stanów Zjednoczonych.
Starcie gigantów: TSMC kontra Intel Foundry i pętla opóźnień 18A
Prezentacja procesu A14 przez TSMC wywołała natychmiastowe tąpnięcie na parkietach giełdowych i postawiła w niezwykle trudnej sytuacji amerykański koncern Intel. Amerykanie przez ostatnie dwa lata budowali swój wielki powrót na pozycję lidera w oparciu o węzeł produkcyjny 18A oraz zaawansowaną technologię zasilania PowerVia, twierdząc, że ich przewaga we wczesnym wdrożeniu pierwszych maszyn High-NA EUV pozwoli na zdetronizowanie Tajwańczyków do końca dwa tysiące dwudziestego szóstego roku. Choć Intel zdołał uruchomić pilotażowe linie produkcyjne układów Panther Lake i podpisał strategiczne kontrakty z Departamentem Obrony USA oraz dostawcami chmurowymi, to parametry zaprezentowane przez TSMC w procesie A14 całkowicie deklasują amerykańską ofertę.
Główną słabością strategii Intela okazało się przywiązanie do tradycyjnych interkonektów elektrycznych oraz problemy z uzyskiem produkcyjnym przy wielkich matrycach obliczeniowych. Węzeł 18A doskonale sprawdza się w procesorach konsumenckich o umiarkowanej powierzchni, lecz przy próbach wytwarzania gigantycznych układów akceleracyjnych wskaźnik sprawnych chipów spadał poniżej krytycznej granicy opłacalności. Dodatkowo, brak dojrzałego ekosystemu optyki współpakowanej zmusił klientów Intela do stosowania zewnętrznych kontrolerów optycznych, co niwelowało zyski wynikające z zastosowania zasilania tylnego. TSMC, dysponując sprawdzoną platformą CoWoS oraz pełnym portflem patentów na falowody krzemowe, zaoferowało klientom kompletny, zintegrowany produkt gotowy do natychmiastowego montażu w szafach serwerowych.
W kuluarach Doliny Krzemowej mówi się otwarcie, że najwięksi amerykańscy giganci technologiczni, w tym Nvidia, Apple, AMD oraz laboratoria trenujące modele graniczne, podjęli już decyzję o zarezerwowaniu niemal wszystkich dostępnych linii produkcyjnych A14 na lata dwa tysiące dwadzieścia siedem i dwa tysiące dwadzieścia osiem. Próby administracji w Waszyngtonie, mające na celu zmuszenie korporacji do przeniesienia zamówień do fabryk Intela w Ohio i Arizonie w ramach patriotyzmu technologicznego, rozbiły się o twarde realia rynkowe: w epoce brutalnego wyścigu o dominację w sztucznej inteligencji żadne laboratorium nie może pozwolić sobie na używanie układów o trzydzieści procent wolniejszych i bardziej energochłonnych niż procesory konkurencji.
Zestawienie parametrów technicznych i fizycznych węzłów produkcyjnych
Aby zobrazować gigantyczny skok technologiczny, jaki dokonał się na przestrzeni ostatnich dwóch lat, poniższa tabela zestawia kluczowe parametry inżynieryjne dominujących węzłów litograficznych, ukazując rewolucję w architekturze zasilania oraz integracji optycznej.
| Węzeł i Producent | Architektura Bramki | Metoda Zasilania | Apertura Litografii (NA) | Gęstość Tranzystorów (MTr/mm²) | Zintegrowana Optyka |
|---|---|---|---|---|---|
| TSMC N3E (Tajwan) | FinFET 3D | Klasyczne zasilanie przednie (Frontside) | 0.33 EUV standard | 215 | Brak (Zewnętrzne moduły transceiverów) |
| TSMC N2P (Tajwan) | Nanosheet GAA (4 wstęgi) | Frontside zoptymalizowany | 0.33 EUV standard | 280 | Brak (Hybrydowe podłoża organiczne) |
| Intel 18A (USA) | RibbonFET GAA | PowerVia (Backside zasilanie tylne) | 0.55 High-NA wczesna faza | 295 | Opcjonalne mostki EMIB CPO |
| TSMC A14 (Tajwan) | NanoFlex GAA 2.0 | Super Power Rail (Zaawansowane BPD) | 0.55 High-NA seryjna (12" maski) | 385 | Natywna optyka współpakowana CoWoS-X |
Dane zebrane w tabeli bezlitośnie obnażają skalę przewagi, jaką osiągnęło TSMC w procesie A14. Gęstość upakowania tranzystorów na poziomie trzystu osiemdziesięciu pięciu milionów na milimetr kwadratowy oznacza faktyczne podwojenie zasobów logicznych w stosunku do powszechnie stosowanego węzła N3E. Jednak to nie sama gęstość, lecz połączenie zasilania tylnego z natywną optyką współpakowaną tworzy nową jakość inżynieryjną, umożliwiając tworzenie struktur o łącznej liczbie bilionów tranzystorów zasilanych i chłodzonych w sposób stabilny w warunkach przemysłowych.
Geopolityczne echo w Cieśninie Tajwańskiej i wyścig o frontier obliczeniowy
Sukces litograficzny w Hsinchu niesie ze sobą potężne reperkusje geopolityczne, które natychmiast stały się przedmiotem tajnych analiz w Radzie Bezpieczeństwa Narodowego w Waszyngtonie oraz w sztabach generalnych w Pekinie. Fakt, że jedyne fabryki zdolne do wytwarzania procesorów węzła A14 znajdują się w zasięgu chińskich rakiet balistycznych i artylerii rakietowej na zachodnim wybrzeżu Tajwanu, drastycznie podnosi stawkę w globalnej grze o utrzymanie pokoju w Cieśninie Tajwańskiej. Tak zwana krzemowa tarcza, która przez lata chroniła wyspę przed inwazją, stała się jeszcze twardsza, lecz jednocześnie ryzyko ewentualnego uderzenia wyprzedzającego ze strony Chin uległo drastycznemu przewartościowaniu.
Pekin, odcięty od zachodnich maszyn High-NA EUV przez sankcje technologiczne Stanów Zjednoczonych i Holandii, próbuje desperacko nadrobić dystans poprzez wielokrotne naświetlanie starszymi skanerami DUV oraz budowę gigantycznych klastrów opartych na tysiącach mniej wydajnych układów krajowej produkcji SMIC. Jednak różnica w efektywności energetycznej między węzłem A14 a chińskimi chipami siedmiu nanometrów jest tak miażdżąca, że chińskie centra danych potrzebują niemal sześciokrotnie więcej energii elektrycznej i powierzchni serwerowej, by osiągnąć tę samą moc obliczeniową. W realiach wyścigu o stworzenie sztucznej inteligencji ogólnego przeznaczenia AGI ten deficyt fizyczny przekłada się bezpośrednio na tempo badań i symulacji naukowych.
Dla zachodnich decydentów sytuacja ta tworzy bolesny paradoks strategiczny. Z jednej strony amerykańskie laboratoria zyskują dostęp do bezprecedensowej mocy obliczeniowej, która pozwala na trenowanie modeli kolejnej generacji przy niższych kosztach i zużyciu prądu. Z drugiej strony, całkowita zależność Zachodu od pojedynczej wyspy na Pacyfiku w segmencie najbardziej krytycznego surowca dwudziestego pierwszego wieku czyni globalną gospodarkę skrajnie wrażliwą na jakikolwiek incydent morski, blokadę kwarantannową czy awarię podmorskich kabli światłowodowych łączących Tajpej z resztą świata.
Podsumowanie: Nowy fundament dla cyfrowej cywilizacji
Zaprezentowanie przez TSMC i ASML technologii węzła A14, zasilania tylnego NanoFlex oraz optyki współpakowanej definitywnie zamyka epokę spekulacji na temat rychłego końca postępu w dziedzinie sprzętu komputerowego. Prawa fizyki po raz kolejny okazały się bardziej elastyczne, niż sądzili dogmatyczni teoretycy, ustępując przed geniuszem inżynierii materiałowej, nanotechnologii i precyzyjnej optyki kwantowej. Tranzystor zasilany od tyłu i komunikujący się za pomocą światła staje się nową cegiełką, na której budowany będzie cały cyfrowy gmach nadchodzących dziesięcioleci.
Dla architektów systemów sztucznej inteligencji, inżynierów chmurowych oraz liderów światowego biznesu przesłanie płynące z Hsinchu jest jednoznaczne: wąskie gardła sprzętowe, które przez ostatnie kwartały spowalniały skalowanie modeli autonomicznych i wymuszały bolesne cięcia kontekstu, wkrótce przestaną istnieć. Wkraczamy w fazę, w której koszt pojedynczego tranzystora i pojedynczego dżula zużytego na operację matematyczną spadnie do poziomów umożliwiających ciągłe działanie milionów wirtualnych inżynierów na całym globie. Wygrają ci, którzy najszybciej zrozumieją architekturę tego krzemowego przewrotu i bez wahania zintegrują go ze swoimi strukturami produkcyjnymi.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.