
Krzemowe fotoniki i optyczne interkonekty chipletów: Jak światłowody wewnątrz procesora przełamują barierę miedzi i prawo Amdahla
Fizyczny kres epoki miedzi w centrach obliczeniowych AI
Przez ponad pół wieku postęp w mikroelektronice napędzany był prawem Moore'a oraz skalowaniem Dennarda, które pozwalały inżynierom na regularne podwajanie liczby tranzystorów w krzemie przy jednoczesnym obniżaniu ich poboru mocy i podnoszeniu częstotliwości taktowania. Jednak we współczesnej erze gigantycznych klastrów sztucznej inteligencji, liczących setki tysięcy ściśle ze sobą zsynchronizowanych procesorów graficznych GPU i akceleratorów tensorowych TPU, punkt ciężkości inżynierii komputerowej uległ radykalnemu przesunięciu. Prawdziwym wąskim gardłem systemów obliczeniowych przestała być moc obliczeniowa samych rdzeni arytmetyczno-logicznych ALU, stając się problemem komunikacyjnym: jak błyskawicznie i bez strat przesyłać gigabajty wag modeli i gradientów pomiędzy odległymi układami scalonymi.
W tradycyjnej architekturze komputerowej wszystkie połączenia międzysystemowe: od ścieżek na płytce krzemowej, przez interfejsy pamięci HBM, magistrale PCIe, aż po kable miedziane łączące serwery w szafach rackowych, opierają się na metalicznych przewodnikach miedzianych. Miedź, choć przez dziesięciolecia stanowiła niezawodny standard inżynieryjny, zderzyła się z nieprzekraczalnymi barierami praw elektrodynamiki klasycznej. Przy częstotliwościach transmisyjnych przekraczających sto gigaherców zjawisko naskórkowości skin effect wypycha przepływ prądu na samą powierzchnię przewodnika, drastycznie zwiększając jego rezystancję efektywną. Z kolei straty dielektryczne laminatów PCB oraz pasożytnicze pojemności złączy wywołują potężne tłumienie sygnału, zniekształcenia fazowe oraz przesłuchy elektromagnetyczne crosstalk.
Aby skompensować te straty i zapewnić bezbłędną transmisję danych na odległość zaledwie kilkudziesięciu centymetrów, nowoczesne procesory zmuszone są do stosowania potężnych układów przetworników i regeneratorów sygnału, znanych jako bloki SerDes Serializer/Deserializer. Te mikroskopijne grzałki krzemowe zużywają ponad trzydzieści, a w skrajnych przypadkach czterdzieści procent całego budżetu energetycznego akceleratora, zamieniając cenną energię elektryczną w bezużyteczne ciepło odpadowe. Co gorsza, opóźnienia transmisyjne wprowadzane przez buforowanie i korekcję błędów FEC Forward Error Correction paraliżują operacje kolektywne AllReduce, sprawiając, że tysiące rdzeni obliczeniowych marnuje czas na jałowe oczekiwanie na dostarczenie danych, zgodnie z bezlitosnym prawem Amdahla.
Przełom krzemowej fotoniki: Światło na waflu krzemowym
Jedynym znanym fizyce sposobem na ominięcie bariery przewodnictwa miedzianego jest zastąpienie elektronów fotonami. Światło propagujące się w falowodach dielektrycznych nie podlega zjawiskom rezystancji elektrycznej, pojemności pasożytniczej ani indukcyjności wzajemnej. Pozwala na bezstratne przesyłanie informacji z prędkościami rzędu terabitów na sekundę na dystanse od ułamków milimetra do wielu kilometrów, przy opóźnieniach determinowanych wyłącznie prędkością światła w ośrodku oraz pomijalnym poborze energii.
Przez lata optoelektronika pozostawała jednak domeną drogich, egzotycznych materiałów półprzewodnikowych z grup III-V układu okresowego, takich jak arsenek galu GaAs czy fosforek indu InP, stosowanych w telekomunikacji dalekosiężnej. Ich integracja z masową, krzemową technologią CMOS była uważana za ekonomicznie niewykonalną ze względu na potężne niedopasowanie stałych sieci krystalicznej oraz odmienne reżimy termiczne. Co gorsza, sam krzem posiada skośną przerwę energetyczną indirect bandgap, co oznacza, że elektrony rekombinujące z dziurami oddają energię w postaci drgań sieci krystalicznej fononów, a nie fotonów, uniemożliwiając stworzenie wydajnego lasera z czystego krzemu.
Przełomem stała się konwergencja nanotechnologii i inżynierii materiałowej, sformalizowana w dziedzinie krzemowej fotoniki Silicon Photonics SiPh. Zamiast budować laser z krzemu, inżynierowie nauczyli się integrować mikroskopijne warstwy fosforku indu na standardowych waflach krzemowych za pomocą technologii bezpośredniego klejenia molekularnego wafer bonding w temperaturach pokojowych. Krzem, dzięki swojemu wysokiemu współczynnikowi załamania światła wynoszącemu około 3,45 w paśmie podczerwieni bliskiej 1310 i 1550 nanometrów, okazał się idealnym materiałem do budowy nanometrycznych falowodów optycznych, które potrafią prowadzić wiązkę światła wewnątrz obwodów zintegrowanych z minimalnymi promieniami gięcia bez ucieczki fotonów.
Modulatory Macha-Zehndera i mikropierścienie rezonansowe
Samo wygenerowanie światła laserowego to zaledwie początek procesu; konieczne jest zakodowanie strumienia danych binarnych w strukturze fali elektromagnetycznej z częstotliwościami przekraczającymi sto miliardów bitów na sekundę na jeden kanał barwny. W krzemowej fotonice zadanie to realizują dwa typy nanostruktur optycznych: interferometry Macha-Zehndera MZM Mach-Zehnder Modulators oraz mikropierścienie rezonansowe Micro-Ring Resonators MRR.
Interferometr Macha-Zehndera dzieli wejściową wiązkę laserową na dwa równoległe ramiona falowodowe. W jedno z ramion wstrzykiwane są nośniki ładunku za pośrednictwem złącza p-n, co na mocy zjawiska dyspersji plazmowej zmienia współczynnik załamania światła krzemu i modyfikuje fazę fali świetlnej. Gdy obie wiązki łączą się ponownie na wyjściu interferometru, dochodzi do zjawiska interferencji konstruktywnej reprezentującej logiczną jedynkę lub interferencji destruktywnej gaszącej światło i reprezentującej logiczne zero. Choć modulatory MZM cechują się znakomitą stabilnością temperaturową i szerokim pasmem pracy, ich fizyczna długość sięga kilku milimetrów, co ogranicza gęstość ich upakowania na chipie.
Prawdziwą rewolucją miniaturyzacyjną stały się mikropierścienie rezonansowe. Są to koliste falowody krzemowe o średnicy zaledwie kilku mikrometrów, umieszczone w bezpośredniej bliskości falowodu przelotowego. Przy ściśle określonej długości fali rezonansowej światło zostaje uwięzione w pierścieniu na drodze sprzężenia optycznego evanescent coupling. Subtelna zmiana potencjału elektrycznego pierścienia przestraja jego częstotliwość rezonansową, umożliwiając błyskawiczną modulację amplitudy sygnału. Dzięki miniaturowym rozmiarom, setki mikropierścieni nastrojonych na różne długości fal mogą zostać zintegrowane na pojedynczym milimetrze kwadratowym krzemu w technologii gęstego zwielokrotnienia falowego DWDM Dense Wavelength Division Multiplexing, przesyłając równolegle dziesiątki terabitów danych przez pojedyncze włókno światłowodowe.
Architektura Co-Packaged Optics CPO i rewolucja chipletowa
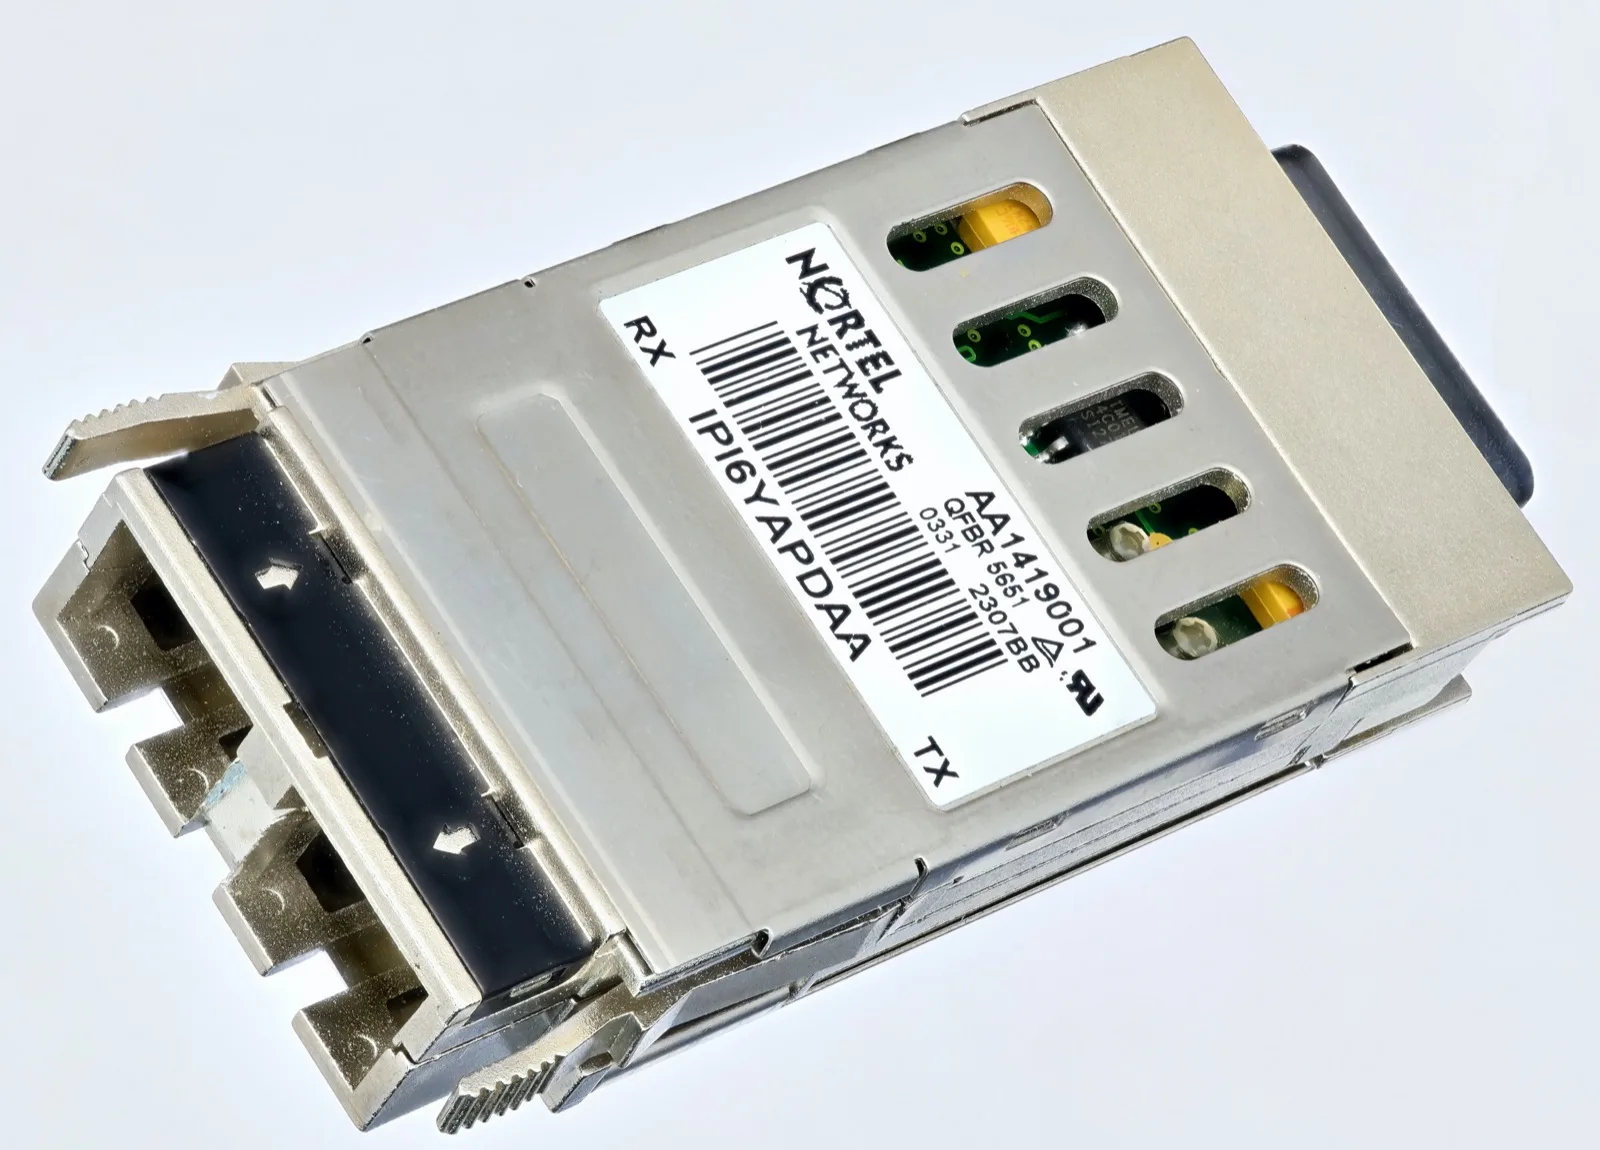
Kluczowym krokiem w ewolucji systemów fotonicznych stała się zmiana sposobu fizycznej integracji optyki z procesorem. Przez lata moduły optyczne miały postać wymiennych wtyczek transiwera pluggable transceivers, montowanych na przednim panelu obudowy serwera rackowego. Choć rozwiązanie to ułatwiało serwisowanie, wymagało prowadzenia sygnałów elektrycznych wysokiej częstotliwości przez kilkadziesiąt centymetrów miedzianych ścieżek płyty głównej, generując potężne straty energetyczne w układach SerDes.
Odpowiedzią przemysłu stała się architektura zintegrowanej optyki współdzielonej Co-Packaged Optics CPO. W podejściu tym wymienny transiwer zostaje całkowicie wyeliminowany, a silnik optyczny Optical Engine w postaci miniaturowego chipletu fotonicznego zostaje umieszczony bezpośrednio wewnątrz tej samej obudowy procesora na wspólnym interposerze krzemowym lub szklanym, zaledwie kilka milimetrów od głównego rdzenia obliczeniowego GPU. Połączenie pomiędzy procesorem logicznym a silnikiem fotonicznym realizowane jest za pomocą ultrakrótkich magistrali dielektrycznych w standardzie UCIe Universal Chiplet Interconnect Express.
Zastosowanie CPO przynosi gigantyczny skok efektywności energetycznej: pobór mocy niezbędny do przesłania jednego bitu informacji spada z kilkunastu pikodżuli w przypadku tradycyjnych transiwerów do poniżej jednego pikodżula na bit. Co więcej, mikroskopijne złącza światłowodowe są wyprowadzane bezpośrednio z obudowy procesora, co pozwala na łączenie tysięcy akceleratorów w jeden spójny superwęzeł obliczeniowy za pomocą pasywnych krosownic światłowodowych bez konieczności stosowania energochłonnych przełączników elektrycznych.
Przełamanie prawa Amdahla i eliminacja zatorów komunikacyjnych
Wpływ krzemowej fotoniki na architekturę klastrów sztucznej inteligencji ma charakter fundamentalny pod względem teorii informatyki. Zgodnie z prawem Amdahla, maksymalne przyspieszenie działania algorytmu równoległego jest ściśle ograniczone przez czas wykonywania jego części sekwencyjnej. W trenowaniu wielkich modeli językowych i systemów wieloagentowych tą sekwencyjną barierą jest faza synchronizacji parametrów, w której wszystkie węzły obliczeniowe muszą wymienić między sobą macierze gradientów przed rozpoczęciem kolejnego kroku optymalizacji stochastycznej SGD.
W klastrach opartych na miedzi czas synchronizacji rośnie wykładniczo wraz z liczbą procesorów, sprawiając, że skalowanie klastra powyżej dziesięciu tysięcy akceleratorów przynosi dramatycznie malejące zyski wydajnościowe. Zastosowanie bezpośrednich optycznych interkonektów chipletowych likwiduje to wąskie gardło. Optyczne matryce przełączające Optical Circuit Switches OCS, oparte na mikroskopijnych zwierciadłach MEMS, pozwalają na dynamiczne rekonfigurowanie topologii sieci światłowodowej w mikrosekundach, dostosowując geometrię połączeń do specyfiki konkretnej warstwy modelu neuronowego.
Eliminacja opóźnień konwersji elektro-optycznej oraz gigantyczna przepustowość interfejsów fotonicznych umożliwiają traktowanie rozproszonego klastra składającego się ze stu tysięcy GPU jak jednego gigantycznego procesora monolitycznego o wspólnej, wirtualnej przestrzeni pamięci. Pozwala to na trenowanie modeli o parametrach liczonych w bilionach wag w czasie o rząd wielkości krótszym i przy ułamku dotychczasowego zużycia energii elektrycznej.
Wyścig gigantów krzemowych: Nvidia, Intel, Broadcom i start-upy optyczne
Znaczenie krzemowej fotoniki sprawiło, że stała się ona głównym polem bitwy patentowej i technologicznej pomiędzy największymi gigantami półprzewodnikowymi globu. Koncern Broadcom zademonstrował pierwsze komercyjne przełączniki sieciowe nowej generacji Bailly o przepustowości 51,2 terabita na sekundę, wykorzystujące technologię CPO zintegrowaną na wspólnym podłożu z układem logicznym. Z kolei Intel, rozwijający badania nad fotoniką od ponad dwóch dekad, wdrożył masową produkcję zintegrowanych laserów hybrydowych na waflach 300 mm, dostarczając miliony złączy optycznych dla hiperskalowych centrów danych.
Równolegle dynamiczny ekosystem innowacji tworzą wyspecjalizowane start-upy, które kwestionują tradycyjną dominację gigantów. Amerykańska firma Ayar Labs zdobyła setki milionów dolarów finansowania od funduszy venture capital i gigantów branży na rozwój optycznych chipletów TeraPHY, zdolnych do transmisji danych z gęstością przekraczającą dwa terabity na milimetr krawędzi układu. Z kolei koncern Lightmatter zaprezentował optyczny procesor Envise oraz matrycę Passage, które wykonują operacje mnożenia macierzy bezpośrednio w domenie optycznej za pomocą interferencji fal świetlnych, eliminując potrzebę cyfrowych obliczeń arytmetycznych w newralgicznych warstwach sieci neuronowych.
Podsumowanie: Nowy świt architektury komputerowej
Krzemowa fotonika to znacznie więcej niż kolejna technologia interkonektów w katalogu komponentów serwerowych. To fundamentalna zmiana paradygmatu fizycznego, na którym opiera się przetwarzanie informacji przez człowieka od czasu wynalezienia pierwszego tranzystora bipolarnego w laboratoriach Bella. Zastąpienie miedzianych ścieżek strumieniami koherentnego światła wewnątrz obudowy mikroprocesora definitywnie przełamuje ograniczenia cieplne i transmisyjne, które groziły zablokowaniem rozwoju sztucznej inteligencji.
Wkraczamy w erę komputerów optoelektronicznych, w których granice pomiędzy procesorem, pamięcią operacyjną a siecią telekomunikacyjną ulegają ostatecznemu zatarciu. Połączenie nanometrowej precyzji litografii krzemowej z nieskończoną przepustowością fotoniki tworzy fundament pod budowę superkomputerów zdolnych do rozwiązywania najbardziej złożonych zagadek współczesnej nauki: od symulacji fuzji jądrowej i projektowania leków molekularnych, po narodziny prawdziwej ogólnej inteligencji sztucznej. Przyszłość krzemu jest ze szkła i światła.
Fotonika w pamięciach masowych: Optyczne łącza CXL i dezagregacja serwerów
Zastosowanie krzemowej fotoniki nie ogranicza się jedynie do komunikacji pomiędzy poszczególnymi rdzeniami obliczeniowymi procesorów graficznych GPU, lecz wywołuje rewolucję w architekturze pamięci masowej i operacyjnej centrów danych. Tradycyjna architektura serwera kasetowego opiera się na sztywnym przypisaniu pamięci RAM i pamięci HBM do konkretnego gniazda procesora. W przypadku zadań sztucznej inteligencji o zróżnicowanej charakterystyce obciążenia prowadzi to do zjawiska tak zwanego uwięzienia pamięci stranded memory: procesor kończy swoje obliczenia, lecz gigabajty przypisanej do niego drogiej pamięci pozostają zablokowane i niedostępne dla sąsiednich węzłów klastra.
Kluczem do rozwiązania tego problemu stał się otwarty standard Compute Express Link CXL realizowany w domenie optycznej CXL-over-Optics. Zastosowanie optycznych falowodów krzemowych umożliwia wyprowadzenie magistrali pamięci poza obudowę serwera z opóźnieniami mierzonymi w nanosekundach. Pozwala to na fizyczną dezagregację infrastruktury centrum danych: serwery przestają być zwartymi skrzynkami zawierającymi procesor, pamięć i dyski, a stają się wyspecjalizowanymi, niezależnymi basenami zasobów połączonymi matrycą światłowodową.
W architekturze zdezagregowanej klastry sztucznej inteligencji mogą dynamicznie alokować terabajty pamięci operacyjnej z centralnego basenu pamięciowego Memory Pool bezpośrednio do procesora wykonującego wielki model językowy, a po zakończeniu zadania natychmiast zwalniać te zasoby dla innych aplikacji. Optyczna magistrala CXL eliminuje zjawisko kopiowania danych pomiędzy węzłami pamięciowymi, obniżając koszty infrastruktury serwerowej o dziesiątki procent i zapewniając bezprecedensową elastyczność operacyjną hiperskalowym chmurom obliczeniowym.
Integracja heterogeniczna 3D: Przelotki TSV i mikro-słupki miedziane
Osiągnięcie gęstości upakowania niezbędnej do obsługi setek terabitów na sekundę wymagało opuszczenia płaskiej geometrii dwuwymiarowej i przejścia do trójwymiarowego montażu heterogenicznego 3D Packaging. W najnowocześniejszych architekturach chipletowych optyczny silnik fotoniczny PIC Photonic Integrated Circuit oraz układ scalony sterownika elektronicznego EIC Electronic Integrated Circuit nie są już umieszczane obok siebie na interposerze, lecz układane w stos pionowy bezpośrednio jeden na drugim.
Połączenie pomiędzy warstwą elektroniczną a fotoniczną realizowane jest za pomocą gęstych matryc mikro-słupków miedzianych micro-bumps oraz pionowych przelotek przez krzem TSV Through-Silicon Vias o skoku poniżej dziesięciu mikrometrów. Pozwala to na skrócenie długości ścieżek elektrycznych łączących wyjście modulatora z wyjściem wzmacniacza do pojedynczych mikrometrów, co eliminuje straty pojemnościowe i pozwala na osiągnięcie częstotliwości taktowania przekraczających sto gigaherców przy minimalnym napięciu zasilania.
Równolegle kluczowym osiągnięciem inżynierii precyzyjnej stało się opracowanie zautomatyzowanych technologii łączenia włókien światłowodowych z chipem fotonicznym. Zastosowanie nanometrycznych siatek dyfrakcyjnych grating couplers oraz sprzęgaczy krawędziowych edge couplers ze zintegrowanymi soczewkami mikroskopijnymi pozwala na automatyczne zgrzewanie wiązek światłowodowych z waflem krzemowym z dokładnością poniżej stu nanometrów za pomocą szybkich robotów montażowych, co otworzyło drogę do masowej, seryjnej produkcji układów CPO w standardowych fabrykach półprzewodników.
Standard UCIe i interoperacyjność wielodostawcza chipletów optycznych
Jedną z najpoważniejszych barier hamujących upowszechnienie optyki współdzielonej CPO przez pierwsze lata był brak jednolitych standardów komunikacyjnych pomiędzy procesorami logicznymi a optycznymi silnikami fotonicznymi pochodzącymi od różnych producentów. Każde konsorcjum półprzewodnikowe rozwijało własne, zamknięte protokoły fizyczne i logiczne, co groziło fragmentacją rynku i uzależnieniem odbiorców od pojedynczego dostawcy.
Sytuację zmieniło powołanie i błyskawiczny rozwój otwartego konsorcjum Universal Chiplet Interconnect Express UCIe, zrzeszającego wszystkich kluczowych graczy sektora: od Intela, TSMC i Samsunga, po Nvidię, AMD, Arm i Google. Standard UCIe definiuje zunifikowaną warstwę fizyczną PHY oraz protokoły transmisyjne PCIe 6.0 i CXL 3.1 dla połączeń wewnątrzobudowowych o ultrawysokiej gęstości, zapewniając pełną interoperacyjność matryc krzemowych produkowanych w różnych procesach litograficznych.
Dzięki UCIe projektanci systemów sztucznej inteligencji mogą w elastyczny sposób łączyć rdzenie obliczeniowe wykonane w węźle dwóch nanometrów w fabrykach TSMC z optycznymi chipletami fotonicznymi wyprodukowanymi na waflach 45 nm przez Intela lub GlobalFoundries na wspólnym podłożu krzemowym. Ta modularność klocków lego drastycznie obniża koszty wdrożenia optyki CPO, skracając czas wprowadzenia nowych generacji superkomputerów na rynek i eliminując bariery wejścia dla innowacyjnych start-upów fotonicznych.
Zarządzanie termiczne i stabilizacja temperaturowa laserów mikroprocesorowych
Kolejnym niezwykle złożonym wyzwaniem inżynieryjnym w architekturze CPO jest wrażliwość źródeł laserowych na zmiany temperatury pracy procesora. Nowoczesne układy GPU wydzielają pod pełnym obciążeniem ponad siedemset watów ciepła, co prowadzi do dynamicznych skoków temperatury krzemu w zakresie od czterdziestu do ponad dziewięćdziesięciu stopni Celsjusza w ciągu milisekund. Tymczasem długość fali emitowanej przez laser półprzewodnikowy z fosforku indu dryfuje wraz z temperaturą w tempie około 0,1 nanometra na stopień Celsjusza, co w systemach gęstego zwielokrotnienia DWDM prowadziłoby do natychmiastowego wypadnięcia fali z okna rezonansowego mikropierścienia modulatora.
Aby rozwiązać ten fundamentalny problem fizyczny, inżynierowie wdrożyli architekturę zewnętrznego źródła laserowego ELS External Laser Source. W podejściu tym diody laserowe zostały usunięte z gorącej obudowy procesora i umieszczone w osobnym, chłodzonym modułowo zespole optycznym na krawędzi płyty serwera, skąd koherentne światło jest doprowadzane do chipletu fotonicznego za pomocą pasywnej wiązki światłowodowej. Sam chiplet zawiera z kolei miniaturowe mikrogrzałki krzemowe zintegrowane wokół mikropierścieni rezonansowych, sterowane przez pętlę sprzężenia zwrotnego z mikrosekundowym czasem reakcji, która utrzymuje idealną temperaturę pracy rezonatora optycznego niezależnie od fluktuacji obciążenia termicznego głównego procesora.
Optyczne obliczenia neuromorficzne i macierze tensorowe w domenie światła
Ostatecznym, najbardziej rewolucyjnym horyzontem krzemowej fotoniki jest całkowite wyeliminowanie obliczeń cyfrowych w operacjach algebry liniowej i wykonywanie mnożenia macierzy bezpośrednio w domenie optycznej. W głębokich sieciach neuronowych ponad dziewięćdziesiąt procent wszystkich operacji matematycznych sprowadza się do operacji mnożenia wektora przez macierz GEMM General Matrix Multiply w mechanizmach atencji transformatorowej.
W procesorach optycznych, rozwijanych przez pionierów takich jak Lightmatter czy Boston University, macierz wag wagowych modelu jest kodowana w układzie sprzężonych interferometrów Macha-Zehndera wykonanych z krzemu. Wektor wejściowy jest kodowany jako amplituda lub faza impulsów laserowych wstrzykiwanych do poszczególnych falowodów. Gdy światło propaguje się przez siatkę interferometrów, zjawiska interferencji falowej dokonują fizycznego mnożenia i sumowania sygnałów z prędkością światła, a wynik mnożenia macierzowego pojawia się na fotodetektorach wyjściowych natychmiast, bez jakichkolwiek cykli zegarowych i bez zużycia energii elektrycznej na przełączanie tranzystorów.
Taka architektura obliczeń fotonicznych charakteryzuje się niemal zerowym opóźnieniem inferencji oraz efektywnością energetyczną wyższą o kilka rzędów wielkości niż najbardziej zaawansowane cyfrowe procesory GPU. Choć precyzja obliczeń analogowych w domenie optycznej jest obecnie ograniczona szumami termicznymi do formatów odpowiadających int8 i fp16, w zastosowaniach inferencyjnych wielkich modeli generatywnych jest to dokładność w zupełności wystarczająca, otwierając fascynujący rozdział w ewolucji komputerów napędzanych czystym światłem.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.