
Krzemowa fotonika scalona SiPh i optyczne interkonekty Co-Packaged Optics CPO: Jak modulacja elektro-optyczna na poziomie chipu, lasery DFB i światłowody szklane eliminują wąskie gardła miedzi w centrach danych AI
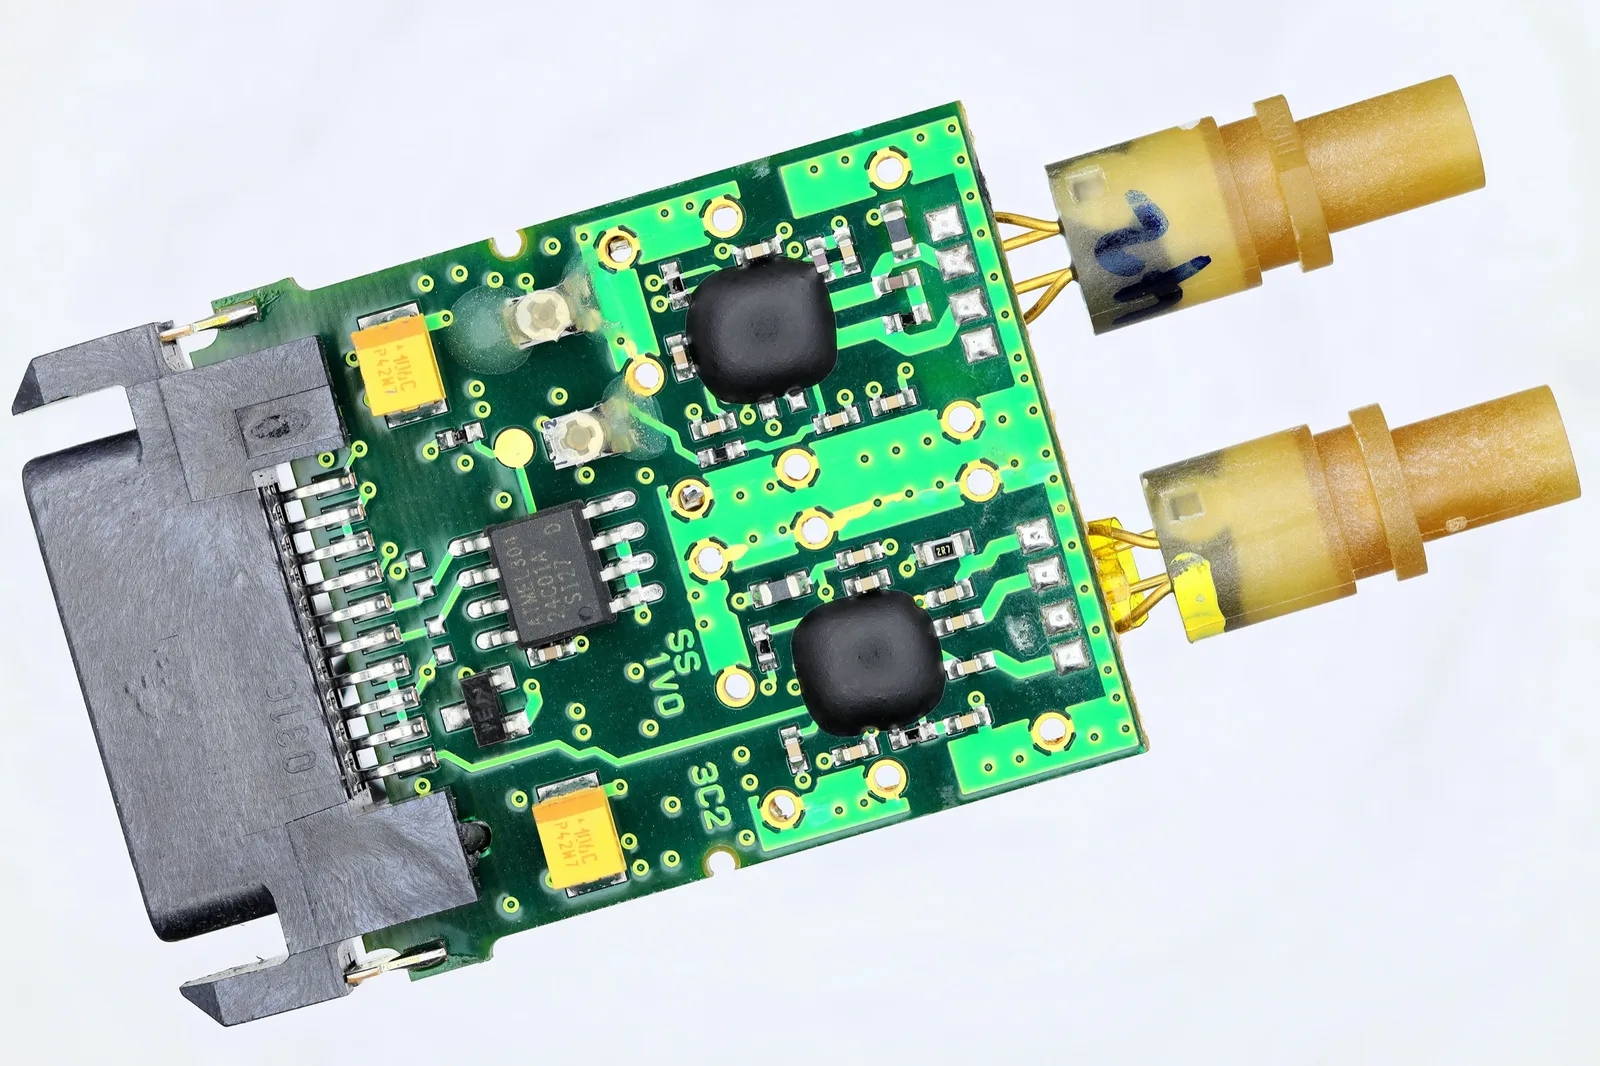
Współczesna rewolucja generatywnej sztucznej inteligencji, napędzana przez gigantyczne modele językowe liczące biliony parametrów, doprowadziła do bezprecedensowego kryzysu w architekturze klastrów obliczeniowych. Podczas gdy moc obliczeniowa akceleratorów graficznych GPU i układów TPU podwaja się co kilkanaście miesięcy dzięki skalowaniu litograficznemu i zaawansowanym technologiom pakowania 2.5D, fizyczna zdolność do przesyłania danych pomiędzy węzłami obliczeniowymi zderzyła się z nieprzekraczalną ścianą fundamentalnych praw elektromagnetyzmu. Miedziane przewodniki elektryczne, będące krwioobiegiem sieci centrów danych od zarania ery cyfrowej, przestały nadążać za zapotrzebowaniem na pasmo.
W gigantycznych fabrykach sztucznej inteligencji AI Factories, liczących dziesiątki tysięcy procesorów połączonych w jednolitą matrycę obliczeniową, opóźnienia komunikacyjne w fazie synchronizacji gradientów podczas treningu rozproszonego (All-Reduce) stają się głównym wąskim gardłem ograniczającym efektywność przetwarzania MFU (Model Flops Utilization). Przesyłanie sygnałów elektrycznych z prędkościami rzędu 112 Gbps i 224 Gbps na linię za pomocą miedzianych ścieżek laminatu płyty głównej wiąże się z katastrofalnym tłumieniem sygnału wynikającym ze zjawiska naskórkowości Skin Effect oraz strat dielektrycznych w laminacie FR4 i Megtron-6.
Aby skompensować te straty, inżynierowie zmuszeni są do stosowania potężnych bloków serializatorów i deserializatorów SerDes wyposażonych w zaawansowane filtry korekcji charakterystyki częstotliwościowej CTLE oraz układy DSP (Digital Signal Processors). Konsekwencje są dramatyczne: w nowoczesnych przełącznikach sieciowych o przepustowości 51,2 Tbps same moduły SerDes i układy odzyskiwania zegara DSP konsumują blisko trzydzieści procent całkowitego budżetu energetycznego urządzenia. Miedź stała się nie tylko zbyt wolna, lecz przede wszystkim zbyt gorąca, by sprostać wymaganiom zrównoważonego rozwoju infrastruktury AI.
Jedyną drogą wyjścia z tego impasu jest zastąpienie nośnika informacji: zamiana powolnych i generujących ciepło elektronów na fotony – cząstki światła poruszające się w bezstratnych falowodach szklanych i krzemowych. Technologia ta, znana jako krzemowa fotonika scalona Silicon Photonics (SiPh) oraz zintegrowana optyka współpakowana Co-Packaged Optics (CPO), wprowadza interkonekty optyczne bezpośrednio do wnętrza obudowy procesora, redukując długość ścieżek miedzianych z kilkudziesięciu centymetrów do ułamka milimetra.
Krzem jako ośrodek optyczny i falowody submikronowe
Przez dekady krzem był uważany za fatalny materiał do zastosowań optoelektronicznych ze względu na swoją strukturę pasmową o pośredniej przerwie energetycznej Indirect Bandgap, która uniemożliwia efektywną emisję fotonów w wyniku rekombinacji promienistej elektron-dziura. Jednak w dziedzinie prowadzenia światła i modulacji sygnałów optycznych krzem okazuje się materiałem niemal idealnym. W oknach telekomunikacyjnych bliskiej podczerwieni (długości fal 1310 nm pasma O oraz 1550 nm pasma C) krzem charakteryzuje się znikomym współczynnikiem pochłaniania światła.
Co najważniejsze, krzem posiada niezwykle wysoki współczynnik załamania światła wynoszący w przybliżeniu n = 3,45. W połączeniu z otaczającym go dwutlenkiem krzemu SiO2 (n = 1,45) tworzy to układ o ogromnym kontraście współczynników załamania Delta n = 2,0. Taki kontrast pozwala na wykonanie falowodów paskowych i żebrowych Strip and Rib Waveguides o submikronowych wymiarach poprzecznych rzędu 450 na 220 nanometrów. Promień skrętu takiego falowodu może wynosić zaledwie kilka mikrometrów bez ryzyka ucieczki światła na zewnątrz, co umożliwia upakowanie setek komponentów optycznych na powierzchni pojedynczego milimetra kwadratowego krzemowego chipu fotonicznego PIC (Photonic Integrated Circuit).
Fundamentalną zaletą technologii SiPh jest możliwość jej wytwarzania w tych samych zaawansowanych liniach produkcyjnych CMOS na waflach krzemowych o średnicy trzystu milimetrów, które służą do masowej produkcji pamięci i procesorów logicznych. Pozwala to na wykorzystanie precyzyjnej litografii immersyjnej DUV, bezbłędnego trawienia plazmowego oraz zautomatyzowanej kontroli jakości na poziomie całego wafla, obniżając jednostkowy koszt wytworzenia transceivera optycznego o rząd wielkości w porównaniu z klasycznymi, ręcznie montowanymi modułami z fosforku indu (InP) czy arsenku galu (GaAs).
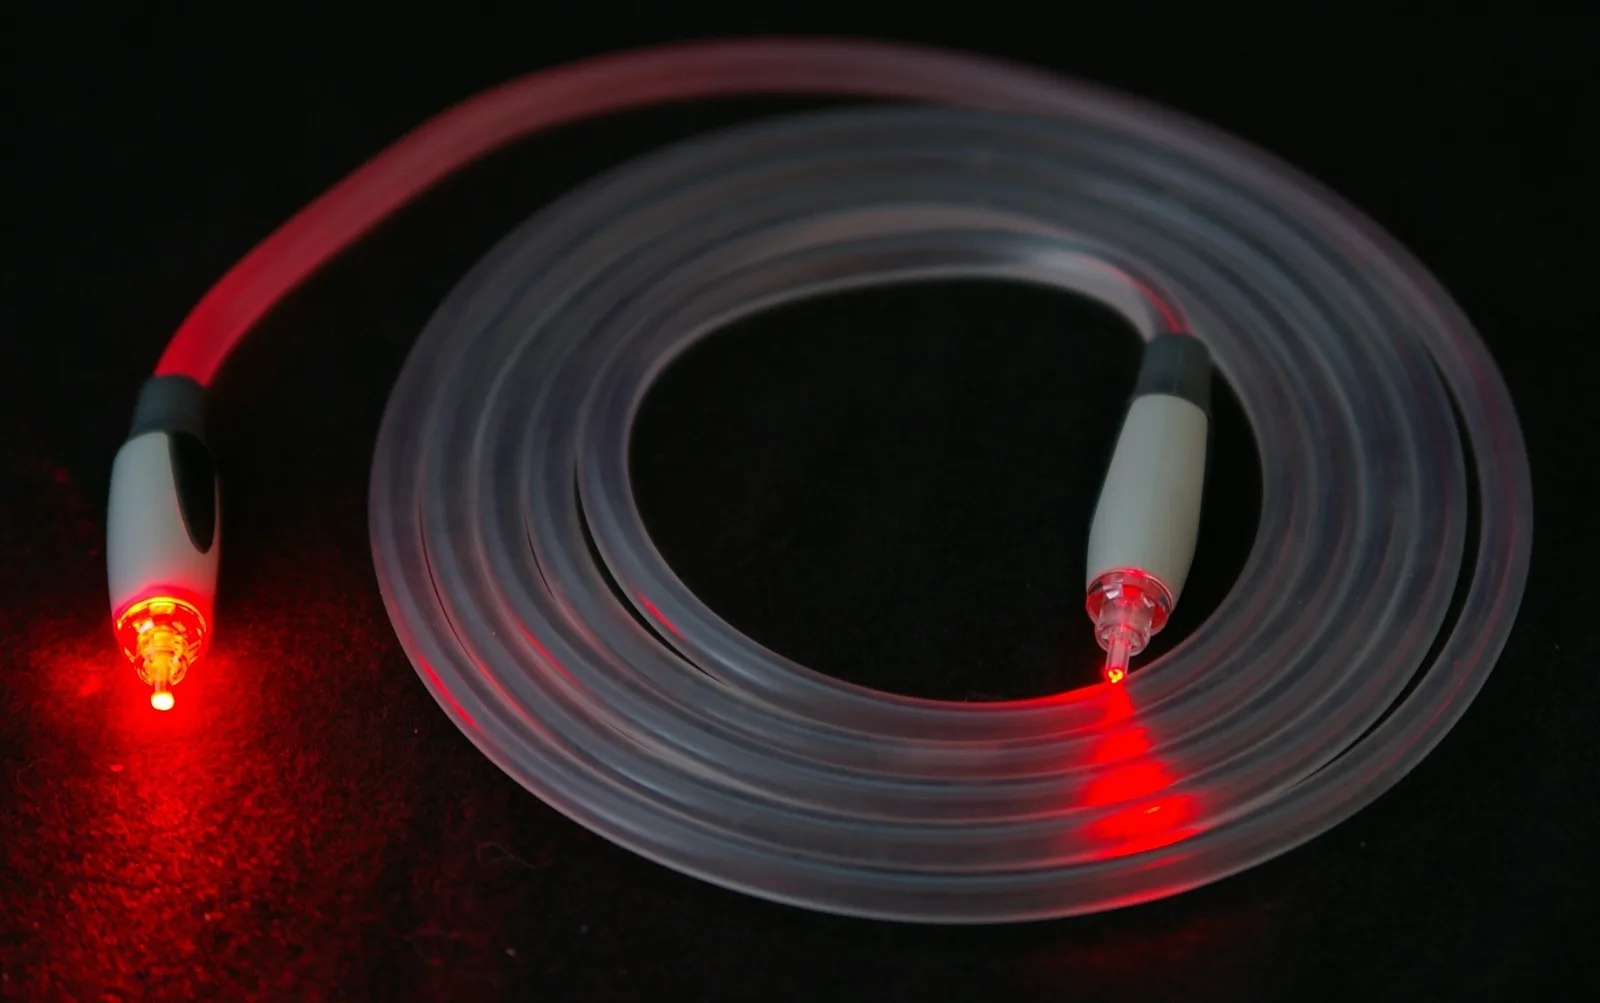
Integracja falowodów krzemowych z warstwami tlenkowymi na waflach typu SOI (Silicon-On-Insulator) stała się standardem przemysłowym. Światło wprowadzone do chipu przemieszcza się z minimalnymi stratami propagacyjnymi poniżej jednego decybela na centymetr, co pozwala na budowę skomplikowanych interferometrów, rezonatorów i filtrów optycznych o niespotykanej dotąd stabilności fazowej.
Modulacja elektro-optyczna: Efekt dyspersji plazmowej i mikrorezonatory pierścieniowe
Aby przekształcić strumień bitów binarnych z procesora w impulsy światła laserowego, fotonika scalona musi dokonać modulacji elektro-optycznej. Ponieważ czysty krzem nie wykazuje liniowego efektu elektrooptycznego Pockelsa z powodu swojej symetrii inwersyjnej, modulacja opiera się na zjawisku dyspersji plazmowej Plasma Dispersion Effect, opisanym przez równania Sorefa i Bennetta. Zmiana gęstości swobodnych nośników ładunku (elektronów i dziur) w krzemie wywołuje bezpośrednią zmianę współczynnika załamania światła oraz współczynnika ekstynkcji.
W tradycyjnych rozwiązaniach stosuje się modulatory Macha-Zehndera (MZM). Wiązka światła jest dzielona na dwa symetryczne ramiona falowodowe; w jednym z ramion zintegrowane złącze p-n pod wpływem napięcia elektrycznego zmienia koncentrację nośników, modyfikując prędkość fazową fali. Po ponownym połączeniu obu ramion dochodzi do interferencji konstruktywnej (stan logiczny 1) lub destruktywnej (stan logiczny 0). Modulatory MZM charakteryzują się znakomitą odpornością na wahania temperatury i szerokim pasmem optycznym, lecz ze względu na słaby efekt elektrooptyczny wymagają ramion o długości od jednego do kilku milimetrów, co ogranicza gęstość ich upakowania.
Prawdziwym przełomem w architekturach ultra-wysokiej gęstości stały się mikrorezonatory pierścieniowe Micro-Ring Resonators (MRR). MRR to okrągły falowód krzemowy o promieniu zaledwie kilku mikrometrów, umieszczony w bliskiej odległości od falowodu magistralnego Bus Waveguide. Gdy długość fali światła odpowiada warunkowi rezonansu (obwód pierścienia jest całkowitą wielokrotnością długości fali w ośrodku), światło jest całkowicie uwięzione w pierścieniu i nie przechodzi do wyjścia. Niewielka zmiana napięcia na złączu pierścienia przesuwa pik rezonansowy, zapewniając modulację o głębokości ponad dziesięciu decybeli.
Dzięki mikrorezonatorom pierścieniowym powierzchnia modulatora kurczy się tysiąckrotnie w porównaniu z MZM, a zużycie energii spada do niewiarygodnego poziomu poniżej kilkudziesięciu femtodżuli na bit (fJ/bit). Co więcej, szeregowe umieszczenie kilku pierścieni o lekko różniących się promieniach wzdłuż jednego falowodu pozwala na bezproblemową realizację zwielokrotnienia falowego WDM (Wavelength Division Multiplexing), gdzie pojedynczym włóknem światłowodowym przesyłane są jednocześnie dziesiątki niezależnych kanałów danych o różnych długościach fal.
Źródła światła: Zewnętrzne lasery DFB i integracja heterogeniczna
Skoro krzem nie potrafi efektywnie emitować światła, skąd bierze się promień laserowy zasilający fotonikę scaloną? W architekturze CPO wykształciły się dwa konkurencyjne, wysoce zaawansowane podejścia inżynieryjne: zewnętrzne moduły laserowe ELSFP (External Laser Small Form-factor Pluggable) oraz heterogeniczna integracja laserów na poziomie wafla.
W podejściu ze źródłem zewnętrznym lasery ze sprzężeniem zwrotnym DFB (Distributed Feedback Lasers) wykonane z fosforku indu (InP) są umieszczone w wymiennych modułach na przednim panelu szafy serwerowej. Światło ciągłe fali nośnej (Continuous Wave CW) jest doprowadzane do procesora GPU i chipów fotonicznych za pomocą pasywnych włókien światłowodowych. Rozwiązanie to ma gigantyczną zaletę operacyjną: lasery są elementami wrażliwymi na wysoką temperaturę, a ich żywotność MTBF drastycznie spada przy pracy w temperaturach powyżej siedemdziesięciu stopni Celsjusza. Umieszczenie ich z dala od rozgrzanych do stu stopni układów GPU pozwala na ich optymalne chłodzenie i bezproblemową wymianę na gorąco Hot-Swap w razie awarii bez zatrzymywania pracy klastra AI.
Z kolei w podejściu integracji heterogenicznej cienkie warstwy epitaksjalne z fosforku indu są bezpośrednio łączone z krzemowym waflem SOI za pomocą wiązania molekularnego Direct Wafer Bonding w temperaturze pokojowej. Promień laserowy jest generowany w materiale III-V, lecz jego mod optyczny ulega evanescentnemu sprzężeniu z leżącym poniżej falowodem krzemowym. Tworzy to monolitowy układ nadawczo-odbiorczy, eliminujący potrzebę zewnętrznych złączy optycznych i minimalizujący straty wtrąceniowe.
Najnowocześniejsze źródła światła wykorzystują lasery wielofalowe oparte na grzebieniach optycznych Optical Frequency Combs (OFC). Pojedynczy laser grzebieniowy zasilany nieliniowym mikropierścieniem z azotku krzemu Si3N4 potrafi wygenerować zjawisko mieszania czterofalowego Four-Wave Mixing, tworząc zbiór kilkudziesięciu idealnie równomiernie rozmieszczonych linii laserowych o częstotliwościach koherentnych fazowo. Zastępuje to baterię kilkudziesięciu oddzielnych laserów DFB jednym mikroskopijnym źródłem światła.
Architektura Co-Packaged Optics CPO: Likwidacja miedzi na wspólnym interposerze
Dotychczasowy paradygmat sieciowy w centrach danych opierał się na wymiennych modułach optycznych Pluggable Transceivers (w standardach QSFP-DD oraz OSFP), instalowanych w gniazdach na przednim panelu przełącznika Top-of-Rack. W tym układzie sygnał elektryczny z procesora przełączającego ASIC musiał pokonać kilkadziesiąt centymetrów miedzianych ścieżek na laminacie płytki drukowanej PCB, przejść przez złącza krawędziowe i trafić do układu DSP wewnątrz modułu optycznego, gdzie był zamieniany na sygnał optyczny.
Architektura Co-Packaged Optics (CPO) całkowicie burzy ten przestarzały schemat. W systemie CPO miniaturowe silniki optyczne Optical Engines (OE) zawierające krzemowy chip fotoniczny PIC oraz niskomocowy sterownik elektroniczny EIC (Electronic Integrated Circuit) są montowane bezpośrednio na tym samym organicznym substracie pakietu lub krzemowym interposerze interkonektowym, tuż obok procesora ASIC lub procesora graficznego.
Zastosowanie technologii zaawansowanego pakowania 2.5D i 3D, takich jak TSMC CoWoS (Chip-on-Wafer-on-Substrate) czy Intel EMIB, pozwala na połączenie procesora z silnikiem optycznym za pomocą mikro-wyprowadzeń Micro-Bumps o rastrze kilkudziesięciu mikrometrów. Długość ścieżki elektrycznej kurczy się z trzydziestu centymetrów do zaledwie kilku milimetrów. Przy tak znikomym dystansie straty sygnału elektrycznego są niemal zerowe, co pozwala na całkowite wyeliminowanie energochłonnych układów DSP i retimerów.
Interfejs elektryczny pomiędzy GPU a silnikiem optycznym może pracować w ultraniskim standardzie energetycznym UCIe (Universal Chiplet Interconnect Express) lub XSR (Extra Short Reach). Zużycie energii na transmisję danych spada z obecnych piętnastu do dwudziestu pikodżuli na bit (pJ/bit) w modułach wymiennych do zaledwie trzech do pięciu pikodżuli na bit w architekturze CPO. Przy skali klastra AI liczącego sto tysięcy GPU oznacza to zaoszczędzenie dziesiątek megawatów mocy zasilania, która może zostać bezpośrednio przekierowana na zasilanie samych rdzeni tensorowych wykonujących obliczenia AI.
Sprzężenie światłowodowe, złącza wysokiej gęstości i topologia Fabric
Wprowadzenie optyki współpakowanej wymusiło także radykalną rewolucję w dziedzinie mechaniki precyzyjnej i złączy światłowodowych. Podłączenie setek włókien szklanych bezpośrednio do obudowy procesora wymaga technik sprzężenia o submikronowej dokładności pozycjonowania. Stosuje się dwie główne metody: sprzęgacze siatkowe Grating Couplers wprowadzające światło prostopadle do powierzchni chipu oraz sprzęgacze krawędziowe Edge Couplers wprowadzające promień przez wypolerowaną krawędź boczną falowodu.
Sprzęgacze krawędziowe z odwróconymi stożkami krzemowymi Inverted Tapers zapewniają wyjątkowo niskie straty wtrąceniowe poniżej pół decybela oraz całkowitą niewrażliwość na polaryzację światła, co czyni je preferowanym rozwiązaniem w systemach o najwyższej przepustowości. Włókna są mocowane w specjalnych precyzyjnych blokach ze szkła krzemionkowego ze żłobkami V-Groove, pozycjonowanymi automatycznie za pomocą aktywnych układów wizyjnych ze sprzężeniem zwrotnym z dokładnością do pięćdziesięciu nanometrów.
Wielkie klastry AI odchodzą od tradycyjnych, wielowarstwowych drzewiastych struktur sieciowych Clos (Spine-Leaf) na rzecz bezpośrednich, optycznych topologii All-to-All oraz Dragonfly+. Dzięki optyce CPO każdy procesor graficzny może posiadać dziesiątki bezpośrednich połączeń światłowodowych z innymi węzłami w klastrze bez konieczności przechodzenia przez pośrednie przełączniki sieciowe. Eliminuje to buforowanie pakietów, zjawisko jitteru i kolizje transmisji, tworząc w pełni deterministyczną pamięć współdzieloną Distributed Shared Memory o zasięgu całego centrum danych.
Wyścig technologiczny, standaryzacja i rewolucja w infrastrukturze sztucznej inteligencji
Wokół krzemowej fotoniki scalonej i CPO rozpętał się jeden z najbardziej zaciętych wyścigów technologicznych w historii branży półprzewodników. Światowi giganci, tacy jak NVIDIA (z projektami fotonicznych interkonektów NVLink nowej generacji), TSMC (ze swoją platformą fotoniczną COUPE – Compact Optical Engine), Intel, Broadcom, Cisco oraz innowacyjne start-upy pokroju Ayar Labs i Celestial AI, inwestują miliardy dolarów w budowę zintegrowanych ekosystemów fotoniczno-elektronicznych.
Konsorcjum Optical Internetworking Forum (OIF) oraz inicjatywa CPO Collaboration opracowały otwarte standardy definiujące interfejsy elektryczne, mechaniczne i optyczne modułów CPO dla przepustowości 3,2 Tbps oraz 6,4 Tbps na pojedynczy silnik optyczny. Standaryzacja ta jest kluczem do stworzenia interoperacyjnego łańcucha dostaw, w którym producenci procesorów, wytwórcy złączy światłowodowych i odlewnie półprzewodników mogą współpracować na zasadach otwartego ekosystemu chipletów.
Przejście na optykę współpakowaną stawia także ogromne wymagania przed systemami chłodzenia cieczą Direct-to-Chip Liquid Cooling. Obecność złączy światłowodowych i delikatnych struktur krzemowych w bezpośrednim sąsiedztwie bloków wodnych z mikrokanalikami chłodzącymi wymaga stosowania zaawansowanych dielektrycznych płynów chłodzących oraz hermetycznych uszczelnień chroniących powierzchnie optyczne przed zanieczyszczeniami chemicznymi i osadami.
Podsumowując, krzemowa fotonika scalona i optyka współpakowana CPO to nie jest zwykła ewolucja technologiczna – to ostateczne pożegnanie z miedzią w wielkich strukturach obliczeniowych. Zastępując elektrony fotonami na poziomie krzemowego substratu, inżynieria komputerowa rozbija fizyczny mur przepustowości, otwierając drzwi do budowy superkomputerów AI o mocach zettaskalowych, zdolnych do trenowania sztucznej inteligencji ogólnej AGI bez ryzyka energetycznego załamania globalnej sieci przesyłowej.
Warto szczegółowo omówić wyzwania związane z dryfem termicznym mikropierścieni rezonansowych MRR w dynamicznie zmieniających się warunkach obciążenia obliczeniowego procesorów GPU. Z powodu wysokiego termooptycznego współczynnika krzemu dn/dT nawet zmiana temperatury o ułamek stopnia Celsjusza powoduje przesunięcie piku rezonansowego poza pasmo fali laserowej. Aby temu zapobiec, inżynierowie integrują na obwodzie pierścienia mikrogrzałki tytanowo-platynowe lub domieszkowane rezystory krzemowe sterowane w zamkniętej pętli ze sprzężeniem zwrotnym zintegrowanym w warstwie sterującej EIC. Układ monitoruje moc odbitą i w czasie mikrosekund dostosowuje temperaturę rezonatora, utrzymując idealne dostrojenie do fali nośnej.
Równocześnie dynamicznie rozwija się zastosowanie materiałów elektrooptycznych nowej generacji, takich jak cienkowarstwowy niobian litu LNOI (Lithium Niobate on Insulator) oraz polimery elektrooptyczne zintegrowane heterogennie z platformą krzemową. Niobian litu posiada potężny współczynnik Pockelsa, umożliwiając bezpośrednią modulację pola elektrycznego bez udziału nośników ładunku. Pozwala to na osiągnięcie częstotliwości modulacji przekraczających sto gigahertzów przy zerowych stratach absorpcyjnych, wyznaczając kolejny krok milowy ku interkonektom optycznym o przepustowościach rzędu wielu terabitów na sekundę na pojedynczej linii transmisyjnej.
Nie ulega wątpliwości, że synergia fotoniki scalonej z zaawansowaną litografią półprzewodnikową wyznacza standard infrastrukturalny na nadchodzące dekady. Zdolność do jednoczesnego zaspokojenia wymagań minimalnego opóźnienia, maksymalnej przepustowości i drastycznego obniżenia zużycia energii sprawia, że technologie CPO i SiPh przestają być eksperymentalną nowinką, a stają się absolutnym imperatywem technologicznym dla każdego podmiotu aspirującego do czołówki globalnego wyścigu sztucznej inteligencji.
Kluczowym elementem toru odbiorczego krzemowego układu fotonicznego są scalone fotodetektory germanowe Ge-on-Si. Czysty krzem jest przezroczysty dla fal o długości 1310 nm i 1550 nm, co uniemożliwia jego wykorzystanie do absorpcji fotonów. Rozwiązaniem stała się epitaksja cienkich warstw czystego germanu na podłożu krzemowym. Mimo niedopasowania stałych sieci krystalicznej o ponad cztery procent, zastosowanie dwustopniowego procesu wzrostu i wyżarzania termicznego pozwala na uzyskanie struktur p-i-n o niezwykle niskim prądzie ciemnym Dark Current i responsywności przekraczającej 0,8 ampera na wat. Pasmo przenoszenia takich fotodiod sięga ponad siedemdziesięciu gigaherców, co pozwala na bezproblemową detekcję sygnałów PAM4 z prędkościami przekraczającymi sto dwadzieścia osiem gigabaudów na pojedynczą linię.
Niezwykle istotnym wyzwaniem przemysłowym pozostaje metrologia i automatyzacja testowania układów fotonicznych na poziomie całego wafla Wafer-Scale Optical Testing. W odróżnieniu od klasycznych układów scalonych, gdzie testy elektryczne realizowane są za pomocą standardowych kart igłowych Probe Cards, testowanie układów PIC wymaga jednoczesnego zasilania elektrycznego i precyzyjnego pozycjonowania światłowodów sprzęgających. Nowoczesne automaty testujące wyposażone są w sześcioosiowe stoliki piezoelektryczne ze sprzężeniem heksagonalnym, które w ciągu ułamka sekundy odnajdują optymalny punkt sprzężenia ze sprzęgaczem siatkowym, mierząc parametry spektralne rezonatorów i straty wtrąceniowe przed skierowaniem wafla do kosztownego procesu cięcia na chiplety i hermetyzacji.
Dalsza ewolucja krzemowej fotoniki scalonej zmierza ku bezpośredniemu wykonywaniu obliczeń matematycznych w domenie optycznej Optical Computing. Zamiast ograniczać się do transmisji danych, matryce programowalnych interferometrów Macha-Zehndera (MZI meshes) mogą realizować mnożenie wektorowo-macierzowe w czasie rzeczywistym. Światło reprezentujące wektor wejściowy ulega podziałowi i przesunięciu fazowemu w strukturze interferometrów, a wynik mnożenia pojawia się na fotodetektorach z opóźnieniem równym czasowi przelotu fotonów przez chip, co wynosi zaledwie kilkadziesiąt pikosekund przy zużyciu energii zredukowanym o rzędy wielkości w porównaniu z cyfrowymi procesorami arytmetycznymi ALU.
Wreszcie, inżynieria systemów CPO musi uwzględniać zjawiska fizyki wysokich energii w falowodach submikronowych. Przy wprowadzaniu setek miliwatów mocy laserowej do falowodu krzemowego o przekroju ułamka mikrometra kwadratowego, lokalna gęstość mocy optycznej przekracza milion watów na centymetr kwadratowy. Przy takich intensywnościach ujawniają się nieliniowe zjawiska absorpcji dwufotonowej TPA (Two-Photon Absorption) oraz absorpcji na swobodnych nośnikach FCA (Free-Carrier Absorption). Opanowanie tych zjawisk poprzez integrację diod odprowadzających nośniki oraz stosowanie falowodów z azotku krzemu Si3N4 stanowi fundament gwarancji dwudziestoletniej niezawodności operacyjnej infrastruktury AI.
Na poziomie architektury obudowy wielochipletowej kluczową rolę odgrywa optymalizacja odprowadzania ciepła z wykorzystaniem mikrokanałowego chłodzenia cieczowego Microchannel Liquid Cooling oraz pionowych przelotek krzemowych TSV (Through-Silicon Vias). Umieszczenie silnika optycznego tuż obok procesora GPU o poborze mocy przekraczającym tysiąc watów stwarza ryzyko powstawania lokalnych punktów przegrzania Hotspots. Zastosowanie mikrotulei TSV umożliwia bezpośrednie zasilanie fotoniki z pominięciem gorących stref krzemu logicznego, a zintegrowane mikrokanalikowe bloki chłodzące ze zoptymalizowanym przepływem dielektrycznego chłodziwa utrzymują temperaturę złącz fotonicznych w stabilnym oknie operacyjnym od pięćdziesięciu do sześćdziesięciu stopni Celsjusza, co zapobiega dryfowi długości fali i degradacji emisyjnej.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.