
Krzemowa fotonika scalona i optyczne interkonekty chip-to-chip: Jak lasery DFB, modulatory Macha-Zehndera i współpakowana optyka CPO przełamują miedzianą barierę SerDes w klastrach AI
Fizyczna ściana miedzi: Kryzys transmisyjny w klastrach obliczeniowych
Współczesna rewolucja sztucznej inteligencji, napędzana przez wielkie modele transformatorowe o bilionach parametrów, zderzyła się z jedną z najbardziej bezwzględnych barier fundamentalnej fizyki ciała stałego. Przez dekady postęp w architekturze superkomputerów był mierzony przede wszystkim surową mocą obliczeniową rdzeni krzemowych, gęstością upakowania tranzystorów oraz taktowaniem procesorów. Jednak w dobie trenowania i inferencji modeli rozproszonych na dziesiątkach tysięcy akceleratorów graficznych, to nie szybkość wykonywania operacji arytmetycznych stała się głównym czynnikiem limitującym postęp, lecz zdolność do błyskawicznego przesyłania gigantycznych tensorycznych struktur danych pomiędzy poszczególnymi układami scalonymi. Każdy węzeł obliczeniowy musi w ułamkach milisekund wymieniać gradienty wag i stany aktywacji z sąsiednimi procesorami, tworząc potężny, bezustanny przepływ informacji przez magistrale komunikacyjne.
Dotychczasowy fundament tej transmisji, oparty na metalicznych ścieżkach miedzianych na płytach głównych oraz miedzianych kablach Direct Attach Copper, dotarł do kresu swoich fizycznych możliwości. Przy współczesnych prędkościach transmisji rzędu 112 gigabitów na sekundę na linię, a tym bardziej przy wchodzących standardach 224 oraz 448 gigabitów na sekundę, zachowanie elektronów w przewodniku miedzianym ulega dramatycznej degradacji. Zjawisko naskórkowości, polegające na wypychaniu prądu zmiennego o wysokiej częstotliwości ku cienkiej, zewnętrznej warstwie przewodnika, drastycznie zwiększa rezystancję efektywną ścieżki. Towarzyszące mu straty dielektryczne w laminacie płyty drukowanej oraz dyspersja sygnału powodują, że impuls elektryczny ulega potężnemu tłumieniu już po przebyciu kilkunastu centymetrów, zamieniając się w nieczytelny szum o zamkniętym diagramie oka sygnałowego.
Aby skompensować te straty, inżynierowie musieli wyposażyć układy nadawczo-odbiorcze SerDes w niezwykle złożone obwody korekcji charakterystyki częstotliwościowej, wzmacniacze CTLE oraz cyfrowe procesory sygnałowe DSP oparte na korekcji błędów FEC. Skutkiem ubocznym stała się jednak eksplozja zużycia energii elektrycznej. W najnowocześniejszych przełącznikach sieciowych i modułach akceleratorów same obwody SerDes i konwertery sygnałowe odpowiadają za ponad trzydzieści procent całkowitego poboru mocy urządzenia, generując gigantyczne ilości ciepła odpadowego. Fizyczny zasięg miedzianych kabli wysokiej prędkości skurczył się do zaledwie jednego metra, co uniemożliwia bezpośrednie łączenie szaf serwerowych w klastrach hiperskalowych bez stosowania drogich i prądożernych retransmiterów. Przełamanie tego impasu wymagało całkowitego porzucenia elektronu jako nośnika informacji na rzecz fotonu bezpośrednio na poziomie pakietu procesora.
Narodziny fotoniki krzemowej: Poskromienie światła w standardowych waflach CMOS
Koncepcja zastąpienia miedzi światłowodami nie jest nowa w telekomunikacji dalekosiężnej, gdzie włókna szklane od lat stanowią kręgosłup globalnego internetu. Prawdziwym wyzwaniem technologicznym było jednak przeniesienie komponentów optycznych z wielkich modułów telekomunikacyjnych bezpośrednio na powierzchnię miniaturowego układu scalonego. Tradycyjna optoelektronika opierała się na egzotycznych i kosztownych materiałach półprzewodnikowych z grup III-V układu okresowego, takich jak fosforek indu czy arsenek galu, które nie były kompatybilne z masowymi procesami litograficznymi CMOS wykorzystywanymi w fabrykach półprzewodników krzemowych. Narodziny krzemowej fotoniki scalonej stały się możliwe dzięki odkryciu, że standardowy krzem, będący materiałem przezroczystym dla fal światła podczerwonego o długościach 1310 i 1550 nanometrów, może służyć jako doskonały falowód optyczny.
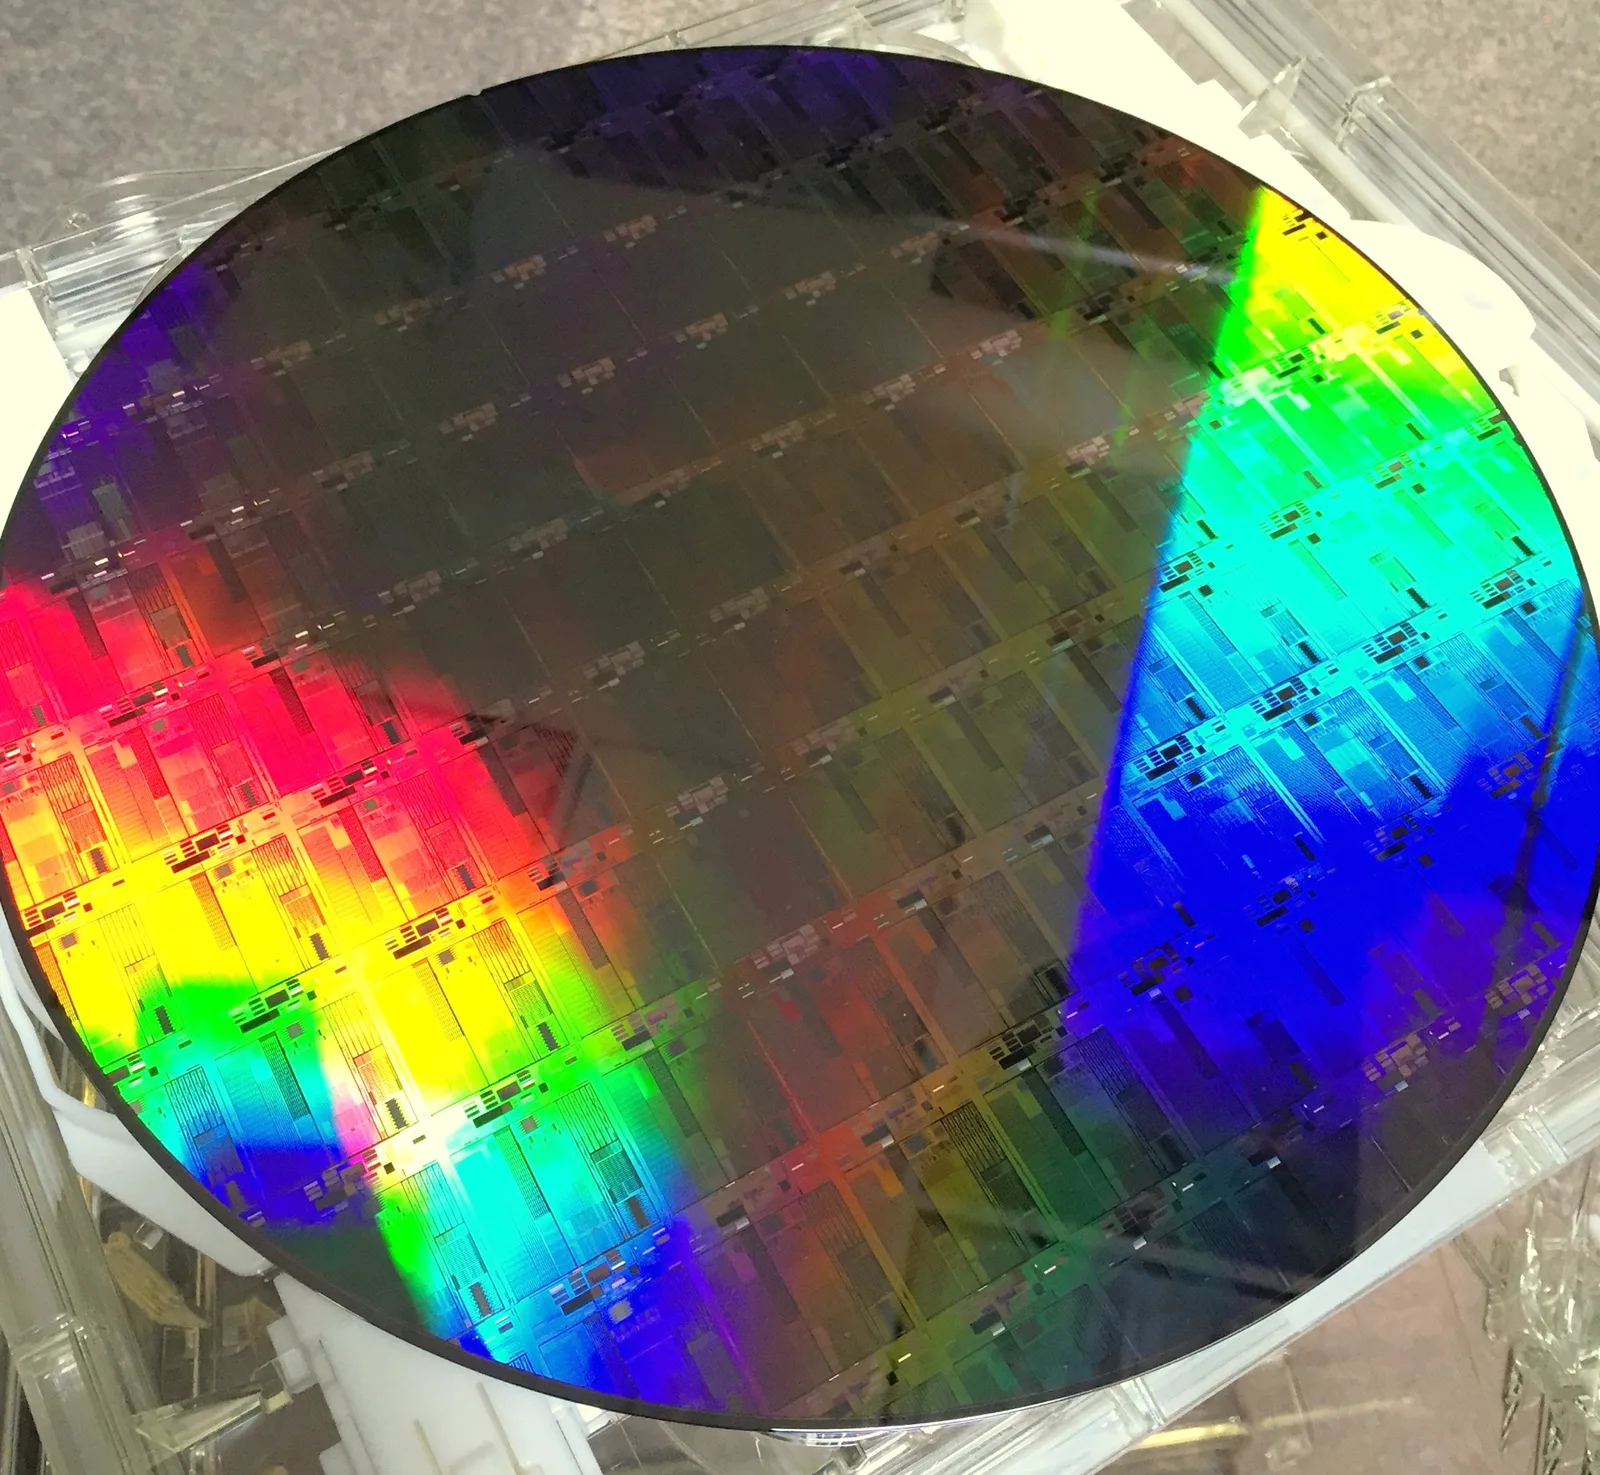
Ze względu na wysoki współczynnik załamania światła krzemu w porównaniu z otaczającym go dwutlenkiem krzemu, światło wprowadzone do krzemowego paska o szerokości zaledwie kilkuset nanometrów ulega zjawisku całkowitego wewnętrznego odbicia, pozostając ściśle uwięzione wewnątrz falowodu. Pozwala to na prowadzenie strumieni fotonów po skomplikowanych ścieżkach geometrycznych na powierzchni chipa z minimalnymi stratami optycznymi i bez ryzyka przesłuchów elektromagnetycznych, które paraliżują gęsto upakowane ścieżki miedziane. Co najważniejsze, falowody krzemowe, złącza siatkowe i sprzęgacze kierunkowe mogą być wytwarzane na tych samych zaawansowanych liniach produkcyjnych z waflami o średnicy 300 milimetrów, które służą do masowej produkcji pamięci i procesorów logicznych, zapewniając bezprecedensową skalowalność ekonomiczną.
Jednakże sam krzem posiada fundamentalną wadę optoelektroniczną wynikającą z jego skośnej przerwy energetycznej, co oznacza, że nie jest on w stanie w sposób wydajny emitować światła pod wpływem przepływu prądu elektrycznego. Aby stworzyć kompletny układ fotoniczny, konieczna stała się integracja heterogeniczna, polegająca na łączeniu mikroskopijnych warstw fosforku indu lub kropek kwantowych z podłożem krzemowym na poziomie wafla. Dzięki zaawansowanym technikom łączenia molekularnego die-to-wafer oraz mikrodruku transferowego, miniaturowe lasery ze sprzężeniem zwrotnym DFB mogą być integrowane bezpośrednio z krzemowymi falowodami, tworząc spójne, wielokanałowe źródła światła zasilające optyczne magistrale chipa.
Modulatory Macha-Zehndera i rezonatory mikropierścieniowe
Samo wygenerowanie stabilnej fali światła ciągłego przez laser DFB jest zaledwie pierwszym krokiem w procesie transmisji. Aby przesłać informacje, promień światła musi zostać poddany niezwykle szybkiej modulacji elektrooptycznej, kodującej bity danych w postaci zmian amplitudy, fazy lub częstotliwości fali nośnej. W krzemowej fotonice scalonej dominują dwa konkurencyjne, choć uzupełniające się podejścia konstrukcyjne: klasyczne interferometryczne modulatory Macha-Zehndera oraz wysoce zminiaturyzowane rezonatory mikropierścieniowe.
Modulator Macha-Zehndera działa w oparciu o podział wejściowej wiązki światła na dwa równoległe ramiona falowodowe. W jednym lub obu ramionach zintegrowane są złącza p-n, w których przyłożenie zewnętrznego napięcia elektrycznego wywołuje zjawisko dyspersji nośników plazmowych, zmieniając lokalny współczynnik załamania światła krzemu. W rezultacie fala świetlna w jednym ramieniu ulega opóźnieniu fazowemu. Kiedy oba ramiona łączą się ponownie na wyjściu interferometru, fale interferują ze sobą konstruktywnie lub destruktywnie w zależności od przesunięcia fazowego, przekształcając modulację fazową w mierzalną modulację natężenia światła. Modulatory tego typu charakteryzują się wyjątkową stabilnością termiczną oraz szerokim pasmem pracy, umożliwiając kodowanie sygnałów PAM4 z prędkościami przekraczającymi 200 gigabitów na sekundę na pojedynczą długość fali, aczkolwiek ich długość sięgająca kilku milimetrów ogranicza gęstość upakowania w krzemie.
Radykalną alternatywą są rezonatory mikropierścieniowe o średnicy zaledwie kilku mikrometrów, umieszczone w bezpośrednim sąsiedztwie prostego falowodu magistralnego. Kiedy długość fali światła odpowiada obwodowi pierścienia pomnożonemu przez współczynnik załamania, światło zostaje sprzężone z pierścieniem i ulega w nim uwięzieniu, powodując spadek transmisji na wyjściu falowodu. Niewielka zmiana gęstości nośników ładunku w pierścieniu przesuwa jego częstotliwość rezonansową, umożliwiając modulację światła przy ułamku energii wymaganej przez modulatory Macha-Zehndera i powierzchni setki razy mniejszej. Zastosowanie macierzy wielu mikropierścieni o stopniowo zmienianych średnicach pozwala na realizację gęstego zwielokrotnienia falowego DWDM, w którym pojedynczy falowód transportuje jednocześnie kilkadziesiąt niezależnych strumieni danych o różnych długościach fal, osiągając łączną przepustowość rzędu wielu terabitów na sekundę.
Współpakowana optyka CPO: Rewolucja w architekturze obudów półprzewodnikowych
Kluczowym momentem przełomowym dla wdrożenia fotoniki krzemowej w klastrach sztucznej inteligencji stało się odejście od wymiennych modułów optycznych montowanych na przednim panelu obudowy serwera na rzecz architektury współpakowanej optyki, znanej jako Co-Packaged Optics lub w skrócie CPO. W tradycyjnym podejściu sygnał elektryczny z procesora GPU musiał przebyć kilkadziesiąt centymetrów miedzianych ścieżek laminatu do gniazda transiwera, co generowało potężne straty i wymagało stosowania ciężkich układów Retimer DSP. Architektura CPO likwiduje ten dystans, umieszczając optyczne silniki transmisyjne na tym samym podłożu interposera krzemowego lub szklanego w bezpośrednim sąsiedztwie matrycy procesora logicznego.
Dzięki zaawansowanym technikom pakowania trójwymiarowego i dwuipółwymiarowego, takim jak technologia TSMC COUPE czy Intel EMIB, odległość między blokami obliczeniowymi a konwerterami elektrooptycznymi spada z kilkudziesięciu centymetrów do ułamka milimetra. Pozwala to na wyeliminowanie energochłonnych obwodów SerDes o dalekim zasięgu i zastąpienie ich ultralekką komunikacją równoległą o skrajnie niskim poborze mocy, spadającym poniżej jednego pikodżula na przesłany bit informacji. Zamiast miedzianych pinów i ścieżek, bezpośrednio z obudowy procesora wyprowadzane są elastyczne wstęgi wielordzeniowych światłowodów, które łączą się bez pośredników z matrycą przełączającą klastra.
Wdrożenie CPO stawia jednak przed inżynierami bezprecedensowe wyzwania w dziedzinie niezawodności termicznej i mechanicznej. Nowoczesne procesory AI generują w trakcie pracy pod pełnym obciążeniem ponad tysiąc watów mocy cieplnej, rozgrzewając strukturę krzemową do temperatur przekraczających osiemdziesiąt stopni Celsjusza. Z kolei lasery półprzewodnikowe są układami skrajnie wrażliwymi na temperaturę, tracąc wydajność kwantową i zmieniając długość fali emisji wraz z jej wzrostem. Z tego powodu w większości komercyjnych architektur CPO źródła laserowe są montowane w postaci zewnętrznych, wymiennych modułów zasilających ELS, podczas gdy na wspólnym podłożu z procesorem integrowane są wyłącznie pasywne falowody krzemowe oraz modulatory odporne na podwyższoną temperaturę roboczą.
Optyczne łącza chip-to-chip i demontaż pamięciowego wąskiego gardła CXL
Integracja fotoniki krzemowej na poziomie obudowy procesora otwiera drogę do realizacji optycznych interkonektów chip-to-chip o zerowym opóźnieniu dystansowym. W tradycyjnych architekturach komputerowych rozmiar pojedynczego węzła logicznego jest ograniczony fizycznymi wymiarami gniazda procesora i płyty serwerowej. Dzięki optycznym łączom chip-to-chip setki matryc obliczeniowych mogą być połączone w jedną spójną przestrzeń adresową, funkcjonując z perspektywy oprogramowania jako jeden gigantyczny, zunifikowany procesor o milionach rdzeni tensorowych. Bariera dzieląca komunikację wewnątrzchipową od międzysystemowej ulega całkowitemu rozmyciu, gdyż foton poruszający się w światłowodzie pokonuje odległość kilku metrów między szafami serwerowymi z prędkością równą ułamkowi nanosekundy bez jakiejkolwiek degradacji amplitudy sygnału.
Zjawisko to ma fundamentalne znaczenie dla optymalizacji pamięciowej klastrów sztucznej inteligencji. Współczesne modele językowe wymagają terabajtów pamięci operacyjnej o ekstremalnej przepustowości, co wymusza stosowanie drogich i trudnych w integracji stosów pamięci HBM. Optyczne magistrale bazujące na standardach takich jak CXL over Optics umożliwiają tworzenie bezoporowych pul pamięci współdzielonej, w których dowolny akcelerator w klastrze ma bezpośredni, natychmiastowy dostęp do odległych macierzy pamięci bez konieczności pośrednictwa jednostek CPU i bez narzutu buforowania pakietów sieciowych. Zjawisko to eliminuje zjawisko fragmentacji pamięci i pozwala na dynamiczną alokację zasobów sprzętowych w zależności od aktualnych potrzeb wykonywanego algorytmu.
Równolegle rozwijają się technologie optycznego routingu falowego, w których przekierowywanie pakietów danych wewnątrz klastra odbywa się bez ich konwersji do postaci elektrycznej. Zastosowanie optycznych przełączników mikromechanicznych MEMS lub termoooptycznych matryc falowodowych pozwala na rekonfigurację topologii sieci superkomputera w czasie rzeczywistym. W zależności od tego, czy model wykonuje fazę redukcji gradientów, czy też przesyła stany atencji w strukturach wieloagentowych, sieć może w ułamku sekundy przekształcić się z topologii torusa w pełną siatkę połączeń bezpośrednich typu all-to-all, maksymalizując efektywność wykorzystania krzemu.
Ekosystem przemysłowy: Wojna standardów i dominacja foundry
Przejście na fotonikę krzemową wywołało bezwzględną rywalizację technologiczną pomiędzy największymi graczami globalnego rynku półprzewodników. Na czoło tego wyścigu wysunął się tajwański gigant TSMC ze swoją platformą COUPE, która integruje obwody fotoniczne z zaawansowanymi technologiami pakowania CoWoS, oferując fabrykom bezfabrycznym kompletną ścieżkę wdrożeniową dla optycznych procesorów nowej generacji. Amerykański Intel, będący jednym z pionierów badań nad fotoniką krzemową, wykorzystuje swoje doświadczenie w technologii łączenia laserów InP do budowy zintegrowanych platform dla centrów danych, podczas gdy wyspecjalizowane start-upy, takie jak Ayar Labs czy Celestial AI, przyciągają miliardowe inwestycje od gigantów technologicznych, rozwijając autorskie interfejsy optyczne TeraPHY.
Równocześnie toczy się zacięta walka o standaryzację protokołów komunikacji optycznej. Organizacje branżowe, takie jak Optical Internetworking Forum oraz konsorcjum UCIe, pracują nad ujednoliceniem standardów interfejsów fizycznych i elektrycznych, aby zapewnić pełną interoperacyjność chipletów fotonicznych pochodzących od różnych producentów. Zdolność do połączenia na wspólnym interposerze procesora graficznego od jednego dostawcy z optycznym silnikiem komunikacyjnym od innego podmiotu jest kluczowa dla obniżenia barier wejścia na rynek i przyspieszenia komercjalizacji rozwiązań fotonicznych w sektorze komercyjnym.
Geopolityczny wymiar fotoniki krzemowej staje się równie istotny jak w przypadku klasycznej litografii. Zdolność do produkcji zaawansowanych układów optoelektronicznych wymaga unikalnego know-how w zakresie projektowania falowodów, precyzyjnego montażu światłowodów oraz zaawansowanych narzędzi symulacji elektromagnetycznej EDA. Państwa zachodnie, świadome strategicznego znaczenia tej technologii dla rozwoju sztucznej inteligencji i systemów militarnych, wprowadzają rygorystyczne kontrole eksportowe obejmujące oprogramowanie fotoniczne oraz specjalistyczny sprzęt testowy, dążąc do utrzymania przewagi nad rywalami w globalnym wyścigu technologicznym.
Horyzont postkrzemowy: Obliczenia optyczne i fotoniczne sieci neuronowe
Naturalnym przedłużeniem ewolucji od fotonicznych interkonektów komunikacyjnych do pełnej fotoniki zintegrowanej jest koncepcja wykonywania obliczeń bezpośrednio w domenie optycznej. W tradycyjnych procesorach cyfrowych operacje mnożenia macierzy, stanowiące fundament działania sieci neuronowych, wymagają przepływu miliardów elektronów przez bramki logiczne, co wiąże się z nieuniknionymi stratami cieplnymi i ograniczeniami częstotliwości. W fotonicznym procesorze tensorowym mnożenie macierzowe jest realizowane pasywnie z prędkością światła, gdy wiązki fotonów o różnych długościach fal przechodzą przez układ interferometrów Macha-Zehndera symulujących wagi synaptyczne.
Tego rodzaju optyczne procesory tensorowe charakteryzują się niemal zerowym zużyciem energii na operację matematyczną oraz latencją ograniczoną jedynie czasem przejścia fotonu przez strukturę krzemu, wynoszącą ułamki pikosekundy. Choć optyczne komputery neuronowe borykają się z wyzwaniami dotyczącymi precyzji obliczeniowej i nieliniowości optycznej, ich zastosowanie w wyspecjalizowanych akceleratorach inferencji może przynieść kolejny tysiąckrotny skok efektywności energetycznej. Krzemowa fotonika scalona przestaje być zatem jedynie ratunkiem dla przegrzewających się kabli miedzianych, stając się fundamentem nowej ery przetwarzania informacji, w której światło ostatecznie wypiera prąd elektryczny z serca cyfrowej cywilizacji.
Materiały elektrooptyczne nowej generacji: Cienkowarstwowy niobian litu LNOI i polimery elektrooptyczne
Chociaż krzem pozostaje podstawowym podłożem konstrukcyjnym dla zintegrowanych układów optycznych ze względu na dojrzałość technologiczną procesów CMOS, jego naturalne ograniczenia elektrooptyczne zmuszają badaczy do poszukiwania materiałów o wyższej efektywności modulatorkiej. W krzemie modulacja światła opiera się na zjawisku dyspersji nośników plazmowych, które wiąże się z niepożądanym tłumieniem optycznym oraz ograniczonym pasmem przenoszenia. Prawdziwą rewolucję w tym obszarze przynosi wdrożenie cienkowarstwowego niobianu litu na izolatorze, znanego jako LNOI. Materiał ten charakteryzuje się potężnym współczynnikiem Pockelsa, który pozwala na bezpośrednią, nieliniową zmianę współczynnika załamania pod wpływem pola elektrycznego bez wprowadzania wolnych nośników ładunku.
Modulatory wykonane w technologii cienkowarstwowego niobianu litu osiągają częstotliwości pracy przekraczające sto gigaherców przy napięciach sterujących poniżej jednego wolta. Umożliwia to bezpośrednie sterowanie modulatorem optycznym z wyjść cyfrowych procesora logicznego bez konieczności stosowania energochłonnych wzmacniaczy napięciowych. Równolegle rozwijają się badania nad hybrydowymi polimerami elektrooptycznymi o gigantycznych współczynnikach elektrooptycznych, które mogą być nanoszone na struktury krzemowe w prostych procesach powlekania wirowego. Połączenie krzemowych falowodów pasywnych z aktywnymi warstwami LNOI lub polimerów organicznych tworzy fundament dla interkonektów optycznych o gęstości transferu danych przekraczającej kilkadziesiąt terabitów na milimetr kwadratowy powierzchni chipa.
Ekonomia produkcji waflowej: Uzysk, testowanie na waflach i automatyzacja złączy światłowodowych
Przejście technologii CPO z fazy laboratoryjnej do masowego wdrożenia w hiperskalowych centrach danych zależy w decydującym stopniu od czynników ekonomicznych i dojrzałości procesów produkcyjnych. Jednym z najbardziej krytycznych wyzwań w produkcji optycznych układów scalonych jest procedura testowania jakości komponentów na poziomie wafla krzemowego. W tradycyjnym procesie produkcji półprzewodników testery automatyczne dotykają metalowych padów igłami pomiarowymi, weryfikując poprawność obwodów logicznych w ułamkach sekundy. W przypadku fotoniki sygnał testowy musi zostać wprowadzony do falowodu w postaci wiązki światła laserowego, co wymaga mechanicznego pozycjonowania sond optycznych z dokładnością do kilkudziesięciu nanometrów.
Równie skomplikowany jest etap montażu wielowłóknowych złączy światłowodowych do gotowego pakietu procesora. Błąd pozycjonowania światłowodu względem zintegrowanej siatki sprzęgającej rzędu jednego mikrometra prowadzi do dramatycznego wzrostu strat optycznych i dyskwalifikacji całego procesora wartego dziesiątki tysięcy dolarów. W odpowiedzi na to wyzwanie wiodące firmy montażowe wdrażają zrobotyzowane stacje pakowania oparte na systemach aktywnego sprzężenia zwrotnego i algorytmach widzenia maszynowego, które w czasie rzeczywistym optymalizują położenie złącza optycznego przed jego trwałym zgrzaniem laserowym. Automatyzacja tego procesu oraz standaryzacja optycznych gniazd wtykowych stanowią ostatni brakujący element układanki, otwierający drogę do powszechnego zastąpienia miedzi światłem w architekturach obliczeniowych nowej generacji.
Ostateczny bilans energetyczny: Od wąskiego gardła do zrównoważonej rewolucji AI
W ostatecznym rozrachunku bitwa o fotonikę krzemową toczy się nie tylko o surową przepustowość danych, lecz przede wszystkim o fizyczne przetrwanie centrów danych w warunkach narastającego kryzysu energetycznego. Szacuje się, że przy dalszym skalowaniu klastrów AI opartych wyłącznie na miedzi, zapotrzebowanie na energię elektryczną samych tylko układów transmisyjnych i systemów ich chłodzenia przekroczyłoby moc wytwórczą regionalnych sieci elektroenergetycznych. Zastąpienie miedzianych magistrali przez zintegrowane tory optyczne CPO pozwala na dziesięciokrotne obniżenie zużycia energii na każdy przesłany bit, redukując bilans cieplny serwerów do poziomów w pełni kontrolowalnych przez nowoczesne systemy chłodzenia cieczą.
Fotonika krzemowa stanowi zatem brakujące ogniwo technologiczne, które umożliwia bezkolizyjne przejście do kolejnego etapu skalowania modeli sztucznej inteligencji o architekturach wieloagentowych i kontekstach liczonych w dziesiątkach milionów tokenów. Gdy fotony zastępują elektrony na poziomie krzemowego jądra, ograniczenia przestrzenne i energetyczne superkomputerów ulegają zatarciu, otwierając drzwi do budowy rozproszonych machin obliczeniowych o skali obejmującej całe kontynenty. Cyfrowa cywilizacja zyskuje nowy, świetlny krwioobieg, bez którego dalszy rozwój zaawansowanych systemów kognitywnych byłby fizycznie niemożliwy.
To właśnie ten skok wydajności zadecyduje o tym, które gospodarki i korporacje utrzymają suwerenność technologiczną w dobie zautomatyzowanego odkrywania naukowego i powszechnej automatyzacji kognitywnej.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.