
Komputery neuromorficzne i analogowe przetwarzanie w pamięci: Jak memrystory tlenkowe, sieci impulsowe SNN i matryce ReRAM przełamują barierę von Neumanna i redukują pobór mocy wnioskowania sztucznej inteligencji o trzy rzędy wielkości
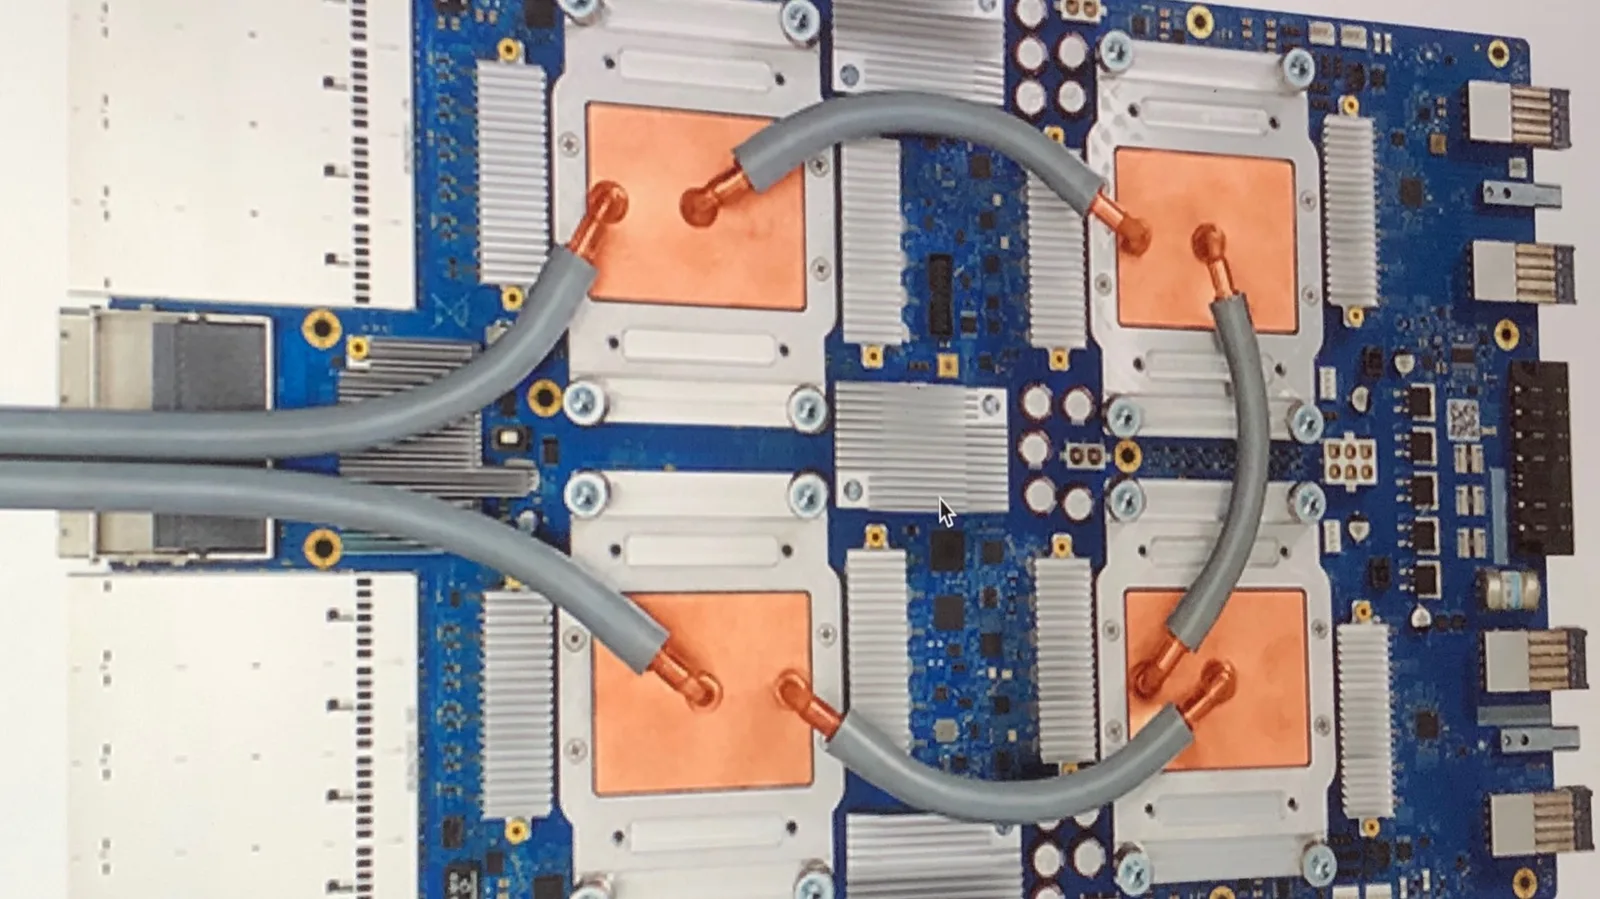
Ekspładujący rozwój generatywnej sztucznej inteligencji i wielkich modeli wielomodalnych w ostatnich latach postawił globalną architekturę obliczeniową przed najbardziej dramatycznym kryzysem energetycznym w historii informatyki. Najnowocześniejsze klastry obliczeniowe, zasilane dziesiątkami tysięcy procesorów graficznych i specjalizowanych akceleratorów tensorowych, zużywają dziś moc elektryczną porównywalną z zapotrzebowaniem całych aglomeracji miejskich lub małych państw europejskich. Chociaż postęp w litografii półprzewodnikowej pozwolił na upakowanie dziesiątek miliardów tranzystorów w pojedynczym krzemowym układzie scalonym, fundamentalna sprawność energetyczna tych systemów napotkała na barierę nieprzekraczalną w ramach tradycyjnych paradygmatów cyfrowych.
Przyczyną tego impasu jest architektura von Neumanna, która od niemal ośmiu dekad stanowi nienaruszalny kanon konstrukcji komputerów. W paradygmacie tym jednostka przetwarzająca dane, czyli procesor arytmetyczno-logiczny, jest fizycznie i przestrzennie odseparowana od jednostki przechowującej dane, czyli pamięci operacyjnej. W przypadku klasycznych obliczeń wsadowych narzut ten był akceptowalny, jednak w głębokich sieciach neuronowych każde pojedyncze przejście w przód wymaga przemnożenia wektora wejściowego przez gigantyczne macierze wag synaptycznych, liczące setki miliardów parametrów. W rezultacie nowoczesny akcelerator AI spędza ponad osiemdziesiąt procent swojego czasu i zużywa ponad osiemdziesiąt procent całkowitej energii elektrycznej nie na wykonywaniu operacji matematycznych, lecz na nieustannym przepychaniu miliardów bitów przez magistrale transmisyjne łączące pamięć HBM z rdzeniami obliczeniowymi.
Zjawisko to, powszechnie określane w literaturze inżynieryjnej jako ściana pamięci memory wall oraz wąskie gardło von Neumanna von Neumann bottleneck, sprawia, że tradycyjne skalowanie mocy obliczeniowej staje się ekonomicznie i środowiskowo autodestrukcyjne. Podczas gdy nowoczesny superkomputer potrzebuje megawatów mocy do symulacji prostych procesów kognitywnych, biologiczny mózg ludzki wykonuje niewiarygodnie złożone operacje percepcji, wnioskowania dedukcyjnego i sterowania motorycznego w czasie rzeczywistym, zadowalając się budżetem energetycznym rzędu zaledwie dwudziestu watów. Ta zdumiewająca dysproporcja, sięgająca wielu rzędów wielkości, wynika z fundamentalnego faktu: w strukturach biologicznych pamięć i przetwarzanie informacji są zlokalizowane dokładnie w tym samym miejscu fizycznym, w strukturze synaps i neuronów.
Odpowiedzią na kryzys architektury von Neumanna jest narodziny nowej dyscypliny mikroelektroniki: informatyki neuromorficznej oraz analogowego przetwarzania bezpośrednio w pamięci, określanego w terminologii anglosaskiej jako Analog In-Memory Computing AIMC. Odrzucając zero-jedynkową sztywność algebry Boole'a i cyfrowe bramki logiczne, inżynierowie sięgają po fundamentalne prawa fizyki materii skondensowanej, prawa Kirchhoffa i Ohma oraz nowatorskie materiały o zmiennej rezystancji, ze szczególnym uwzględnieniem memrystorów tlenkowych ReRAM, pamięci zmiennofazowych PCM oraz magnetycznych złączy tunelowych MRAM. W ten sposób powstają procesory, które nie symulują sieci neuronowych w kodzie binarnym, lecz same w swojej strukturze fizycznej stają się siecią synaptyczną, redukując pobór mocy operacji inferencyjnych nawet tysiąckrotnie.
Architektura Crossbar i fizyka przetwarzania w pamięci: Prawa Kirchhoffa i Ohma
Kluczowym elementem konstrukcyjnym analogowych procesorów in-memory computing jest matryca krzyżowa, powszechnie znana jako architektura Crossbar. Matryca ta składa się z siatki prostopadłych przewodzących linii poziomych, zwanych liniami słów word lines, oraz linii pionowych, zwanych liniami bitów bit lines. W każdym punkcie przecięcia tych przewodów umieszczony jest miniaturowy element pamięciowy o regulowanym przewodnictwie elektrycznym, pełniący rolę sztucznej synapsy. Wartość wagi synaptycznej sieci neuronowej nie jest zapisywana w postaci ciągu zer i jedynek w odległej komórce pamięci SRAM czy DRAM, lecz odpowiada bezpośrednio poziomowi przewodności elektrycznej konduktancji G danego elementu w matrycy.
Gdy układ wykonuje fundamentalną dla sztucznej inteligencji operację mnożenia macierzy przez wektor VMM Vector-Matrix Multiplication, do linii poziomych matrycy przykładany jest zestaw napięć wejściowych V, których amplitudy odpowiadają wartościom wektora aktywacji wejściowej. Zgodnie z elementarnym prawem Ohma, prąd I przepływający przez pojedynczy element synaptyczny w punkcie przecięcia jest iloczynem przyłożonego napięcia oraz przewodności tego punktu, I równa się V pomnożone przez G. W ten sposób operacja mnożenia skalarnego zostaje wykonana w sposób natychmiastowy i bezstratny za pośrednictwem samej fizyki przepływu nośników ładunku przez materiał złącza.
Następnie, wzdłuż każdej pionowej linii bitu, prądy cząstkowe pochodzące ze wszystkich synaps w danej kolumnie ulegają zsumowaniu zgodnie z pierwszym prawem Kirchhoffa, mówiącym o bilansie prądów w węźle obwodu elektrycznego. Całkowity prąd wypływający z końca linii pionowej stanowi dokładną sumę iloczynów napięć wejściowych i przewodności synaptycznych w całej kolumnie. Oznacza to, że cała monumentalna operacja mnożenia macierzy o wymiarach tysiąc na tysiąc przez wektor zostaje wykonana w jednym, jedynym cyklu fizycznym, w czasie rzędu nanosekund, bez konieczności odczytywania wag z pamięci, bez przesyłania danych magistralami cyfrowymi i bez wykonywania milionów kroków w cyfrowych jednostkach arytmetycznych ALU.
Wydajność energetyczna tego procesu jest oszałamiająca. Podczas gdy cyfrowy procesor graficzny zużywa od kilkunastu do kilkudziesięciu pikodżuli energii na wykonanie pojedynczej operacji mnożenia ze skumulowaniem MAC w precyzji zmiennoprzecinkowej, analogowa matryca krzyżowa wykonuje tę samą operację ze zużyciem energii rzędu kilkudziesięciu femtodżuli lub mniej. Przekłada się to na wskaźniki efektywności przekraczające sto bilionów operacji na sekundę w przeliczeniu na jeden wat mocy TOPS na wat, co stanowi wartość o dwa do trzech rzędów wielkości wyższą niż osiągi najbardziej zaawansowanych układów cyfrowych wytwarzanych w litografii poniżej trzech nanometrów.
Fundamentalnym wyzwaniem konstrukcyjnym wielkoskalowych matryc Crossbar jest zjawisko prądów pasożytniczych sneak path currents. W czystej architekturze krzyżowej, w której komórki pamięciowe są połączone bezpośrednio pomiędzy liniami przewodzącymi, prąd elektryczny płynący przez wybraną komórkę może bocznikować przez sąsiednie, niezamierzone punkty matrycy o niskiej rezystancji. Prowadzi to do drastycznego zafałszowania wyników sumowania prądów w kolumnach, znacznego wzrostu niepożądanego poboru mocy oraz ograniczenia maksymalnego rozmiaru fizycznego matrycy do kilkudziesięciu węzłów. Rozwiązaniem, które umożliwiło skalowanie procesorów AIMC do milionów synaps, stało się wdrożenie architektury 1S1R One Selector One Resistor. W układzie tym w każdym węźle szeregowo z memrystorem integrowany jest miniaturowy element selektorowy, najczęściej w postaci przełącznika progowego z amorficznych chalkogenków Ovonic Threshold Switch OTS lub lotnego memrystora tlenkowego. Selektor wykazuje skrajnie nieliniową charakterystykę prądowo-napięciową; pozostaje niemal idealnym izolatorem dla małych napięć pasożytniczych, przechodząc w stan wysokiego przewodnictwa dopiero po przyłożeniu pełnego napięcia roboczego, co skutecznie blokuje prądy pasożytnicze i pozwala na budowę gęstych matryc o rozmiarach tysiąc na tysiąc synaps.
Memrystory tlenkowe ReRAM i pamięci zmiennofazowe PCM: Fizyka pamięci nielotnej
Praktyczna realizacja matryc Crossbar wymagała stworzenia elementów elektronicznych zdolnych do precyzyjnego, powtarzalnego i trwałego utrzymywania analogowych stanów przewodności. Tradycyjne tranzystory polowe z pływającą bramką Flash, choć dojrzałe technologicznie, cierpią na wysokie napięcia programowania, niską wytrzymałość cykliczną i duże rozmiary komórek. Przełomem w inżynierii materiałowej stało się wdrożenie rezystywnych pamięci o dostępie swobodnym ReRAM, powszechnie utożsamianych z koncepcją memrystora, postulowaną teoretycznie przez Leona Chuę w 1971 roku, oraz pamięci zmiennofazowych PCM Phase-Change Memory.
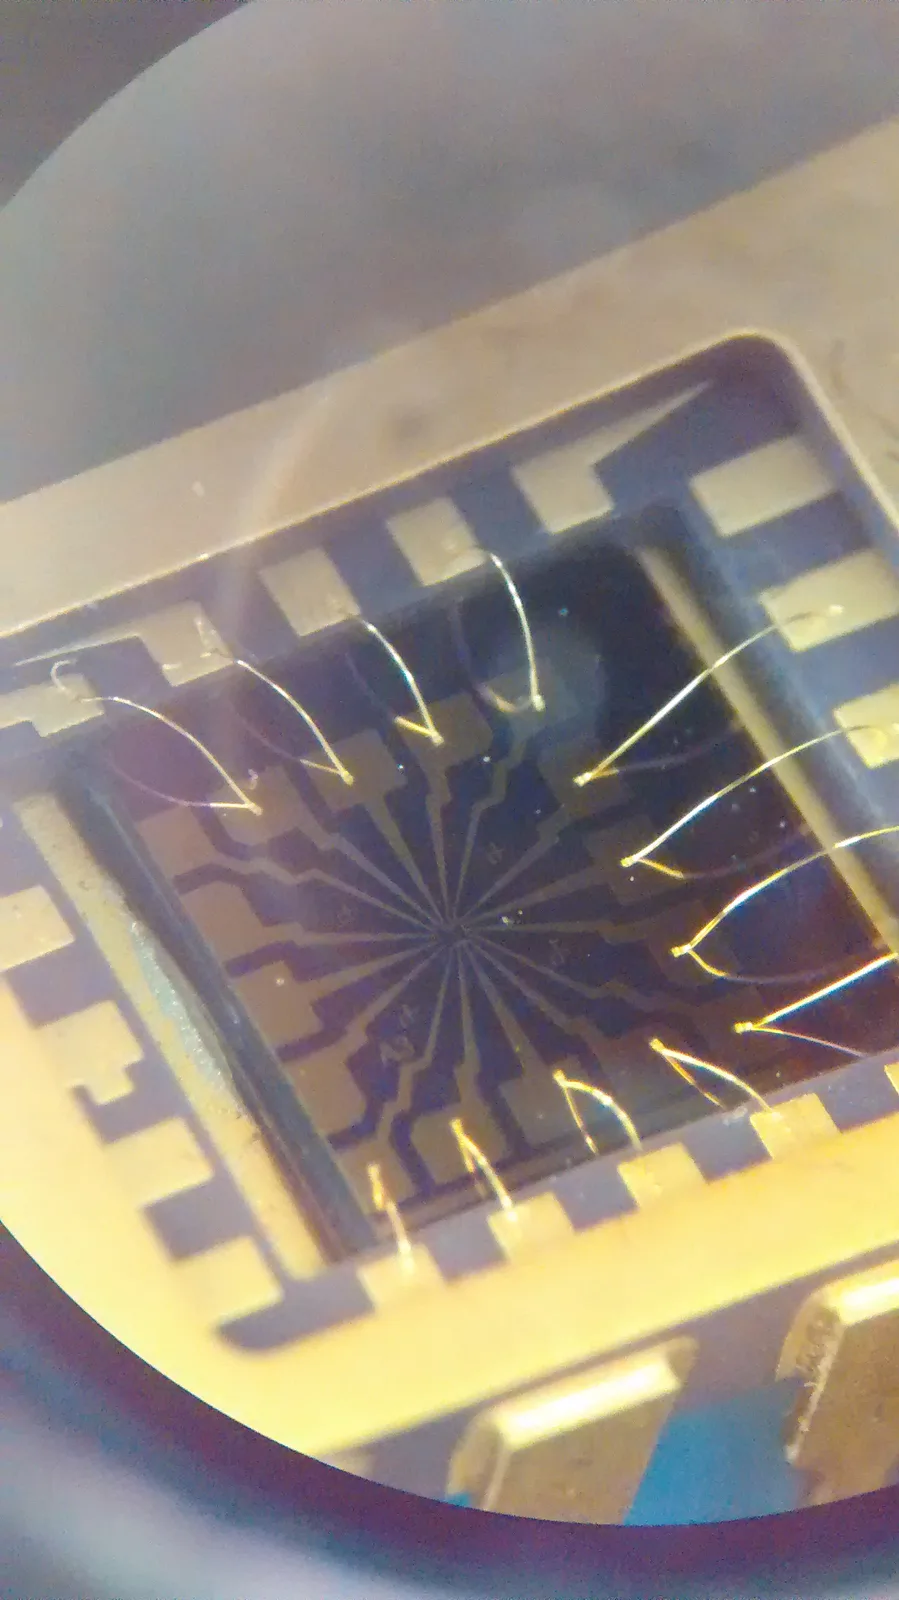
Struktura memrystora tlenkowego ReRAM składa się z mikroskopijnej warstwy tlenku metalu przejściowego, takiego jak tlenek hafnu HfO2, tlenek tantalu Ta2O5 czy tlenek tytanu TiO2, umieszczonej pomiędzy dwiema elektrodami metalicznymi. Mechanizm przełączania rezystancyjnego opiera się na kontrolowanej migracji jonów tlenowych i powstawaniu w matrycy tlenkowej przewodzących włókienek filamentów zbudowanych z wakansów tlenowych. Przyłożenie odpowiednio dobranego impulsu napięciowego powoduje przemieszczenie wakansów i wzrost lub zwężenie średnicy włókna przewodzącego, co pozwala na płynną modulację konduktancji elementu pomiędzy stanem o wysokiej rezystancji HRS a stanem o niskiej rezystancji LRS. Zjawisko to charakteryzuje się pełną nielotnością; po odłączeniu zasilania konfiguracja atomowa wakansów pozostaje zamrożona przez dziesięciolecia.
Z kolei w pamięciach zmiennofazowych PCM materiałem aktywnym jest stop chalkogenkowy, najczęściej Ge2Sb2Te5 GST. Materiał ten wykazuje zdolność do odwracalnego przechodzenia pomiędzy nieuporządkowaną fazą bezpostaciową amorficzną, charakteryzującą się wysoką opornością elektryczną i niskim współczynnikiem odbicia optycznego, a wysoce uporządkowaną fazą krystaliczną o niskiej rezystancji. Przejście fazowe wywoływane jest za pomocą krótkich impulsów prądowych generujących ciepło Joule'a. Szybki impuls o dużej amplitudzie topi materiał, który po błyskawicznym schłodzeniu zamraża się w stanie amorficznym, podczas gdy dłuższy impuls o umiarkowanej temperaturze umożliwia reorganizację krystalograficzną do fazy krystalicznej.
Zarówno memrystory ReRAM, jak i komórki PCM charakteryzują się mikroskopijną powierzchnią jednostkową, nieprzekraczającą 4F2, co pozwala na pionowe integrowanie wielowarstwowych matryc trójwymiarowych 3D Crossbar bezpośrednio nad krzemowymi warstwami logicznymi CMOS w technologii Back-End-of-Line BEOL. Co więcej, elementy te wykazują właściwości plastyczności synaptycznej, takie jak zależna od czasu impulsowania plastyczność synaps STDP Spike-Timing-Dependent Plasticity, co umożliwia realizację biologicznych reguł uczenia bezpośrednio na poziomie fizycznego sprzętu, bez konieczności stosowania zewnętrznych algorytmów optymalizacji gradientowej.
Równolegle do memrystorów filamentowych i komórek PCM dynamiczny rozwój przeżywają tranzystory polowe z bramką ferroelektryczną FeFET Ferroelectric Field-Effect Transistors oraz magnetyczne złącza tunelowe MRAM. W tranzystorach FeFET warstwa dielektryka bramkowego wykonana jest z domieszkowanego tlenku hafnu wykazującego właściwości ferroelektryczne. Orientacja domen dipolowych w krysztale ferroelektryka może być odwracana za pomocą zewnętrznego pola elektrycznego, co pozwala na bezstopniową modulację napięcia progowego tranzystora i płynne sterowanie prądem kanału bez przepływu prądu upływu przez bramkę. Z kolei spintroniczne złącza MRAM, wykorzystujące zjawisko gigantycznego magnetooporu tunelowego TMR pomiędzy dwiema warstwami ferromagnetycznymi rozdzielonymi barierą z tlenku magnezu MgO, oferują niemal nieskończoną wytrzymałość cykliczną przekraczającą bilion przełączeń oraz odporność na promieniowanie jonizujące, co czyni je idealnym kandydatem do analogowych procesorów kosmicznych i wojskowych.
Wąskie gardło konwersji sygnałów: Wyzwania przetworników ADC i szum analogowy
Pomimo niezrównanej elegancji obliczeń analogowych, przejście od laboratoryjnych demonstratorów do komercyjnych procesorów in-memory computing napotyka na potężne bariery inżynieryjne, z których najważniejszą jest problem konwersji sygnałów na granicy świata analogowego i cyfrowego. Podczas gdy samo mnożenie macierzowe odbywa się w domenie prądowo-napięciowej, otaczający ekosystem systemowy – magistrale PCIe, pamięci podręczne i protokoły komunikacyjne – pozostaje w stu procentach cyfrowy. Oznacza to, że każdy analogowy wektor prądów wyjściowych z matrycy Crossbar musi zostać przekształcony z powrotem w ciąg bitów za pomocą przetworników analogowo-cyfrowych ADC.
Przetworniki ADC stanowią piętę achillesową układów AIMC. Ich wykonanie w zaawansowanych węzłach litograficznych wymaga znacznej powierzchni krzemu oraz generuje olbrzymi pobór mocy, który gwałtownie rośnie wraz ze wzrostem rozdzielczości bitowej i częstotliwości próbkowania. W praktycznych implementacjach przetworniki ADC i DAC potrafią pochłaniać ponad sześćdziesiąt procent całkowitej energii zużywanej przez procesor in-memory, niwelując znaczną część zysków wynikających z analogowego mnożenia macierzy. Z tego względu inżynierowie dążą do stosowania przetworników o niskiej rozdzielczości, rzędu od czterech do ośmiu bitów, wykorzystując architekturę sukcesywnej aproksymacji SAR ADC, co z kolei wymaga adaptacji algorytmów sztucznej inteligencji do pracy w warunkach drastycznej kwantyzacji sygnału.
Drugim fundamentalnym wyzwaniem jest szum analogowy oraz zmienność procesowa elementów rezystywnych. W przeciwieństwie do logiki cyfrowej, która posiada absolutną odporność na drobne fluktuacje napięć dzięki szerokim marginesom stanów logicznych zero i jeden, obliczenia analogowe są bezpośrednio podatne na fluktuacje termiczne, szum telegraficzny RTS Random Telegraph Signal oraz dryf rezystancji w czasie związany z relaksacją naprężeń sieci krystalicznej. Co więcej, w procesie fabrykacji w komorze próżniowej dwa sąsiednie memrystory na tym samym waflu krzemowym mogą wykazywać nawet kilkunastoprocentowe różnice w charakterystyce przewodnictwa z powodu wahań grubości warstwy tlenkowej o pojedyncze warstwy atomowe.
Aby przezwyciężyć te niedoskonałości fizyczne, badacze rozwinęli techniki treningu odpornego na szum Hardware-Aware Training. W podejściu tym sieć neuronowa podczas uczenia na klastrach GPU jest celowo poddawana działaniu szumu stochastycznego odpowiadającego profilowi fluktuacji konkretnego chipu ReRAM. Model uczy się rozmieszczać wagi w takich rejonach krajobrazu funkcji straty, które są maksymalnie odporne na drobne odchylenia wartości przewodności. Dodatkowo wdraża się techniki kalibracji w locie i odświeżania stanów konduktancji, co pozwala na zachowanie wysokiej dokładności wnioskowania nawet w wieloletniej eksploatacji układu w zmiennych warunkach temperaturowych.
Impulsowe sieci neuronowe SNN: Przetwarzanie asynchroniczne i kamery zdarzeniowe
Radykalnym krokiem naprzód w dziedzinie bioinspirowanego przetwarzania informacji jest przejście od tradycyjnych, gęstych sieci neuronowych do impulsowych sieci neuronowych, określanych w literaturze skrótem SNN od angielskiego Spiking Neural Networks. Uznawane za trzecią generację modeli sztucznej inteligencji, sieci SNN odrzucają koncepcję ciągłych aktywacji przekazywanych synchronicznie w takt zegara procesora, naśladując rzeczywisty sposób komunikacji neuronów w korze mózgowej za pomocą dyskretnych potencjałów czynnościowych, czyli impulsów spike w czasie.
W procesorze neuromorficznym zoptymalizowanym pod kątem SNN, takim jak Intel Loihi, IBM TrueNorth czy europejski BrainScaleS, neurony krzemowe operują w architekturze asynchronicznej sterowanej zdarzeniami Event-Driven Computing. Jeśli do danego neuronu nie docierają impulsy z neuronów poprzedzających, układ pozostaje w stanie całkowitego uśpienia, nie pobierając energii dynamicznej i generując zerowy prąd upływu. Dopiero gdy suma ładunków zintegrowanych na kondensatorze błonowym przekroczy wyznaczony potencjał progowy, neuron generuje pojedynczy, ultrakrótki impuls cyfrowy i natychmiast resetuje swój stan. Informacja w sieci SNN nie jest kodowana w amplitudzie napięcia, lecz w precyzyjnych zależnościach czasowych pomiędzy impulsami, na przykład w opóźnieniu pierwszego impulsu Time-to-First-Spike lub częstotliwości impulsowania Rate Coding.
Całkowite wyeliminowanie globalnego sygnału zegarowego oraz operowanie na rzadkich, asynchronicznych zdarzeniach pozwala na redukcję poboru mocy do niewiarygodnie niskich poziomów, rzędu mikrowatów lub miliwatów podczas ciągłego przetwarzania strumieni danych sensorycznych. Właściwości te idealnie komponują się z nową klasą sensorów optoelektronicznych, jakimi są neuromorficzne kamery zdarzeniowe Event-Based Cameras lub sensory dynamicznej wizji DVS Dynamic Vision Sensors. W przeciwieństwie do tradycyjnych kamer, które rejestrują statyczne klatki obrazu z ustaloną częstotliwością generując gigabajty nadmiarowych danych, piksele kamery DVS reagują wyłącznie na lokalne zmiany natężenia światła w czasie rzeczywistym.
Połączenie kamery zdarzeniowej z procesorem neuromorficznym tworzy układ sensoryczno-obliczeniowy o mikrosekundowym czasie reakcji, gigantycznym zakresie dynamiki optycznej przekraczającym sto dwadzieścia decybeli oraz zerowym rozmyciu ruchu. Systemy takie znajdują natychmiastowe zastosowanie w systemach unikania kolizji dla mikrodronów, optoelektronicznych głowicach naprowadzających pocisków przechwytujących oraz w autonomicznych pojazdach, gdzie zdolność do błyskawicznego wykrycia nagłej przeszkody w nocy lub pod słońce decyduje o bezpieczeństwie ludzi, zużywając przy tym zaledwie ułamek energii wymaganej przez tradycyjne lidary i procesory wizyjne.
Przez długi czas główną barierą w rozwoju sieci SNN był brak efektywnych metod ich trenowania, wynikający z nieciągłego, schodkowego charakteru funkcji generowania impulsu czynnościowego, która w sensie matematycznym posiada zerową pochodną niemal wszędzie i nieskończoną w punkcie progu. Wykluczało to bezpośrednie stosowanie klasycznego algorytmu wstecznej propagacji błędu. Przełomem stało się opracowanie metody gradientów zastępczych Surrogate Gradients połączonej z propagacją wsteczną w czasie BPTT Backpropagation Through Time. W podejściu tym podczas przejścia w przód model zachowuje dyskretną, biologiczną naturę impulsów, natomiast w fazie propagacji wstecznej nieciągła pochodna zostaje zastąpiona gładką funkcją sigmoidalną lub trójkątną. Umożliwia to trenowanie głębokich sieci impulsowych na standardowych klastrach akceleratorów GPU za pomocą dojrzałych frameworków, takich jak PyTorch czy JAX, a następnie bezstratny transfer wyuczonych wag synaptycznych do docelowych procesorów neuromorficznych pracujących w trybie ciągłej inferencji asynchronicznej.
Zmierzch monopolu GPU: Wszechobecna inteligencja brzegowa i nowe ramy obliczeń
Nieuchronna rewolucja neuromorficzna i rozwój analogowych układów in-memory computing nie oznaczają natychmiastowego zniknięcia procesorów graficznych z centrów danych, lecz zwiastują fundamentalną rekonfigurację całego ekosystemu przetwarzania sztucznej inteligencji. Przez ostatnią dekadę giganci technologiczni przyzwyczaili rynek do modelu w pełni scentralizowanego, w którym wszelkie zaawansowane operacje kognitywne wymagały przesyłania danych użytkownika do gigantycznych farm serwerowych w chmurze obliczeniowej. Model ten napotyka jednak na nieprzekraczalne bariery w postaci opóźnień transmisji telekomunikacyjnej, ograniczeń przepustowości sieci oraz rosnących wymagań dotyczących prywatności danych osobowych i suwerenności przemysłowej.
Informatyka neuromorficzna umożliwia przeniesienie zaawansowanej inferencji ze scentralizowanych klastrów bezpośrednio na skraj sieci Edge AI. Miniaturowy chip memrystorowy o poborze mocy kilkudziesięciu miliwatów, wbudowany w aparat słuchowy, implant medyczny, ramę satelity obserwacyjnego czy sensor przemysłowy w fabryce, może w sposób ciągły analizować złożone sygnały biologiczne, wykrywać anomalie wibracyjne turbin czy przetwarzać mowę naturalną bez konieczności nawiązywania jakiejkolwiek łączności ze światem zewnętrznym. Oznacza to powstanie prawdziwie wszechobecnej, autonomicznej inteligencji osadzonej w środowisku fizycznym.
Co więcej, architektury neuromorficzne otwierają drogę do systemów uczących się w sposób ciągły w trakcie eksploatacji Continual Learning bez zjawiska katastrofalnego zapominania Catastrophic Forgetting, które paraliżuje tradycyjne sieci głębokie. Zdolność do lokalnej modyfikacji wag w matrycach ReRAM pod wpływem pojedynczych sygnałów błędów pozwala urządzeniom autonomicznym na natychmiastową adaptację do zmieniających się warunków otoczenia, stylu pracy użytkownika czy uszkodzeń mechanicznych platformy, na wzór biologicznych układów nerwowych adaptujących się do nowych nisz ekologicznych.
Przełamanie bariery von Neumanna poprzez fizyczną fuzję pamięci i logiki w analogowych strukturach memrystywnych stanowi najważniejszy zwrot paradygmatyczny w architekturze komputerów od czasów powstania pierwszych układów scalonych. Wychodząc poza sztywne ramy binarnego świata zero-jedynkowego i zaprzęgając subtelne prawa fizyki materii do realizacji operacji kognitywnych, ludzkość wkracza w erę komputerów, które po raz pierwszy w historii zaczynają dorównywać arcydziełu natury – biologicznemu mózgowi – pod względem elegancji, gęstości upakowania i bezprecedensowej efektywności energetycznej.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.