
Heterogeniczna integracja trójwymiarowa 3D-IC i hybrydowe wiązanie miedź-miedź Cu-Cu: Jak zaawansowany packaging CoWoS, Foveros Direct i mostki krzemowe przełamują limity fizyczne monolitycznych matryc
Ściana siatki krystalicznej i koniec monolitycznego krzemu
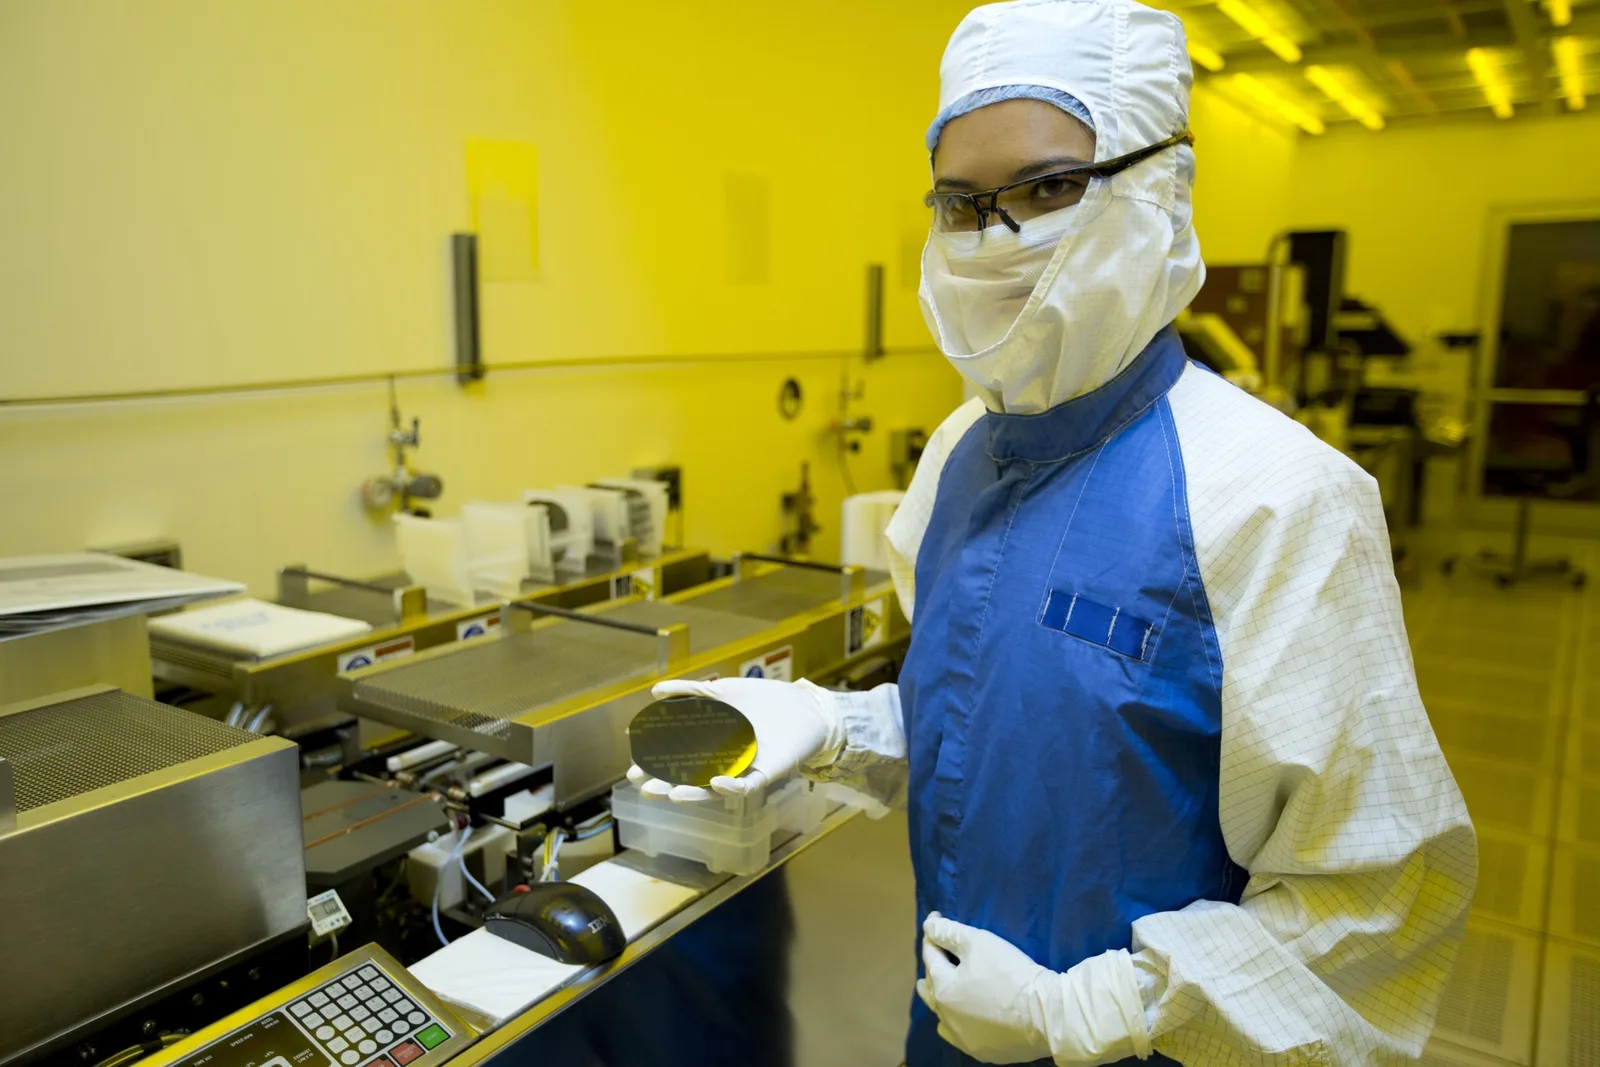
Przez ponad pół wieku postęp w branży półprzewodnikowej opierał się na bezkompromisowej realizacji prawa Moore'a poprzez geometryczne zmniejszanie wymiarów krytycznych tranzystorów planarnych MOSFET, a następnie tranzystorów FinFET. Zmniejszenie długości bramki logicznej pozwalało na podwajanie liczby elementów na jednostkę powierzchni wafla krzemowego co około osiemnaście do dwudziestu czterech miesięcy przy jednoczesnym wzroście częstotliwości taktowania i redukcji kosztu pojedynczego tranzystora. Jednak w miarę zbliżania się węzłów technologicznych do skali sub-dwóch nanometrów, inżynierowie zderzyli się z nieprzekraczalnymi barierami fizyki kwantowej, takimi jak zjawisko tunelowania ładunku przez izolator bramkowy, dyskretna fluktuacja domieszek oraz dramatyczny wzrost kosztów litografii EUV o wysokiej aperturze numerycznej High-NA EUV.
Równocześnie przemysł półprzewodnikowy uderzył w fizyczny limit pola naświetlania litograficznego, określany jako Reticle Limit. Standardowe skanery fotolitograficzne są w stanie naświetlić w pojedynczym kroku ekspozycji maskę o maksymalnej powierzchni około ośmiuset pięćdziesięciu ośmiu milimetrów kwadratowych. W erze potężnych akceleratorów sztucznej inteligencji, wymagających setek miliardów tranzystorów, monolityczna matryca krzemowa osiągnęła już maksymalny możliwy rozmiar fizyczny.
Dalsze powiększanie monolitycznego chipu jest nie tylko niemożliwe z punktu widzenia optyki skanerów, lecz także ekonomicznie katastrofalne ze względu na wskaźnik uzysku Die Yield. Wraz ze wzrostem powierzchni matrycy prawdopodobieństwo wystąpienia losowego defektu sieci krystalicznej rośnie wykładniczo. Przy powierzchni zbliżającej się do limitu reticle, koszt pojedynczego sprawnego chipu staje się zaporowy, a większość wyprodukowanych struktur krzemowych trafia do odpadów.
Odpowiedzią na ten impas stała się dekompozycja architektury procesora na mniejsze, wyspecjalizowane moduły krzemowe zwane chipletami oraz ich zaawansowane łączenie w trójwymiarowych strukturach 3D-IC. Zamiast produkować cały procesor, pamięć podręczną, kontrolery pamięci i interfejsy I/O w jednym, najdroższym węźle litograficznym, inżynierowie wytwarzają rdzenie obliczeniowe w najnowszym procesie 2nm lub 3nm, a bloki wejścia-wyjścia i zasilania w tańszych, dojrzałych węzłach, łącząc je następnie w jednolitą funkcjonalnie całość za pomocą mikroskopijnych połączeń miedzianych.
Ewolucja interkonektów: Od mikro-kulek do bezlutowego wiązania hybrydowego
Kluczem do powodzenia architektury chipletowej jest gęstość i jakość połączeń elektrycznych między poszczególnymi strukturami krzemowymi. W tradycyjnym montażu obudów półprzewodnikowych chipy łączono z podłożem za pomocą złotych drutów Wire Bonding, co zapewniało odstęp między połączeniami rzędu kilkudziesięciu mikrometrów, wprowadzając potężne indukcyjności pasożytnicze i ograniczając pasmo transmisji. Kolejnym krokiem była technologia Flip-Chip z wykorzystaniem mikro-kulek lutowniczych Micro-Bumps ze stopu cyny i srebra.
Mimo ogromnego sukcesu mikro-kulek, technologia ta osiągnęła swoją fizyczną granicę przy skoku połączeń Pitch rzędu dwudziestu do dwudziestu pięciu mikrometrów. Przy dalszej miniaturyzacji dochodzi do zjawiska mostkowania stopionego lutu w trakcie procesu rozpływu Reflow, co prowadzi do katastrofalnych zwarć elektrycznych między sąsiednimi pinami sygnałowymi. Ponadto mikro-kulki wprowadzają opór elektryczny i pojemność pasożytniczą, które przy gigabitowych transferach generują potężne straty energetyczne rzędu kilku pikodżuli na przesłany bit informacji.
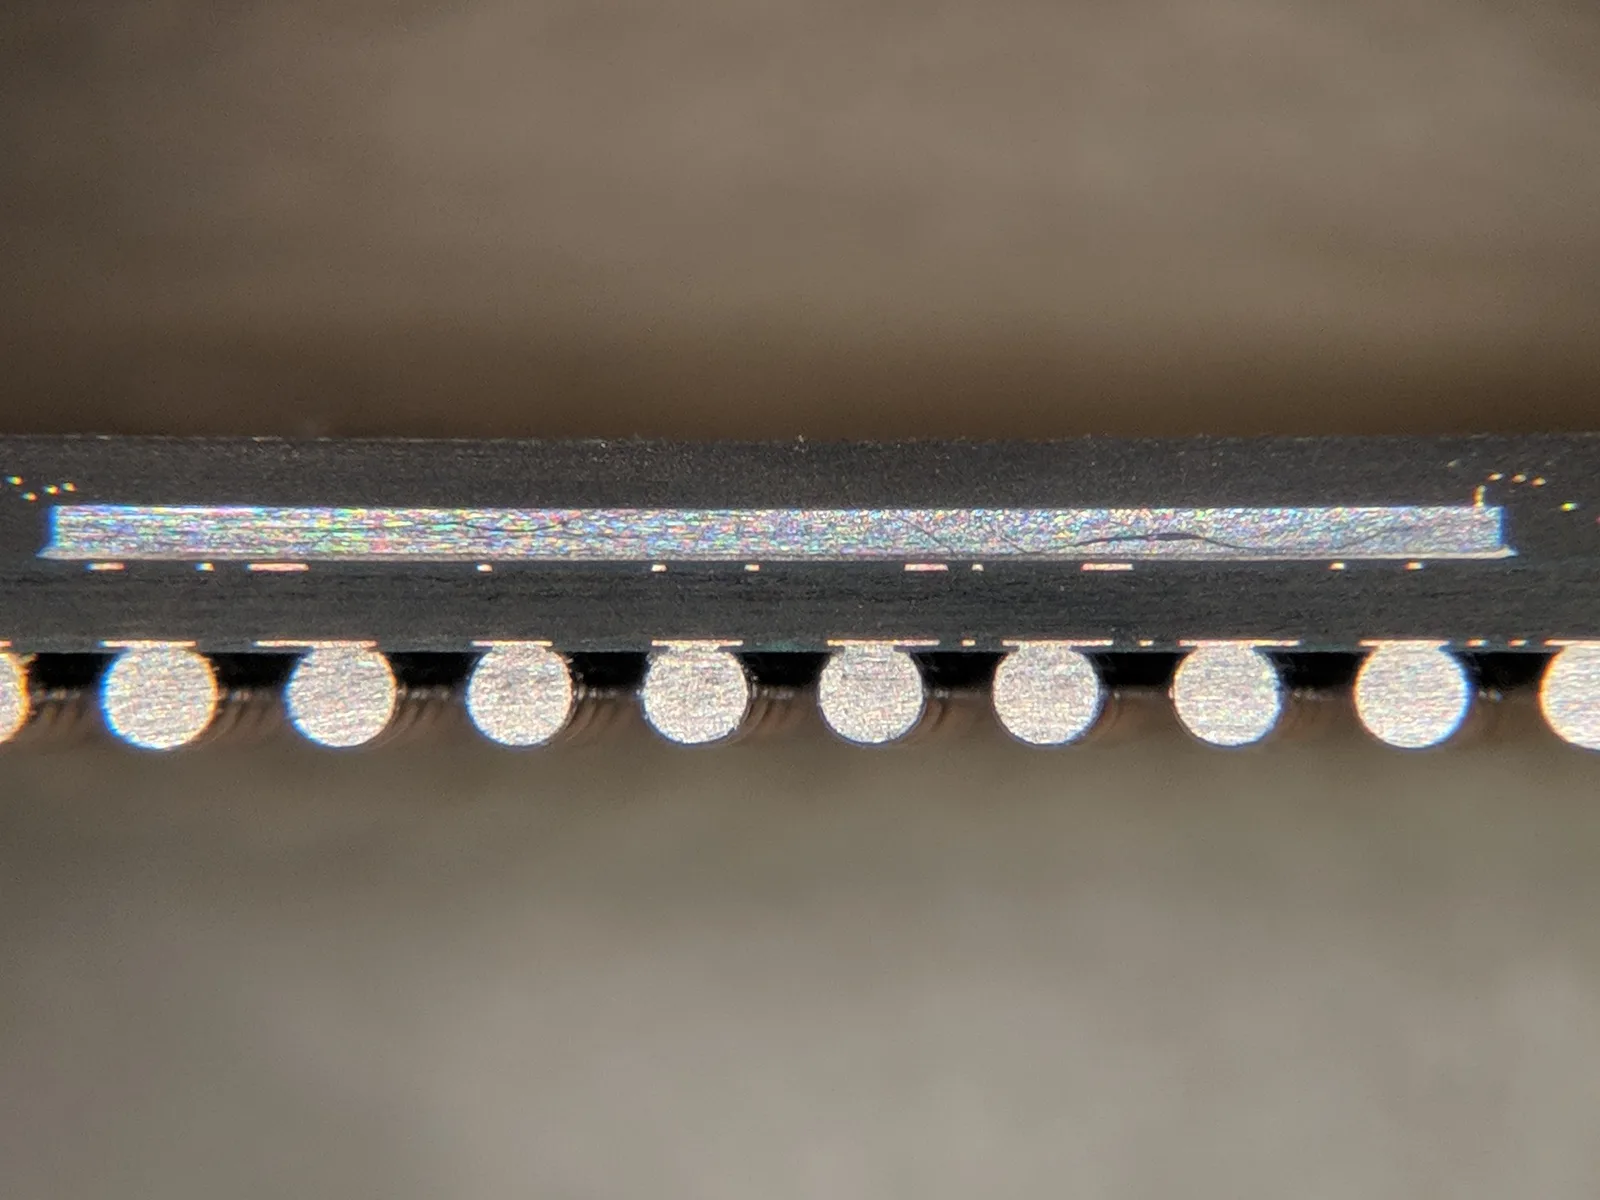
Prawdziwym przełomem, który otworzył erę gęstej integracji 3D, stała się technologia hybrydowego wiązania bezpośredniego DBI Direct Bond Interconnect, zwana również łączeniem miedź-miedź Cu-Cu Hybrid Bonding. W procesie tym całkowicie rezygnuje się ze stosowania jakichkolwiek spoiw lutowniczych na rzecz bezpośredniego, atomowego zgrzewania idealnie wypolerowanych powierzchni miedzi i dielektryka w temperaturze pokojowej lub umiarkowanej.
Dzięki wyeliminowaniu kulek lutowniczych skok połączeń w hybrydowym wiązaniu udało się zredukować poniżej jednego mikrometra, co przekłada się na gęstość połączeń przekraczającą milion styków na milimetr kwadratowy podłoża. W rezultacie opóźnienie propagacji sygnału między ułożonymi pionowo chipletami spada do ułamków pikosekundy, a zużycie energii wynosi poniżej zero przecinek zero pięciu pikodżula na bit, zacierając granicę między fizycznie osobnymi matrycami a monolitycznym kryształem krzemu.
Inżynieria chemiczno-mechaniczna: Polerowanie CMP i fuzja atomowa
Proces wytwarzania hybrydowych połączeń Cu-Cu stawia najwyższe wymagania przed inżynierią chemiczno-mechanicznego planaryzowania powierzchni CMP Chemical Mechanical Planarization. Aby możliwe było uzyskanie idealnego wiązania molekularnego, chropowatość powierzchni dielektryka tlenkowego oraz metalowych padów miedzianych musi być mniejsza niż zero przecinek pięć nanometra, co odpowiada grubości zaledwie dwóch warstw atomowych.
Podczas procesu polerowania CMP inżynierowie muszą precyzyjnie kontrolować zjawisko dishingu, czyli różnicy w tempie usuwania miękkiej miedzi w stosunku do twardszego dwutlenku krzemu SiO2 lub węgloazotku krzemu SiCN. W zaawansowanym procesie miedź jest celowo polerowana w taki sposób, aby jej powierzchnia znajdowała się od jednego do dwóch nanometrów poniżej poziomu otaczającego dielektryka, tworząc kontrolowane mikrozagłębienie.
W pierwszym etapie łączenia dwa wafle krzemowe lub matryce są precyzyjnie pozycjonowane względem siebie z dokładnością sub-stu nanometrów przy użyciu optycznych mikroskopów interferometrycznych i dociskane w próżni. W temperaturze pokojowej dochodzi do natychmiastowego wiązania spontanicznego powierzchni dielektrycznych pod wpływem sił Van der Waalsa oraz tworzenia wiązań wodorowych pomiędzy zaadsorbowanymi grupami hydroksylowymi OH.
Następnie układ jest poddawany wygrzewaniu termicznemu Annealing w temperaturze od dwustu do trzystu stopni Celsjusza. W tych warunkach para wodna ulega dyfuzji w głąb dielektryka, przekształcając wiązania wodorowe w silne kowalencyjne wiązania krzem-tlen-krzem Si-O-Si. Jednocześnie miedź, posiadająca wyższy współczynnik rozszerzalności cieplnej niż otaczający tlenek, ulega rozszerzeniu termicznemu, wypełniając mikrozagłębienie i dociskając się do przeciwległego padu. W podwyższonej temperaturze zachodzi gwałtowna dyfuzja atomowa miedzi wzdłuż granic ziaren, tworząc trwałe, monolityczne połączenie metaliczne o minimalnej rezystancji stykowej.
Przelotki przez podłoże krzemowe TSV i architektury CoWoS oraz Foveros
Nierozerwalnym partnerem hybrydowego wiązania są przelotki przez podłoże krzemowe TSV Through-Silicon Vias. Są to mikroskopijne pionowe kolumny miedziane wytrawiane w strukturze krzemu za pomocą głębokiego trawienia jonowego DRIE Deep Reactive-Ion Etching w procesie Boscha, a następnie wypełniane miedzią metodą elektrochemicznej depozycji galwanicznej ECD.
Przelotki TSV umożliwiają zasilanie oraz transfer danych przez całą grubość podłoża krzemowego, które przed montażem jest mechanicznie i chemicznie pocieniane Grinding & CMP z początkowych siedmiuset mikrometrów do zaledwie trzydziestu, a w niektórych procesach nawet do kilkunastu mikrometrów. Zaawansowane struktury TSV charakteryzują się stosunkiem głębokości do średnicy Aspect Ratio przekraczającym dziesięć do jednego, co pozwala na upakowanie dziesiątek tysięcy pionowych kanałów transmisyjnych w pojedynczym chipie.
Praktyczną demonstracją tej potęgi są wiodące architektury packagingu 2.5D i 3D rozwijane przez liderów rynkowych. Firma TSMC dominuje w segmencie akceleratorów sztucznej inteligencji dzięki platformie CoWoS Chip-on-Wafer-on-Substrate. W wariancie CoWoS-S rdzenie obliczeniowe oraz stosy ultraszybkiej pamięci HBM3e i HBM4 są montowane na pasywnym interposerze krzemowym z gęstymi połączeniami miedzianymi i przelotkami TSV, który z kolei jest osadzany na organicznym podłożu obudowy.
Z kolei Intel rozwija komplementarne technologie EMIB Embedded Multi-die Interconnect Bridge oraz Foveros Direct. EMIB to miniaturowy mostek krzemowy zatopiony w organicznym laminacie, który łączy sąsiadujące chiplety z ultrawysoką gęstością bez konieczności stosowania drogiego, pełnowymiarowego interposera. Natomiast Foveros Direct to szczytowe osiągnięcie trójwymiarowej integracji 3D, umożliwiające bezpośrednie hybrydowe wiązanie Cu-Cu matrycy obliczeniowej na matrycy bazowej Base Die z pominięciem jakichkolwiek mikro-kulek, redukując opóźnienia komunikacyjne do poziomów monolitycznych.
Termomechanika 3D: Piekło rozszerzalności cieplnej CTE i deformacji Warpage
Mimo spektakularnych korzyści wydajnościowych, upakowanie wielowarstwowych struktur krzemowych w zwartej obudowie 3D rodzi potężne wyzwania natury termomechanicznej. W procesorze o poborze mocy przekraczającym tysiąc watów gęstość wydzielania ciepła w pionowych hotspotach może osiągnąć kilkaset watów na centymetr kwadratowy, co przewyższa strumień ciepła na powierzchni rdzenia reaktora jądrowego.
Wielowarstwowa struktura składająca się z krzemu, dielektryków tlenkowych, miedzianych przelotek, polimerowych żywic podlewających Underfill oraz organicznych laminatów charakteryzuje się ogromnym niedopasowaniem współczynników rozszerzalności cieplnej CTE Coefficient of Thermal Expansion. Krzem posiada współczynnik CTE na poziomie dwóch przecinek sześciu części na milion na stopień Celsjusza, podczas gdy miedź ma CTE rzędu siedemnastu, a laminat organiczny od piętnastu do dwudziestu.
Podczas cyklicznego nagrzewania i chłodzenia procesora w warunkach zmiennego obciążenia obliczeniowego, zróżnicowana rozszerzalność termiczna poszczególnych warstw generuje gigantyczne naprężenia ścinające na granicach faz. Może to prowadzić do zjawiska deformacji obudowy Warpage, delaminacji warstw dielektrycznych oraz zmęczeniowego pękania połączeń hybrydowych Cu-Cu. Z tego względu inżynierowie materiałowi wprowadzają innowacyjne materiały kompozytowe z wypełniaczami ceramicznymi o ujemnym współczynniku rozszerzalności cieplnej, które kompensują naprężenia strukturalne.
Równie krytycznym zagadnieniem jest odprowadzanie ciepła z dolnych warstw stosu 3D. Ciepło generowane przez dolną matrycę bazową musi przepłynąć przez warstwy tlenków i połączeń do górnego radiatora. Odpowiedzią staje się integracja mikrokanalików chłodzenia cieczowego Microfluidic Cooling bezpośrednio w strukturze krzemowego interposera lub zintegrowanych radiatorów diamentowych CVD, które charakteryzują się przewodnością cieplną pięciokrotnie wyższą od czystej miedzi.
Pamięci HBM4 i rewolucja przepustowości: Ponad 2 terabajty na sekundę
Najbardziej spektakularnym beneficjentem technologii hybrydowego łączenia 3D są pamięci o wysokiej przepustowości HBM High Bandwidth Memory, stanowiące absolutnie krytyczny komponent akceleratorów sztucznej inteligencji. W tradycyjnych modułach HBM3e stosy od ośmiu do dwunastu matryc DRAM są łączone pionowo za pomocą przelotek TSV i mikro-kulek lutowniczych, komunikując się z procesorem za pośrednictwem magistrali o szerokości tysiąca dwudziestu czterech bitów.
W nadchodzącym standardzie HBM4 szerokość magistrali pamięciowej zostaje podwojona do dwóch tysięcy czterdziestu ośmiu bitów, co przy taktowaniu interfejsu pozwala na osiągnięcie oszałamiającej przepustowości przekraczającej dwa terabajty na sekundę na pojedynczy stos pamięci. Zastosowanie hybrydowego wiązania Cu-Cu w HBM4 pozwoliło na eliminację warstw spoiwa lutowniczego i żywic podlewających, co zredukowało grubość całego szesnastowarstwowego stosu pamięci, umożliwiając bezpośrednie chłodzenie i drastyczny spadek oporności termicznej.
Co więcej, dolna matryca bazowa stosu Base Die w HBM4 przestaje być prostym układem logicznym wytwarzanym w starym procesie, stając się zaawansowanym chipem obliczeniowym produkowanym w węźle 3nm lub 4nm. Umożliwia to realizację koncepcji przetwarzania w pamięci PIM Processing-In-Memory, w której proste operacje redukcji tensorowej, aktywacji i normalizacji danych są wykonywane bezpośrednio wewnątrz stosu pamięci, odciążając główny procesor graficzny i eliminując konieczność przesyłania terabajtów danych przez interposer.
Geopolityka zaawansowanego packagingu: Nowe wąskie gardło potęg technologicznych
Transformacja w kierunku 3D-IC i heterogenicznej integracji doprowadziła do fundamentalnego przesunięcia środka ciężkości w geopolityce półprzewodników. Przez dekady uwaga rządów i analityków wojskowych skupiała się niemal wyłącznie na skanerach litograficznych EUV produkowanych przez holenderski ASML oraz najnowocześniejszych fabrykach na Tajwanie. Dziś okazuje się, że posiadanie dostępu do węzła 3nm jest bezużyteczne, jeśli producent nie dysponuje zdolnościami w zakresie zaawansowanego packagingu CoWoS lub Foveros.
To właśnie brak wystarczających mocy produkcyjnych w liniach zaawansowanego packagingu TSMC stał się głównym wąskim gardłem ograniczającym globalne dostawy akceleratorów Nvidia Hopper i Blackwell w szczytowym momencie gorączki sztucznej inteligencji. Rząd Stanów Zjednoczonych, dostrzegając to krytyczne uzależnienie, przeznaczył w ramach ustawy CHIPS and Science Act miliardy dolarów na budowę krajowych centrów zaawansowanego montażu, w tym wielkich inwestycji Intela w Nowym Meksyku oraz Amkoru w Arizonie.
Równocześnie zaawansowany packaging stał się kluczowym polem manewru dla Chin objętych zachodnimi sankcjami technologicznymi. Pozbawiony dostępu do najnowocześniejszych maszyn EUV chiński przemysł półprzewodnikowy, na czele z koncernami SMIC i Huawei, intensywnie rozwija technologie łączenia chipletowego i interposerów krzemowych. Łącząc dwa lub trzy chipy wyprodukowane w starszym węźle 7nm za pomocą zaawansowanego packagingu 3D, chińscy inżynierowie są w stanie syntetyzować procesory o wydajności dorównującej układom zachodnim, częściowo neutralizując skutki embarga.
W perspektywie najbliższej dekady zaawansowany packaging 3D-IC przestanie być jedynie techniką montażową, stając się nadrzędną dziedziną architektury komputerowej. Granica między krzemem a obudową ulegnie ostatecznemu zatarciu, a zwycięzcami w globalnym wyścigu o dominację technologiczną zostaną te podmioty, które opanują nie tylko nanometrowy rysunek tranzystorów, lecz przede wszystkim atomową precyzję ich trójwymiarowego scalania w megawatowe superstruktury obliczeniowe.
Warto szczegółowo zbadać zagadnienie zjawiska elektromigracji EM w mikroskopijnych padach miedzianych hybrydowego wiązania Cu-Cu przy skrajnie wysokich gęstościach prądu elektrycznego. Gdy gęstość prądu przekracza megaamper na centymetr kwadratowy, transfer pędu z przepływających elektronów prowadzi do fizycznego dryfu atomów miedzi wzdłuż granic ziaren, wywołując powstawanie mikroskopijnych pustek Voiding po stronie katodowej oraz nawisów materiałowych Hillocks po stronie anodowej. Zastosowanie nanobliźniaczej miedzi nanotwinned copper o wysokiej gęstości spójnych granic bliźniaczych pozwala na podniesienie energii aktywacji dyfuzji atomowej, redukując tempo elektromigracji o ponad dwa rzędy wielkości i gwarantując bezawaryjną pracę złączy 3D przez dekady.
Równie istotnym aspektem jest standaryzacja otwartych interfejsów połączeń chipletowych, ze szczególnym uwzględnieniem protokołu UCIe Universal Chiplet Interconnect Express. W początkowej fazie rewolucji chipletowej każdy producent stosował własne, zamknięte protokoły warstwy fizycznej, takie jak Intel AIB czy TSMC LIPINCON, co uniemożliwiało integrację matryc pochodzących od różnych wytwórców. Wprowadzenie standardu UCIe zdefiniowało uniwersalną warstwę fizyczną PHY oraz protokoły die-to-die oparte na PCIe i CXL, otwierając drogę do powstania globalnego rynku standaryzowanych klocków krzemowych, w którym startupy mogą łączyć własne akceleratory z gotowymi modułami pamięciowymi i procesorami głównymi.
Nie wolno także pomijać roli zaawansowanego oprogramowania do projektowania układów scalonych EDA Electronic Design Automation w erze 3D-IC. Projektowanie stosu trójwymiarowego wymaga jednoczesnej symulacji wielofizycznej multiphysics, obejmującej ekstrakcję pasożytniczych parametrów RLC, numeryczną dynamikę płynów dla rozpraszania ciepła oraz mechanikę naprężeń termicznych. Narzędzia nowej generacji wykorzystują algorytmy uczenia maszynowego do automatycznej optymalizacji rozmieszczenia przelotek TSV i padów zasilających, zapobiegając powstawaniu lokalnych spadków napięcia IR drop oraz termicznych punktów przegrzania zanim projekt trafi na wafel krzemowy.
Wymiar strategiczny technologii 3D-IC ujawnia się także w kontekście miniaturyzacji systemów wojskowych i awioniki kosmicznej. Możliwość zintegrowania w pojedynczej obudowie wielordzeniowego procesora radaru AESA, szybkich przetworników ADC/DAC, pamięci nieulotnej oraz optycznych interkonektów krzemowych pozwala na drastyczną redukcję masy, objętości i poboru mocy SWaP Size, Weight, and Power systemów pokładowych satelitów i bezzałogowców, otwierając nową erę zintegrowanych systemów walki wielodomenowej.
Ekonomia Known Good Die KGD, fotonika CPO i metrologia rentgenowska złączy
Warto szczegółowo zbadać zagadnienie ekonomii uzysku znanego sprawnego chipu KGD Known Good Die oraz architekturę wbudowanych układów autotestujących BIST Built-In Self-Test w strukturach 3D-IC. W montażu monolitycznym wadliwy element ujawnia się na etapie testowania wafla, co skutkuje odrzuceniem pojedynczej matrycy. W przypadku zaawansowanego montażu 3D, w którym pakiet składa się z dwóch procesorów obliczeniowych, interposera i ośmiu stosów pamięci HBM, wbudowanie pojedynczego wadliwego chipletu powoduje zniszczenie całego, wartego dziesiątki tysięcy dolarów podzespołu. Wymusza to opracowanie rygorystycznych procedur testowania elektrycznego na poziomie wafla przed pocienieniem i pocięciem na kości, a także implementację redundantnych przelotek TSV i zapasowych linii sygnałowych rekonfigurowanych bezpiecznikami laserowymi lub komórkami eFuse w przypadku wykrycia uszkodzonego połączenia.
Równie przełomowym kierunkiem jest konwergencja zaawansowanego packagingu 3D-IC z optoelektroniką współpakowaną CPO Co-Packaged Optics. Tradycyjne miedziane łącza elektryczne na płytkach drukowanych, pracujące z prędkościami przekraczającymi sto dwanaście gigabitów na sekundę na linię SerDes, charakteryzują się potężnym tłumieniem sygnału i generują ogromne ilości ciepła stratnego. Integracja fotonicznych układów scalonych PIC Photonics Integrated Circuit bezpośrednio na krzemowym interposerze obok procesora obliczeniowego pozwala na bezpośrednią konwersję sygnałów elektrycznych na impulsy laserowe wewnątrz obudowy chipu. Umożliwia to wyprowadzenie petabitowych strumieni danych za pośrednictwem pojedynczych włókien światłowodowych z niemal zerową latencją i wielokrotnie niższym zużyciem energii na bit.
Nie można pominąć również zaawansowanej metrologii nieniszczącej niezbędnej do inspekcji połączeń hybrydowych Cu-Cu o wymiarach submikronowych. Tradycyjna mikroskopia optyczna jest bezużyteczna do badania ukrytych wewnątrz struktury złączy miedzianych, natomiast transmisyjna mikroskopia elektronowa TEM wymaga destrukcyjnego preparowania próbek. W liniach produkcyjnych wysokiej skali stosuje się wysokorozdzielczą tomografię rentgenowską X-ray Tomography ze źródłami promieniowania synchrotronowego oraz skaningową mikroskopię akustyczną SAM Scanning Acoustic Microscopy o częstotliwościach rzędu gigaherców, które pozwalają na bezinwazyjne wykrywanie pustek atomowych, delaminacji warstw oraz pęcherzyków gazu uwięzionych na granicy faz dielektrycznych.
Ostatecznym sprawdzianem dla dojrzałości technologicznej heterogenicznej integracji trójwymiarowej będzie jej zdolność do fuzji z technologią zasilania od tyłu Backside Power Delivery BPD. Przeniesienie miedzianych sieci dystrybucji zasilania PDN na tylną stronę wafla krzemowego uwalnia przednią stronę wyłącznie dla gęstych połączeń logicznych i pamięciowych, całkowicie eliminując interferencje pomiędzy prądami zasilającymi a szybkimi liniami zegarowymi. Połączenie zasilania od tyłu z bezpośrednim wiązaniem hybrydowym Foveros Direct tworzy zintegrowaną trójwymiarową matrycę obliczeniową, w której elektrony zasilające wnikają z dołu, fotony danych przepływają z góry, a obliczenia tensorowe zachodzą w idealnie zbalansowanym, chłodzonym cieczowo sercu krzemowego monolitu nowej generacji.
Nie wolno również zapominać o krytycznej roli materiałów polimerowych, takich jak folie izolacyjne Ajinomoto Build-up Film ABF, stanowiące chemiczny fundament wielowarstwowych podłoży organicznych w obudowach 2.5D i 3D. Wszelkie zawirowania w dostawach tych specjalistycznych żywic epoksydowo-fenolowych z Japonii potrafią sparaliżować montaż najnowocześniejszych akceleratorów sztucznej inteligencji na całym świecie, dowodząc, że łańcuch wartości zaawansowanego packagingu zależy w równym stopniu od fizyki submikronowych złączy, co od niszowej chemii organicznej. Dążenie do suwerenności technologicznej wymaga zatem budowy kompletnych ekosystemów materiałowych, łączących wytwarzanie podłoży ABF, precyzyjne żywice polerujące dla CMP oraz ultra-czyste gazy trawiące w zintegrowany kompleks przemysłowy najwyższej próby.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.