
Fotonika krzemowa i rewolucja optyki współpakowanej Co-Packaged Optics: Jak lasery DFB, modulatory elektrooptyczne i interkonekty świetlne eliminują opór miedzi w klastrach akceleratorów sztucznej inteligencji
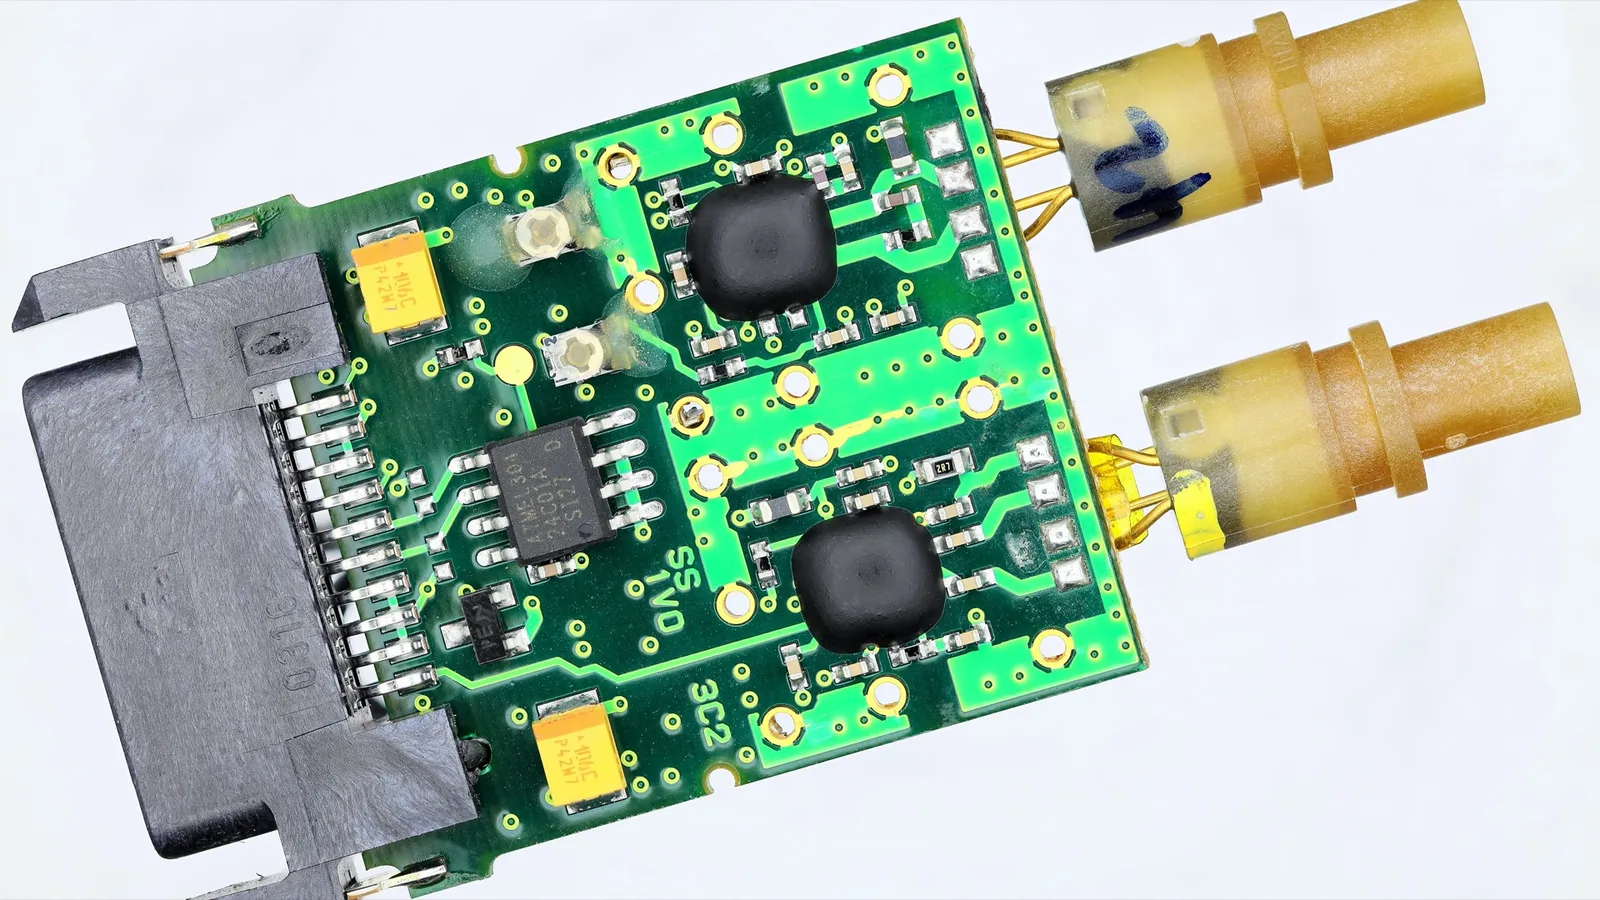
Ściana miedzi i kryzys termiczny w wielkoskalowych klastrach akceleratorów AI
Współczesna rewolucja sztucznej inteligencji opiera się na masowym przetwarzaniu rozproszonym, w którym tysiące wyspecjalizowanych akceleratorów graficznych i procesorów tensorowych wymieniają między sobą terabajty parametrów wag i gradientów w każdej milisekundzie treningu. Przez dekady inżynierowie polegali na sprawdzonych, miedzianych ścieżkach drukowanych oraz pasywnych i aktywnych kablach miedzianych (Direct Attach Copper, DAC) do łączenia chipów wewnątrz szaf serwerowych. Wraz z nadejściem standardów transmisyjnych PCIe 6.0 i 7.0 oraz magistrali Ethernet o prędkościach 800 Gb/s i 1.6 Tb/s, fizyka przewodnictwa elektrycznego w miedzi dotarła jednak do bezwzględnego muru, zwanego w branży mikroelektronicznej ścianą miedzi (copper wall).
Przy częstotliwościach sygnałowych przekraczających sto gigaherców i modulacji czteropoziomowej PAM4, w przewodnikach miedzianych dramatycznie nasila się efekt naskórkowości (skin effect), sprawiający, że prąd elektryczny płynie wyłącznie cienką warstwą przypowierzchniową przewodu. Towarzyszą temu gwałtowne straty dielektryczne w laminatach płytek drukowanych, zjawiska dyspersji oraz przesłuchy elektromagnetyczne pomiędzy gęsto upakowanymi liniami transmisyjnymi. Sygnał elektryczny ulega tak silnej degradacji, że maksymalny zasięg bezstratnej transmisji miedzianej przy prędkości 224 Gb/s na linię skurczył się do zaledwie kilkunastu centymetrów na laminacie i poniżej metra w przypadku najgrubszych, sztywnych kabli miedzianych.
Aby skompensować te gigantyczne straty sygnału, producenci sprzętu zmuszeni byli do umieszczania na płytach głównych potężnych wzmacniaczy i regeneratorów sygnału (re-timerów) oraz skomplikowanych bloków cyfrowego przetwarzania sygnału (DSP) w układach SerDes (Serializer/Deserializer). W rezultacie same układy odpowiedzialne za przesyłanie bitów pomiędzy procesorem a gniazdem sieciowym zaczęły pochłaniać od dwudziestu do nawet trzydziestu procent całkowitego budżetu energetycznego przełącznika sieciowego lub akceleratora. W klastrach liczących sto tysięcy układów oznacza to marnowanie dziesiątek megawatów drogiej energii elektrycznej wyłącznie na pokonanie oporu omowego miedzi, generując przy tym gigantyczne ilości ciepła odpadowego, którego odprowadzenie staje się koszmarem inżynierów chłodnictwa.
Sytuację pogarsza fakt, że rosnące zapotrzebowanie na przepustowość pamięci i komunikacji międzychipowej doprowadziło do zjawiska tak zwanego uwięzienia brzegowego (beachfront bottleneck). Krawędzie krzemowego chipu mają ściśle ograniczony obwód, na którym można rozmieścić fizyczne pady wejścia-wyjścia. W miarę jak wymagana przepustowość procesora rośnie w kierunku kilkudziesięciu terabitów na sekundę, fizyczne wyprowadzenie setek miedzianych linii transmisyjnych przez podłoże BGA staje się geometrycznie niemożliwe bez drastycznego powiększenia powierzchni krzemu, co uderza w rentowność produkcji w najnowocześniejszych węzłach litograficznych.
Ewolucja interkonektów: Od modułów wtykowych przez NPO do Co-Packaged Optics
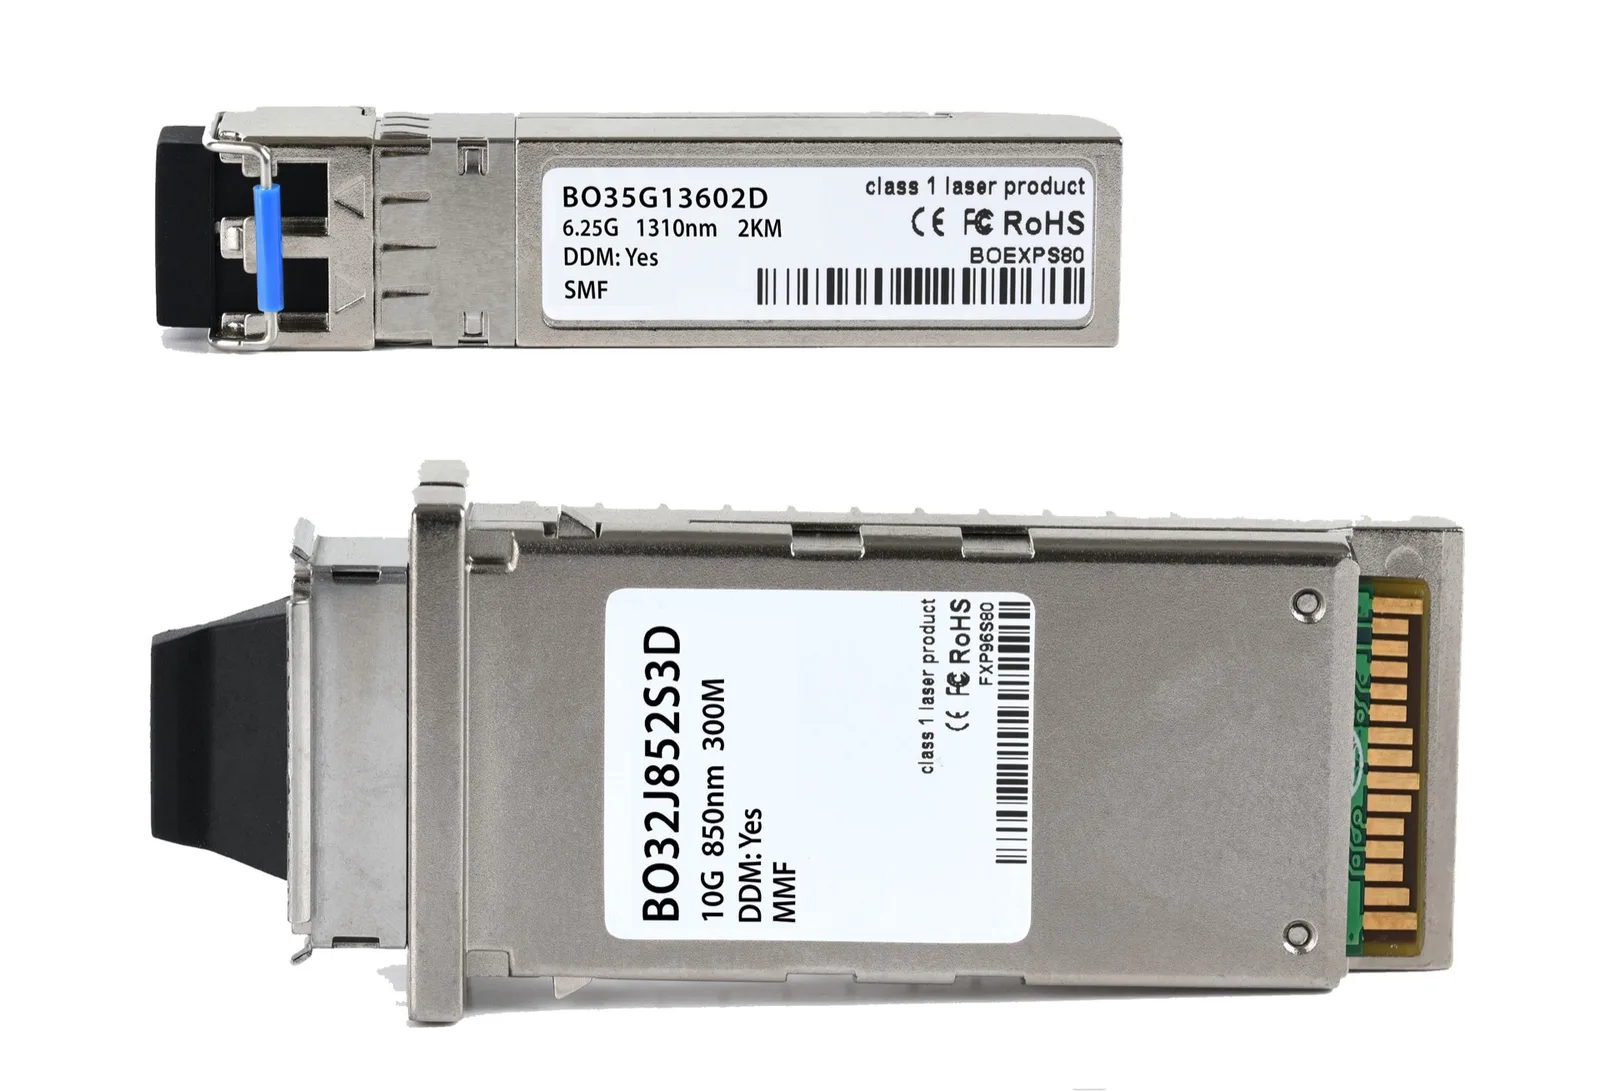
Przez ostatnie trzydzieści lat podstawowym sposobem wprowadzania światłowodów do urządzeń sieciowych były optyczne moduły wtykowe (pluggable optical transceivers). Od historycznych standardów GBIC i X2, przez wszechobecne SFP+ i QSFP, aż po najnowsze moduły OSFP o przepustowości 800 Gb/s, architektura wtykowa oferowała operatorom centrów danych bezcenną elastyczność: możliwość łatwej wymiany uszkodzonego lasera, dopasowania zasięgu łącza do potrzeb oraz stopniowej rozbudowy infrastruktury w miarę wzrostu ruchu sieciowego. W tym tradycyjnym modelu sygnał elektryczny z procesora przełączającego musiał pokonać długą, wielocentymetrową drogę po miedzianych ścieżkach laminatu, przejść przez gniazdo mechaniczne na panelu czołowym i trafić do modułu wtykowego, gdzie układ DSP przekształcał go na sygnał sterujący laserem.
Przy przepustowościach rzędu 1.6 Tb/s i 3.2 Tb/s na gniazdo architektura modułów wtykowych przestaje być wykonalna pod względem energetycznym i mechanicznym. Upakowanie trzydziestu dwóch modułów o mocy trzydziestu watów każdy na jednocalowym panelu czołowym szafy rackowej tworzy barierę cieplną niemożliwą do schłodzenia tradycyjnym strumieniem powietrza. Pierwszym krokiem przejściowym stała się koncepcja optyki blisko-pakowanej (Near-Package Optics, NPO), w której silniki optyczne przeniesiono z panelu czołowego bezpośrednio na płytę główną w odległość kilku centymetrów od procesora, skracając miedziane linie transmisyjne i redukując straty mocy.
Prawdziwym przełomem i docelowym modelem architektonicznym jest jednak optyka współpakowana (Co-Packaged Optics, CPO). W tym podejściu silnik fotoniczny (Photonic Integrated Circuit, PIC) oraz dedykowany sterownik elektroniczny (Electronic Integrated Circuit, EIC) zostają zintegrowane bezpośrednio na wspólnym zaawansowanym podłożu krzemowym (interposerze) w jednej obudowie wieloukładowej (multi-chip module) wraz z głównym procesorem obliczeniowym lub przełącznikiem sieciowym. Technologie zaawansowanego pakowania 2.5D i 3D, takie jak TSMC CoWoS (Chip-on-Wafer-on-Substrate) czy Intel EMIB, pozwalają na skrócenie miedzianych połączeń elektrycznych między procesorem a silnikiem optycznym z kilkunastu centymetrów do zaledwie kilku milimetrów lub nawet mikrometrów.
Dzięki tak drastycznemu skróceniu drogi sygnału elektrycznego całkowicie znikają straty dielektryczne i zjawiska pasożytnicze laminatu płyty głównej. Sygnał może być przesyłany bezpośrednio z rdzenia obliczeniowego do modulatora optycznego przy użyciu skrajnie uproszczonych, ultralekkich bloków interfejsowych, eliminując konieczność stosowania energochłonnych układów re-timerów DSP. W efekcie zużycie energii na przesłanie pojedynczego bitu informacji spada o ponad siedemdziesiąt procent, a sygnał z wnętrza procesora niemal natychmiast opuszcza obudowę w postaci fotonów płynących w elastycznych wstęgach światłowodowych.
Architektura krzemowego układu fotonicznego (PIC): Falowody, złącza siatkowe i rezonatory pierścieniowe
Fotonika krzemowa zawdzięcza swój triumf unikalnej cesze: możliwości wytwarzania precyzyjnych struktur optycznych przy użyciu tych samych masowych linii produkcyjnych CMOS i trzystumilimetrowych wafli krzemowych, które od dziesięcioleci służą do produkcji procesorów i pamięci. Krzem (Si) jest przezroczysty dla światła podczerwonego w standardowych oknach telekomunikacyjnych 1310 nm (pasmo O) oraz 1550 nm (pasmo C). Co niezwykle istotne, krzem charakteryzuje się bardzo wysokim współczynnikiem załamania światła wynoszącym około 3.45, podczas gdy otaczający go dwutlenek krzemu (SiO2) ma współczynnik załamania na poziomie 1.45. Ta gigantyczna różnica współczynników załamania pozwala na tworzenie mikroskopijnych falowodów optycznych o przekroju zaledwie kilkuset nanometrów, w których światło ulega całkowitemu wewnętrznemu odbiciu i może być prowadzone po ostrych łukach bez strat radiacyjnych.
Kluczowym elementem każdego układu PIC jest modulator elektrooptyczny, którego zadaniem jest nałożenie cyfrowego strumienia bitów elektrycznych na ciągłą falę świetlną emitowaną przez laser. Tradycyjnie stosowane modulatory interferometryczne Macha-Zehndera (MZM) opierają się na zjawisku dyspersji plazmowej w złączu p-n: zmiana napięcia elektrycznego moduluje gęstość nośników ładunku w jednym z ramion interferometru, co wywołuje przesunięcie fazowe i destrukcyjną interferencję światła. Choć modulatory MZM są wysoce stabilne termicznie i oferują szerokie pasmo pracy, ich długość wynosi zazwyczaj od jednego do kilku milimetrów, co ogranicza gęstość upakowania kanałów optycznych.
Rewolucyjną alternatywą stają się krzemowe rezonatory pierścieniowe (Micro-Ring Resonators, MRR). Rezonator pierścieniowy to miniaturowy kolisty falowód o średnicy zaledwie kilku do kilkunastu mikrometrów umieszczony w odległości kilkudziesięciu nanometrów od prostego falowodu magistralnego. Gdy długość fali światła odpowiada częstotliwości rezonansowej pierścienia, światło zostaje uwięzione w pierścieniu i ulega wygaszeniu. Niewielka zmiana napięcia elektrycznego na złączu pierścienia przesuwa pik rezonansowy, modulując strumień światła przy ułamku zużycia energii wymaganego przez modulator MZM – często poniżej stu femtodżuli na bit. Miniaturowe rozmiary rezonatorów pierścieniowych pozwalają na równoległe umieszczenie kilkudziesięciu takich struktur na powierzchni mniejszej niż milimetr kwadratowy, co umożliwia gęste multipleksowanie z podziałem falowym (DWDM).
Wprowadzenie światła ze światłowodu do miniaturowego falowodu krzemowego stanowiło przez lata jedno z największych wyzwań inżynieryjnych ze względu na ogromną dysproporcję średnic: rdzeń standardowego światłowodu jednomodowego ma średnicę około dziewięciu mikrometrów, podczas gdy falowód krzemowy ma wymiary rzędu pięciuset na dwieście dwadzieścia nanometrów. Problem ten rozwiązano za pomocą dwóch komplementarnych technologii: sprzęgaczy siatkowych (grating couplers) wytrawianych na powierzchni chipu, które uginają i wprowadzają wiązkę padającą prostopadle z góry, oraz sprzęgaczy krawędziowych (edge couplers) ze stożkowymi adapterami modowymi (spot-size converters), które oferują skrajnie niskie straty wtrąceniowe poniżej jednego decybela w szerokim paśmie optycznym.
Źródła światła laserowego: DFB, lasery hybrydowe III-V i zewnętrzny moduł ELSFP
Mimo bezspornych zalet krzemu jako materiału do prowadzenia i modulowania światła, pierwiastek ten posiada jedną fundamentalną wadę fizyczną: jest półprzewodnikiem o skośnej przerwie energetycznej (indirect bandgap). Oznacza to, że rekombinacja elektronu z dziurą wymaga udziału fononu w sieci krystalicznej, co sprawia, że krzem jest dramatycznie nieefektywny w generowaniu fotonów i nie pozwala na skonstruowanie bezpośredniego lasera krzemowego. Rozwiązanie problemu źródła światła wymagało zatem połączenia krzemu z materiałami półprzewodnikowymi z grup III-V układu okresowego, takimi jak fosforek indu (InP) czy arsenek galu (GaAs), charakteryzującymi się prostą przerwą energetyczną.
Wiodące instytuty badawcze i korporacje półprzewodnikowe opracowały technologię laserów hybrydowych, w której cienkie warstwy fosforku indu są nanoszone bezpośrednio na wafel krzemowy za pomocą wiązania molekularnego w temperaturze pokojowej (wafer-to-wafer lub die-to-wafer bonding). Generowanie światła odbywa się w warstwie III-V, natomiast ukształtowanie rezonatora optycznego, siatki Bragga lasera DFB (Distributed Feedback) oraz wyprowadzenie fali realizowane jest w podłożu krzemowym. Takie monolityczne połączenie pozwala na zintegrowanie setek źródeł laserowych na jednym waflu w procesie produkcyjnym o wysokim uzysku.
Praktyka inżynieryjna wielkich centrów danych ujawniła jednak poważny problem związany z umieszczaniem laserów bezpośrednio w obudowie potężnego procesora AI. Diody laserowe są elementami skrajnie wrażliwymi na temperaturę: ich wydajność kwantowa drastycznie spada wraz ze wzrostem temperatury powyżej pięćdziesięciu stopni Celsjusza, a średni czas bezawaryjnej pracy (MTBF) skraca się o połowę na każde dziesięć stopni wzrostu temperatury złącza. W tym samym czasie nowoczesne akceleratory GPU i przełączniki sieciowe wydzielają do tysiąca watów ciepła, pracując w temperaturach struktury sięgających dziewięćdziesięciu stopni.
Aby rozwiązać ten dylemat niezawodnościowy, konsorcjum OIF (Optical Internetworking Forum) zdefiniowało standard zewnętrznego źródła światła ELSFP (External Laser Small Form-Factor Pluggable). W architekturze tej lasery DFB zostają umieszczone w wymiennym module wtykowym zainstalowanym na chłodnym panelu czołowym serwera, gdzie temperatura powietrza wynosi około dwudziestu pięciu stopni. Czyste, niemodulowane światło laserowe w paśmie falowym (continuous wave, CW) przesyłane jest światłowodami polaryzacyjnymi do wnętrza obudowy procesora, gdzie zasila modulatory silnika CPO. W przypadku awarii diody laserowej technik w centrum danych może w kilka sekund wymienić moduł ELSFP w trybie hot-plug bez konieczności demontażu i złomowania wartego kilkadziesiąt tysięcy dolarów węzła obliczeniowego.
Przełom energetyczny i gęstość pasma: Poniżej 3 pikodżuli na bit i eliminacja re-timerów
Bilans energetyczny jest główną siłą napędową wymuszającą migrację światowego przemysłu półprzewodnikowego w kierunku Co-Packaged Optics. W tradycyjnych architekturach opartych na miedzi i wtykowych modułach optycznych całkowity koszt energetyczny przesłania jednego bitu informacji wynosi od piętnastu do nawet dwudziestu pięciu pikodżuli (pJ/bit). Składa się na to pobór mocy wewnętrznego nadajnika SerDes w procesorze, straty w długich miedzianych ścieżkach laminatu, zasilanie układu re-timera DSP w module optycznym oraz sam proces konwersji elektrooptycznej. Przy przepustowości przełącznika sieciowego wynoszącej 51.2 Tb/s oznacza to, że sam podsystem łączności pochłania ponad osiemset watów czystej energii elektrycznej.
Wdrożenie optyki współpakowanej CPO radykalnie zmienia ten bilans. Ponieważ odległość pomiędzy wyjściem logicznym procesora a modulatorem optycznym zostaje zredukowana do ułamka milimetra na interposerze krzemowym, pojemność pasożytnicza linii transmisyjnej spada z kilkunastu pikofaradów do zaledwie kilkudziesięciu femtofaradów. Umożliwia to zastosowanie miniaturowych stopni wyjściowych bez skomplikowanych korektorów charakterystyki częstotliwościowej (CTLE i DFE) oraz całkowitą rezygnację z bloków re-timerów DSP. Wiodące demonstratory technologii CPO osiągają efektywność energetyczną na poziomie od 1.5 do 3 pikodżuli na bit.
Dla szafy serwerowej klastra sztucznej inteligencji oznacza to oszczędność setek kilowatów energii elektrycznej, która zamiast na jałowe podgrzewanie miedzi może zostać bezpośrednio przekierowana do rdzeni obliczeniowych realizujących mnożenie macierzy. Ponadto eliminacja bloków DSP przynosi gigantyczną korzyść w postaci redukcji opóźnień transmisyjnych (latency). Podczas gdy cyfrowe przetwarzanie sygnału w module wtykowym wprowadza opóźnienie rzędu stu do stu pięćdziesięciu nanosekund na każdy węzeł sieci, bezpośrednia konwersja optyczna w CPO charakteryzuje się opóźnieniem poniżej pięciu nanosekund. W klastrach rozproszonych realizujących algorytmy AllReduce opóźnienie to decyduje o czasie przestoju procesorów oczekujących na synchronizację gradientów.
Równolegle CPO rozwiązuje wspomniany problem uwięzienia brzegowego. Zamiast ograniczać się do krawędzi układu scalonego, silniki optyczne mogą być rozmieszczane bezpośrednio nad lub pod interposerem logicznym z wykorzystaniem pionowych przelotek krzemowych (Through-Silicon Vias, TSV). Gęstość wyprowadzenia pasma optycznego w technologii CPO przekracza kilkaset terabitów na milimetr kwadratowy powierzchni, co pozwala na budowę monolitycznych procesorów sieciowych i akceleratorów o łącznej przepustowości interfejsów przekraczającej 100 Tb/s, co w technologii czysto miedzianej byłoby fizycznie niewykonalne.
Wyzwania produkcyjne, testowanie i serwisowalność w centrach danych
Mimo przytłaczających zalet fizycznych i energetycznych, droga do masowego wdrożenia Co-Packaged Optics w komercyjnych centrach danych usiana była potężnymi barierami inżynieryjnymi i technologicznymi. Pierwszym krytycznym wyzwaniem był problem uzysku produkcyjnego (manufacturing yield). W tradycyjnym podejściu procesor, pamięć HBM i moduły optyczne były produkowane i testowane całkowicie niezależnie, a ich montaż odbywał się na poziomie płytki drukowanej. W architekturze CPO wadliwy silnik fotoniczny lub błąd montażu złącza światłowodowego powoduje konieczność wyrzucenia do kosza całej, niezwykle kosztownej obudowy zawierającej procesor AI i stosy pamięci HBM. Wymusiło to opracowanie bezprecedensowych metod bezstykowego testowania optycznego na poziomie pojedynczych wafli (wafer-level optical testing).
Drugim gigantycznym wyzwaniem jest precyzyjny montaż złączy światłowodowych do chipu fotonicznego (fiber-to-chip attach). O ile w elektronice tolerancje pozycjonowania kulek lutowniczych wynoszą kilkadziesiąt mikrometrów, o tyle wprowadzenie fali świetlnej do falowodu wymaga pozycjonowania światłowodu z dokładnością submikronową, rzędu kilkuset nanometrów. Co gorsza, złącze to musi zachować nienaganną stabilność mechaniczną w całym zakresie temperatur pracy układu, od zera do stu stopni Celsjusza. Różnice we współczynnikach rozszerzalności cieplnej (CTE) pomiędzy krzemem, szkłem światłowodowym a spoiwem polimerowym wywoływały naprężenia mechaniczne prowadzące do mikro-przesunięć i utraty sygnału.
Przełomem w tej dziedzinie stały się zautomatyzowane złącza z soczewkami rozszerzającymi wiązkę (expanded beam connectors) oraz technologia montażu pasywnego z wykorzystaniem precyzyjnie trawionych rowków V (V-grooves) w krzemie. Dzięki rozszerzeniu średnicy wiązki świetlnej na złączu do kilkudziesięciu mikrometrów tolerancja montażowa wzrasta wielokrotnie, a złącze staje się niewrażliwe na mikroskopijne zanieczyszczenia pyłowe, co umożliwiło zautomatyzowany, masowy montaż światłowodów w standardowych liniach montażowych bez udziału precyzyjnych manipulatorów piezoelektrycznych.
Ostatnim elementem układanki była serwisowalność w szafie serwerowej. Tradycyjne kable światłowodowe są delikatne i podatne na uszkodzenia mechaniczne przy zginaniu z promieniem poniżej kilkunastu milimetrów. Wprowadzenie włókien światłowodowych odpornych na zginanie (bend-insensitive fibers) w połączeniu z rozłączalnymi konektorami wielowłóknowymi MPO i PRIZM MT pozwoliło na stworzenie modułowej infrastruktury okablowania, w której wymiana uszkodzonej wstęgi światłowodowej wewnątrz gęsto upakowanej szafy serwerowej nie różni się procedurą od wymiany standardowego kabla miedzianego.
Geopolityczna mapa fotoniki: Od fabryk TSMC po suwerenne łańcuchy dostaw
Fotonika krzemowa przestała być jedynie zagadnieniem czysto technicznym i stała się kluczowym elementem globalnej rywalizacji geopolitycznej o dominację technologiczną. W miarę jak klasyczne skalowanie litograficzne w oparciu o prawo Moore'a zwalnia, a koszty budowy fabryk produkujących chipy w węzłach poniżej 2 nanometrów przekraczają dwadzieścia miliardów dolarów, integracja fotoniki z elektroniką staje się głównym wektorem zwiększania wydajności systemów obliczeniowych bez konieczności kosztownego zmniejszania wymiarów tranzystorów.
Tajwański gigant TSMC uznał fotonikę krzemową za swój najwyższy priorytet strategiczny, tworząc platformę COUPE (Compact Universal Photonic Engine). Łączy ona silniki optyczne z układami elektronicznymi za pomocą zaawansowanego układania 3D typu wafer-to-wafer z mikroskopijnymi miedzianymi punktami kontaktowymi, oferując najniższą impedancję i najwyższą gęstość upakowania na świecie. Z kolei w Stanach Zjednoczonych GlobalFoundries rozwija dedykowaną platformę Fotonix w fabryce w stanie Nowy Jork, współpracując z czołowymi amerykańskimi projektantami procesorów i agencjami federalnymi w celu zabezpieczenia krajowego łańcucha dostaw dla zastosowań militarnych i wywiadowczych.
Europa, posiadając potężne instytuty badawcze takie jak CEA-Leti we Francji, IMEC w Belgii oraz Fraunhofer w Niemczech, stara się utrzymać suwerenność technologiczną w dziedzinie fotoniki zintegrowanej. Europejski Akt o Czipach (European Chips Act) przewiduje wielomiliardowe subsydia na budowę pilotażowych linii produkcyjnych fotoniki, identyfikując tę technologię jako szansę na ominięcie dominacji azjatyckich odlewni w najbardziej zaawansowanych procesach czysto logicznych.
Równolegle Chiny, odcięte przez amerykańskie sankcje technologiczne od najnowocześniejszych maszyn litografii skrajnego ultrafioletu (EUV) firmy ASML, rzuciły gigantyczne zasoby państwowe na rozwój fotoniki krzemowej jako asymetrycznej odpowiedzi na zachodnie embargo. Ośrodki w Wuhanie i Szanghaju poczyniły spektakularne postępy w zintegrowanych laserach hybrydowych i modulatorach krzemowych, dążąc do zniwelowania luki w mocy obliczeniowej procesorów AI poprzez optyczne łączenie większej liczby chipów produkowanych w starszych, dojrzałych węzłach litograficznych. Wszystko to dowodzi, że fotonika krzemowa i Co-Packaged Optics to technologia o znaczeniu fundamentalnym dla cywilizacji informacyjnej – to ona wyznaczy granice możliwości sztucznej inteligencji na nadchodzące dekady.
Nieodłącznym elementem tej rywalizacji technologicznej jest również standaryzacja protokołów komunikacji na poziomie chipletów. Konsorcjum UCIe (Universal Chiplet Interconnect Express) intensywnie rozwija specyfikację optycznego UCIe, która ma zdefiniować uniwersalny interfejs fizyczny i logiczny pomiędzy układami obliczeniowymi a silnikami fotonicznymi różnych producentów. Równolegle obozy skupione wokół otwartego konsorcjum Ultra Accelerator Link (UALink) oraz zamkniętego ekosystemu Nvidia NVLink pracują nad własnymi, dedykowanymi magistralami optycznymi zoptymalizowanymi pod kątem minimalizacji narzutu pamięciowego w operacjach zbiorowych. Standaryzacja ta zadecyduje o tym, czy przyszłe superkomputery będą budowane jako otwarte, modułowe ekosystemy chipletowe, czy też powstaną zmonopolizowane, wertykalnie zintegrowane silosy technologiczne największych korporacji chmurowych.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.