
Architektura pamięci CXL i rewolucja HBM4: Jak magistrale 2048-bitowe, pooling pamięci Compute Express Link i zaawansowane łączenie 3D przełamują ścianę pamięci w akceleratorach sztucznej inteligencji
Kryzys ściany pamięci w erze wielkich modeli językowych
Współczesna rewolucja sztucznej inteligencji doprowadziła do bezprecedensowego przewartościowania wąskich gardeł w architekturze systemów komputerowych. Przez ostatnie cztery dekady rozwój mikroelektroniki napędzany był prawem Moore'a, które koncentrowało się na miniaturyzacji tranzystorów i zwiększaniu gęstości upakowania jednostek logicznych. W efekcie szczytowa moc obliczeniowa akceleratorów mierzona w teraflopsach i petaflopsach operacji zmiennoprzecinkowych rosła w oszałamiającym tempie, podwajając się niemal co osiemnaście miesięcy. Jednakże tempo rozwoju podsystemów pamięci operacyjnej DRAM nie dotrzymywało kroku tej dynamice, generując zjawisko określane przez architektów komputerowych mianem ściany pamięci.
Problem ten stał się szczególnie dotkliwy wraz z nadejściem modeli generatywnych i architektur opartych na mechanizmie atencji (Transformer). W zadaniach inferencji oraz trenowania sieci liczących setki miliardów parametrów, rdzenie obliczeniowe GPU przez znaczną część cykli zegarowych pozostają w stanie bezczynności, oczekując na dostarczenie wag neuronowych i wektorów kontekstu z pamięci DRAM. Wskaźnik intensywności arytmetycznej, definiujący stosunek liczby wykonanych operacji matematycznych do każdego bajta danych przetransferowanego z pamięci, drastycznie spada. Zamiast ograniczeń wynikających z surowej mocy obliczeniowej jednostek ALU czy rdzeni Tensor, o wydajności całego superkomputera decyduje wyłącznie przepustowość magistrali pamięciowej (Memory Bandwidth) oraz opóźnienia dostępu (Latency).
Tradycyjne pamięci operacyjne DDR5 oraz graficzne GDDR6/7, mimo imponującego wzrostu taktowania magistrali, napotkały fundamentalne bariery fizyczne. Prowadzenie setek miedzianych ścieżek sygnałowych o wysokiej częstotliwości przez laminat płyty głównej (PCB) generuje kolosalne straty dielektryczne, przesłuchy elektromagnetyczne (crosstalk) oraz nieakceptowalne zużycie energii na poziomie kilkunastu pikodżuli na przesłany bit. Przesłanie gigabajtów danych na odległość kilkunastu centymetrów pochłania więcej mocy niż same operacje logiczne na krzemie. Jedyną drogą wyjścia z tego impasu stało się fizyczne zbliżenie stosów pamięci do rdzenia obliczeniowego oraz wdrożenie magistral o bezprecedensowej szerokości szyny danych.
Ewolucja HBM i przełom 2048-bitowej szyny w standardzie HBM4
Technologia pamięci o wysokiej przepustowości (High Bandwidth Memory, HBM) zrewolucjonizowała segment akceleratorów obliczeniowych, wprowadzając pionowe stosy pamięci DRAM montowane tuż obok procesora graficznego na wspólnym podłożu krzemowym (Silicon Interposer). Od pierwszej generacji HBM aż po standardy HBM2E, HBM3 i najnowszy HBM3E, fundamentem architektury pozostawał 1024-bitowy interfejs pamięci przypadający na każdy stos kości (Stack). Wzrost przepustowości z poziomu stu dwudziestu ośmiu gigabajtów na sekundę w pierwotnym standardzie do ponad jednego terabajta na sekundę na stos w HBM3E osiągano przede wszystkim poprzez podnoszenie częstotliwości transferu pinów, która przekroczyła dziewięć gigabitów na sekundę.
Wraz z nadejściem standardu HBM4 inżynierowie zrzeszeni w konsorcjum JEDEC podjęli najbardziej radykalną decyzję architektoniczną w historii technologii: podwojenie szerokości magistrali danych z 1024 do 2048 bitów na stos. Jest to zmiana o fundamentalnym znaczeniu fizycznym. Zwiększenie liczby linii sygnałowych pozwala na drastyczne obniżenie wymaganej częstotliwości taktowania przy jednoczesnym osiągnięciu przepustowości przekraczającej dwa terabajty na sekundę na pojedynczy stos HBM4. Niższa częstotliwość pracy pinów oznacza mniejszy poziom szumów elektromagnetycznych oraz radykalną redukcję zużycia energii na bit transferu, co jest kluczowe dla akceleratorów AI, których całkowity budżet energetyczny (TDP) sięga już tysiąca watów.
Podwojenie szerokości szyny do 2048 bitów wymusza jednak całkowite przedefiniowanie gęstości połączeń mechanicznych. Każdy stos HBM4 wymaga wyprowadzenia tysięcy miniaturowych punktów styku (Microbumps) o skoku zmniejszonym z dotychczasowych trzydziestu pięciu mikrometrów do wartości poniżej dwudziestu mikrometrów. Oznacza to, że tradycyjne technologie lutowania rozpływowego osiągają swoje limity tolerancji termomechanicznej, otwierając drzwi dla bezspoinowego łączenia metali na poziomie atomowym.
Zaawansowane łączenie 3D i hybrydowy bonding miedź-miedź
Kluczowym elementem technologii HBM jest pionowe łączenie warstw krzemu za pomocą przelotek przezsubstratowych (Through-Silicon Vias, TSV). W typowym stosie HBM4 znajduje się od dwunastu do szesnastu cienkich warstw matryc DRAM (każda pocieniona mechanicznie i chemicznie do grubości zaledwie kilkunastu mikrometrów), ułożonych jedna na drugiej i połączonych pionowymi kolumnami miedzi przechodzącymi przez całą grubość płytki krzemowej. W dotychczasowych generacjach warstwy łączono za pomocą mikro-kulek lutowniczych (Microbumps) ze stopu cyny i miedzi w technologii Thermo-Compression Bonding (TCB).
W standardzie HBM4 coraz powszechniej stosuje się technologię bezpośredniego bondingu hybrydowego miedź-miedź (Direct Cu-Cu Hybrid Bonding), znaną komercyjnie między innymi jako TSMC SoIC (System on Integrated Chips). Proces ten polega na precyzyjnym polerowaniu chemiczno-mechanicznym (CMP) powierzchni płytek krzemowych, tak aby elektrody miedziane były idealnie zrównane z otaczającą je warstwą dielektryka tlenkowego. Następnie dwie płytki są dociskane w temperaturze pokojowej, gdzie dochodzi do molekularnego związania tlenków, po czym następuje wyżarzanie w podwyższonej temperaturze, podczas którego atomy miedzi dyfundują przez granicę złączy, tworząc jednolite, bezspoinowe połączenie metaliczne.
Zastosowanie hybrydowego bondingu Cu-Cu eliminuje konieczność stosowania spoiwa lutowniczego i żywic podlewających (Underfill), co pozwala na zmniejszenie odległości pomiędzy sąsiadującymi matrycami DRAM do zaledwie kilku mikrometrów. Rezultatem jest stukrotne zwiększenie gęstości połączeń TSV na milimetr kwadratowy, drastyczne obniżenie rezystancji i pojemności pasożytniczej złącza oraz radykalna poprawa przewodności cieplnej całego stosu. Efektywne odprowadzanie ciepła z dolnych warstw pamięci jest warunkiem koniecznym do zapobiegania zjawisku degradacji retencji ładunku w komórkach pojemnościowych DRAM pracujących w sąsiedztwie rozgrzanego do granic możliwości akceleratora obliczeniowego.
Podstawowa matryca Base Die w zaawansowanych węzłach logicznych
Kolejną przełomową innowacją wprowadzoną w standardzie HBM4 jest fundamentalna zmiana natury dolnej matrycy bazowej (Base Die / Buffer Die). We wszystkich wcześniejszych generacjach HBM matryca bazowa była produkowana w tradycyjnych, dojrzałych węzłach litograficznych technologii DRAM (na przykład 20 nm lub 14 nm) przez samego producenta pamięci (SK Hynix, Samsung czy Micron). Jej rola ograniczała się do prostego trasowania sygnałów z przelotek TSV oraz realizacji podstawowych funkcji testowych (BIST) i redundantnej alokacji uszkodzonych komórek.
W architekturze HBM4 matryca bazowa przekształca się w zaawansowany układ logiczny produkowany przez dedykowane odlewnie półprzewodników (Foundries), takie jak TSMC czy Intel Foundry Services, w najnowocześniejszych węzłach litograficznych FinFET i GAA (5 nm, 4 nm, a docelowo 3 nm). Oznacza to bezprecedensowy sojusz producentów pamięci z liderami litografii logicznej. Wbudowanie zaawansowanej logiki bezpośrednio w podstawę stosu HBM pozwala na implementację wyrafinowanych kontrolerów pamięci, sprzętowych układów korekcji błędów (Advanced On-Die ECC), a także mechanizmów przetwarzania w pamięci (Processing-In-Memory, PIM) lub Near-Memory Computing.
Dzięki umieszczeniu dedykowanych bloków arytmetycznych w matrycy bazowej HBM4, część elementarnych operacji algebry liniowej, takich jak mnożenie macierzy przez wektor (GEMV) czy operacje redukcji w algorytmach optymalizacyjnych, może być wykonywana bezpośrednio wewnątrz podsystemu pamięci, bez konieczności przesyłania terabajtów danych przez interposer do głównego procesora graficznego. Pozwala to na ominięcie wąskiego gardła transferu zewnętrznego, redukuje opóźnienia do nanosekund i drastycznie obniża całkowite zużycie energii w wielkoskalowych klastrach obliczeniowych AI.
Protokół Compute Express Link CXL i mechanizmy spójności pamięci
Podczas gdy technologia HBM4 rozwiązuje problem lokalnej przepustowości dla pojedynczego akceleratora AI, nie odpowiada ona na wyzwanie skalowalności pojemnościowej. Pamięć HBM ze względu na skomplikowany proces produkcji, ograniczenia powierzchni interposera oraz wysoki koszt jednostkowy charakteryzuje się relatywnie niewielką pojemnością (od kilkudziesięciu do maksymalnie kilkuset gigabajtów na akcelerator). Tymczasem najnowocześniejsze modele bazowe, takie jak GPT-4 czy Llama-3 o setkach miliardów wag, wymagają terabajtów pamięci szybkiego dostępu do przechowywania buforów kluczy i wartości w mechanizmie atencji (KV Cache) dla tysięcy równoległych sesji użytkowników.
Odpowiedzią na ten dylemat jest otwarty standard Compute Express Link (CXL), bazujący na fizycznej warstwie magistrali PCI Express (PCIe Gen5 i Gen6). Protokół CXL wprowadza trzy fundamentalne podprotokoły operacyjne: CXL.io (odpowiadający klasycznej komunikacji wejścia-wyjścia PCIe), CXL.cache (umożliwiający urządzeniom zewnętrznym spójny dostęp do pamięci podręcznej procesora głównego) oraz CXL.mem (pozwalający procesorom i akceleratorom na traktowanie zewnętrznych modułów jako bezpośredniej, spójnej pamięci operacyjnej o niskim opóźnieniu). Kluczową innowacją CXL jest sprzętowo wymuszana spójność pamięci podręcznej (Cache Coherency), która eliminuje konieczność programowego synchronizowania danych przez system operacyjny.
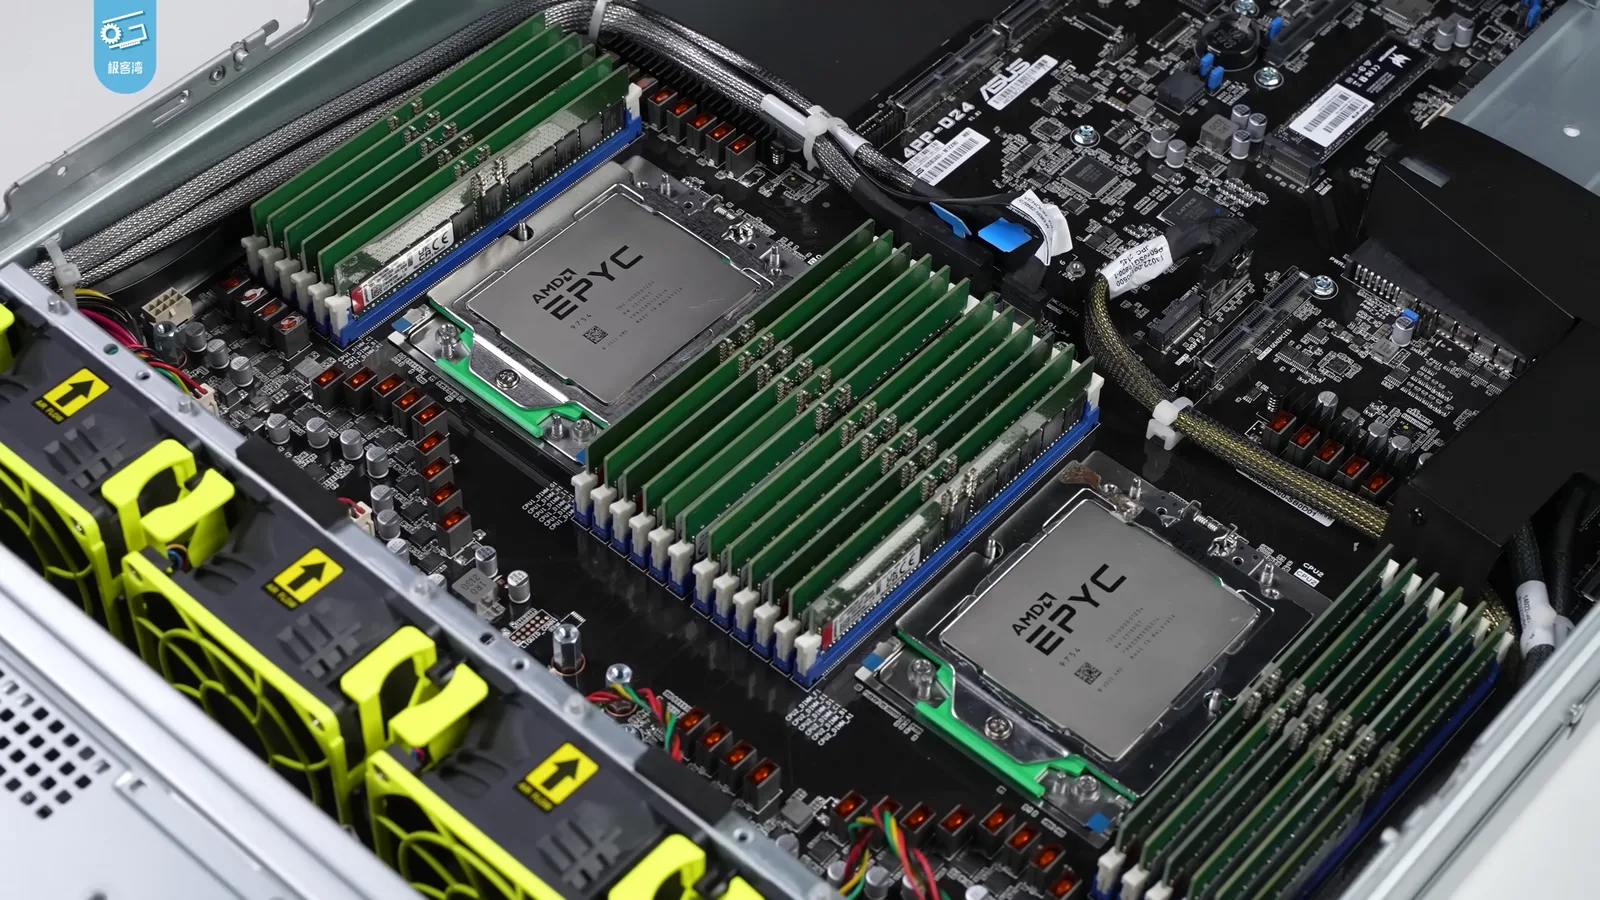
Dzięki protokołowi CXL.mem serwery obliczeniowe zyskują możliwość dołączania zewnętrznych ekspanderów pamięci CXL DRAM montowanych w slotach PCIe lub dedykowanych kasetach EDSFF E3.S. Moduły te oferują opóźnienia dostępu na poziomie zaledwie kilkudziesięciu nanosekund powyżej bezpośredniego dostępu do lokalnych szyn DDR5, dostarczając jednocześnie wieloterabajtowe pule pamięci operacyjnej bez konieczności rozbudowy kosztownych gniazd procesorowych CPU. Pozwala to na stworzenie hierarchicznej architektury pamięci, w której HBM4 pełni rolę superszybkiej warstwy zerowej (Tier 0), lokalne kości DDR5 stanowią warstwę pierwszą (Tier 1), a pamięć CXL DRAM tworzy rozległą, skalowalną warstwę drugą (Tier 2).
Pooling pamięci CXL i eliminacja problemu Stranded Memory w chmurze
Jednym z najpoważniejszych problemów ekonomicznych współczesnych centrów danych i dostawców chmurowych (Hyperscalers) jest zjawisko tak zwanej osieroconej pamięci (Stranded Memory). W tradycyjnej infrastrukturze serwerowej każdy węzeł obliczeniowy posiada ściśle określoną, sztywną ilość pamięci RAM przypisanej do konkretnych gniazd procesora. Jeżeli uruchomiona maszyna wirtualna lub zadanie treningowe AI w pełni utylizuje rdzenie obliczeniowe procesora, zużywając jedynie połowę dostępnej pamięci RAM, pozostała część pamięci w tym węźle staje się bezużyteczna i nie może zostać przydzielona innemu serwerowi. Szacunki branżowe wskazują, że w globalnych chmurach obliczeniowych nawet dwadzieścia pięć procent zainstalowanej pamięci operacyjnej pozostaje bezczynne w postaci osieroconej, generując gigantyczne straty kapitałowe.
Wprowadzenie standardów CXL 2.0 i CXL 3.0 przynosi rewolucyjne rozwiązanie w postaci technologii Memory Pooling (współdzielenia i łączenia pamięci w pule). Dzięki zastosowaniu wyspecjalizowanych przełączników CXL (CXL Switches), setki gigabajtów lub terabajtów pamięci RAM mogą zostać umieszczone w dedykowanych szufladach serwerowych (Memory Appliances) całkowicie odseparowanych od procesorów. Przełącznik CXL potrafi w locie, w sposób dynamiczny i bezrestartowy, alokować określone bloki adresowe pamięci do konkretnych węzłów obliczeniowych w zależności od ich bieżącego obciążenia roboczego.
Standard CXL 3.0 idzie jeszcze dalej, wprowadzając zaawansowane topologie wielopoziomowe (Fabric Attached Memory), routing oparty na przełącznikach Spine-Leaf oraz możliwość jednoczesnego współdzielenia tego samego bloku pamięci przez wiele niezależnych węzłów obliczeniowych (Multi-Host Memory Sharing). W kontekście klastrów sztucznej inteligencji oznacza to, że cała pamięć podręczna KV Cache lub wagi modelu mogą rezydować w pojedynczej, spójnej puli pamięci CXL, do której bezpośredni dostęp mają dziesiątki akceleratorów graficznych połączonych przez magistralę CXL Fabric. Eliminuje to konieczność wielokrotnego duplikowania danych w pamięci każdego GPU z osobna, drastycznie redukując całkowity koszt posiadania (TCO) infrastruktury sztucznej inteligencji.
Wyzwania termomechaniczne: Naprężenia strukturalne i wypaczanie podłoży
Jednym z najbardziej krytycznych, a jednocześnie często pomijanych aspektów wdrażania standardu HBM4 i zaawansowanego pakowania 3D są zjawiska termomechaniczne zachodzące wewnątrz modułu wieloukładowego (Multi-Chip Module). Połączenie na jednym krzemowym lub szklanym podłożu interposera potężnego procesora graficznego o powierzchni sięgającej limitu maski fotolitograficznej (Reticle Limit) z kilkoma pionowymi stosami pamięci DRAM rodzi potężne naprężenia wewnętrzne wynikające z niedopasowania współczynników rozszerzalności cieplnej (Coefficient of Thermal Expansion, CTE).
Krzem, miedź, materiały dielektryczne, polimery podlewające oraz organiczny laminat podłoża BGA rozszerzają się i kurczą w różnym tempie w odpowiedzi na gwałtowne zmiany temperatury pracy akceleratora. Podczas cykli rozgrzewania pod pełnym obciążeniem obliczeniowym i stygnięcia w stanie spoczynku, cały moduł ulega mikroskopijnemu wyginaniu (Warpage). W przypadku mikrokulek lutowniczych o skoku poniżej dwudziestu mikrometrów lub bezpośrednich złączy miedź-miedź, naprężenia ścinające mogą prowadzić do mikropęknięć zmęczeniowych, utraty ciągłości galwanicznej i w konsekwencji trwałej awarii akceleratora wartego dziesiątki tysięcy dolarów.
Aby zapobiec degradacji strukturalnej, inżynierowie wprowadzają zaawansowane podłoża szklane (Glass Substrates) charakteryzujące się wyjątkową stabilnością wymiarową, idealną gładkością powierzchni oraz współczynnikiem CTE doskonale dopasowanym do krzemu. Ponadto w strukturach stosów HBM4 projektuje się specjalne strefy kompensacji naprężeń termicznych oraz atrapy przelotek (Dummy TSVs), których jedynym zadaniem jest równomierne odprowadzanie ciepła i mechaniczne stabilizowanie delikatnych warstw krzemowych w ekstremalnych warunkach termicznych klastrów sztucznej inteligencji.
Rynek i geopolityka pamięci: Trójstronny wyścig o prymat w epoce AI
Transformacja architektury pamięci ma również kolosalne implikacje geopolityczne i biznesowe. Globalny rynek pamięci o wysokiej przepustowości HBM stał się najbardziej dochodowym segmentem branży półprzewodnikowej, generując marże operacyjne nieosiągalne dotąd dla producentów tradycyjnych kości DRAM. Niekwestionowanym liderem tego wyścigu w generacjach HBM3 i HBM3E okazał się południowokoreański koncern SK Hynix, który dzięki wczesnemu wdrożeniu technologii formowania pod ciśnieniem cieczy (Mass Reflow Molded Underfill, MR-MUF) zdominował łańcuch dostaw dla czołowych akceleratorów graficznych Nvidia.
W odpowiedzi na dominację rywala, technologiczny gigant Samsung Electronics zainwestował miliardy dolarów w rozwój zaawansowanych procesów Advanced-TCB oraz hybrydowego bondingu, dążąc do zaoferowania kompleksowej usługi pod jednym dachem (One-Stop Shop), łączącej produkcję matryc DRAM, odlewnię zaawansowanej logiki oraz pakowanie 3D. Z kolei amerykański Micron Technology, mimo opóźnionego startu w pierwszych fazach rozwoju HBM, zdołał przeskoczyć całą generację i zaoferować wysoce konkurencyjne kości HBM3E o obniżonym poborze mocy, stając się kluczowym partnerem amerykańskich programów wzmacniania suwerenności technologicznej.
Kluczowym elementem tej układanki pozostaje jednak tajwański potentat TSMC. Ponieważ matryce bazowe HBM4 wymagają zaawansowanych węzłów logicznych FinFET i GAA, tradycyjny model biznesowy producentów pamięci musiał ulec dekompozycji. Wszyscy trzej główni wytwórcy DRAM nawiązali ścisłe partnerstwa z TSMC w celu integracji swoich stosów pamięci z tajwańskimi liniami zaawansowanego pakowania CoWoS. Sprawia to, że Cieśnina Tajwańska staje się jeszcze bardziej newralgicznym punktem na mapie światowego bezpieczeństwa cyfrowego, od którego zależy ciągłość dostaw pamięci nowej generacji dla całej globalnej gospodarki opartej na sztucznej inteligencji.
Optyczne interkonekty CXL i rewolucja Silicon Photonics
Wraz ze wzrostem przepustowości magistral PCIe i CXL tradycyjne połączenia miedziane napotykają na ostateczną granicę zasięgu. Przy prędkościach transferu na poziomie sześćdziesięciu czterech gigatransferów na sekundę (GT/s) w standardzie PCIe Gen6 z modulacją czteropoziomową PAM4, sygnał elektryczny ulega tak silnej atenuacji w miedzianych ścieżkach, że efektywny zasięg niezawodnego transferu na standardowym laminacie serwerowym kurczy się do zaledwie kilkunastu centymetrów. Prowadzenie kabli miedzianych pomiędzy szafami serwerowymi staje się niemożliwe bez stosowania kosztownych i prądożernych re-timerów sygnałowych.
Rozwiązaniem tego problemu staje się integracja protokołu CXL z technologią fotoniki krzemowej (Silicon Photonics) oraz optyką współpakowaną (Co-Packaged Optics, CPO). Zamiast zamieniać sygnały logiczne na impulsy elektryczne wędrujące po miedzi, zintegrowane lasery DFB i mikroskopijne modulatory Mach-Zehndera wytrawione bezpośrednio w strukturze krzemu przekształcają strumienie bitów w modulowane wiązki światła laserowego wnikające w elastyczne włókna światłowodowe.
Zastosowanie optycznych łączy CXL pozwala na rozciągnięcie spójnej magistrali pamięciowej na odległość kilkudziesięciu, a nawet kilkuset metrów w obrębie całej hali centrum danych. Opóźnienia propagacji światła w szkle kwarcowym są minimalne, a tłumienie optyczne jest o rzędy wielkości mniejsze niż straty w miedzi. Otwiera to drogę do budowy prawdziwie modularnych mega-centrów danych, w których tysiące akceleratorów AI zlokalizowanych w dziesiątkach oddzielnych szaf komunikuje się z centralną, gigantyczną pulą pamięci CXL Optical Pool z prędkościami i spójnością dotychczas zarezerwowanymi wyłącznie dla pojedynczej płyty głównej.
Integracja systemowa: Hybrydowa hierarchia pamięci przyszłości
Architektura systemów obliczeniowych przyszłości nie będzie opierać się na rywalizacji pomiędzy standardami HBM4 a CXL, lecz na ich głębokiej, symbiotycznej integracji. Superkomputery nowej generacji przeznaczone do trenowania i inferencji modeli frontier AI konstruowane są w układzie wielopoziomowym, w którym każdy szczebel hierarchii optymalizowany jest pod kątem innego kryterium fizycznego i ekonomicznego.
Na poziomie samego akceleratora krzemowego dominuje HBM4, połączone z procesorem za pośrednictwem zaawansowanych interposerów w technologiach CoWoS (Chip-on-Wafer-on-Substrate) lub Intel EMIB (Embedded Multi-die Interconnect Bridge). Ta warstwa zapewnia ekstremalną przepustowość rzędu kilkunastu terabajtów na sekundę, niezbędną do wykonywania operacji atencji i aktualizacji gradientów w rdzeniach obliczeniowych. Bezpośrednio za nią znajduje się warstwa pamięci systemowej DDR5 oraz modułów CXL.mem, połączonych szybkimi łączami PCIe Gen6 z kodowaniem PAM4, gwarantującymi płynne uzupełnianie danych w pamięci podręcznej i buforowanie stanów pośrednich.
Na szczycie tej piramidy znajduje się rozproszona sieć CXL Fabric obejmująca całe szafy serwerowe (Rack-Scale Architecture). Dzięki optycznym interkonektom CXL, które zastępują miedziane kable na dystansach powyżej kilku metrów, opóźnienia transferu pomiędzy węzłami szafy serwerowej zbliżają się do opóźnień wewnętrznych magistral krzemowych. W ten sposób setki węzłów GPU zyskują iluzję pracy na jednolitej, gigantycznej przestrzeni adresowej liczącej setki terabajtów pamięci, co umożliwia bezproblemowe skalowanie modeli językowych do bilionów parametrów bez konieczności wprowadzania skomplikowanych i nieefektywnych programowych podziałów tensorowych.
Podsumowanie: Przełamanie barier fizyki dla rozwoju sztucznej inteligencji
Przejście na standard HBM4 oraz powszechna adaptacja magistrali Compute Express Link stanowią najważniejszy zwrot w architekturze sprzętowej od czasu wprowadzenia standardu PCI Express ponad dwie dekady temu. Przełamanie ściany pamięci nie jest jedynie technicznym usprawnieniem kilku parametrów katalogowych; to fundamentalna zmiana paradygmatu, która decyduje o tym, czy rozwój sztucznej inteligencji utrzyma swoje dotychczasowe, wykładnicze tempo.
Dzięki 2048-bitowej szynie danych w HBM4, bezpośredniemu bondingowi miedź-miedź na poziomie atomowym oraz elastycznemu poolingowi pamięci w architekturze CXL 3.0, inżynierowie zdołali odsunąć widmo fizycznego zastoju w mikroelektronice. Nowe technologie pamięciowe stwarzają solidny, skalowalny fundament pod kolejną generację akceleratorów obliczeniowych, które będą w stanie przetwarzać najbardziej złożone modele świata, umożliwiając skokowy rozwój systemów autonomicznych, zaawansowanej robotyki i generalnej inteligencji maszynowej.
Czytaj również w dziale Technologia

Architektury tranzystorów GAAFET nanosheet poniżej 2 nanometrów: Jak zasilanie od spodu Backside Power Delivery BSPDN i litografia High-NA EUV pokonują fizyczną barierę tunelowania kwantowego

Radary kwantowe i interferometria ze splątaniem kwantowym: Jak oświetlenie kwantowe QI i mikrofale ściskane przełamują technologię niewidzialności Stealth samolotów piątej i szóstej generacji

Komentarze czytelników
3Dołącz do dyskusji pod artykułem
Zaloguj się, aby dodać komentarz i podzielić się swoją opinią na temat tego artykułu.